

Преди няколко години Kubernetes в официалния блог на GitHub. Оттогава той стана стандартна технология за разгръщане на услуги. Сега Kubernetes управлява значителна част от вътрешните и публични услуги. С нарастващите размери на нашите клъстери и по-строгите изисквания за производителност, започнахме да забелязваме, че в някои услуги на Kubernetes спорадично се появяват забавяния, които не могат да бъдат обяснени с натоварването на самото приложение.
В същност, в приложенията се получава нещо като случайно мрежово забавяне до 100 мс и повече, което води до таймаути или повторни опити. Очакваше се услугите да могат да отговарят на запитвания много по-бързо от 100 мс. Но това е невъзможно, ако самото свързване отнема толкова време. Поотделно наблюдавахме много бързи запитвания към MySQL, които трябваше да отнемат милисекунди, и MySQL наистина се справяше за милисекунди, но от гледна точка на запитващото приложение отговорът отнемаше 100 мс или повече.
Скоро стана ясно, че проблемът възниква само при свързване с възел на Kubernetes, дори ако извикването идваше извън Kubernetes. Най-лесно е да се възпроизведе проблемът в тест , който се стартира от всеки вътрешен хост, тества услугата Kubernetes на определен порт и спорадично регистрира голямо забавяне. В тази статия ще разгледаме как успяхме да проследим причината за този проблем.
Премахваме излишната сложност в веригата до неуспеха
Възпроизвеждайки един и същ пример, искахме да стесним фокуса на проблема и да премахнем излишните слоеве на сложност. Първоначално в потока между Vegeta и pod-овете на Kubernetes имаше твърде много елементи. За да определим по-дълбок мрежови проблем, трябваше да изключим някои от тях.
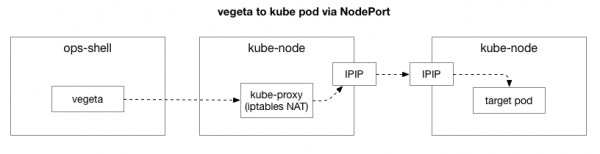
Клиентът (Vegeta) създава TCP свързване с всеки възел в клъстера. Kubernetes работи като.overlay мрежа (върху съществуващата мрежа на датацентъра), която използва , т.е. инкапсулира IP пакети на.overlay мрежа вътре в IP пакети на датацентъра. При свързване със първия възел се извършва преобразуване на мрежови адреси (NAT) с проследяване на състоянието за преобразуване на IP адреса и порта на Kubernetes хост в IP адрес и порт в оверлейна мрежа (в частност, pod с приложение). За входящите пакети се изпълнява обратната последователност. Това е сложна система с много състояния и множество елементи, които постоянно се обновяват и променят с разгръщането и переместенето на услугите.
Утилита tcpdump в теста Vegeta дава забавяне по време на TCP хендишека (между SYN и SYN-ACK). За да се избегне тази излишна сложност, може да се използва hping3 за простички „пингове“ с SYN пакети. Проверяваме дали има забавяне в отговорния пакет и след това нулираме връзката. Можем да филтрираме данните, като включим само пакети над 100 мс, и да получим по-прост вариант за възпроизвеждане на проблема, отколкото пълен тест на мрежово ниво 7 в Vegeta. Ето „пингове“ на Kubernetes хост, използвайки TCP SYN/SYN-ACK на „порта на хоста“ на услугата (30927) с интервал от 10 мс, филтрирани по най-бавните отговори:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Може веднага да се направи първото наблюдение. По последователните номера и времето е видно, че не става дума за еднократни задръствания. Забавянето често се натрупва и в крайна сметка се обработва.
Следващата стъпка е да разберем кои компоненти могат да бъдат замесени в появата на задръстването. Може би това са някои от стотиците правила на iptables в NAT? Или някакви проблеми с тунелирането IPIP в мрежата? Един от начините да проверим това е да проверим всяка стъпка от системата, изключвайки я. Какво ще се случи, ако премахнем NAT и логиката на защитната стена, оставяйки само частта IPIP:
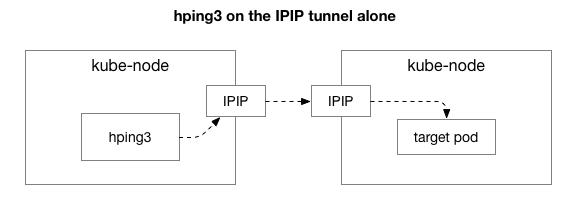
За щастие, Linux позволява лесен достъп до оверлейния слой IP, ако машината е в същата мрежа:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Съдейки по резултатите, проблемата все още остава! Това изключва iptables и NAT. Следователно, проблемът е в TCP? Нека да видим как върви обикновеният ICMP пинг:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Резултатите показват, че проблемът не е изчезнал. Може би е IPIP тунел? Нека да опростим теста:
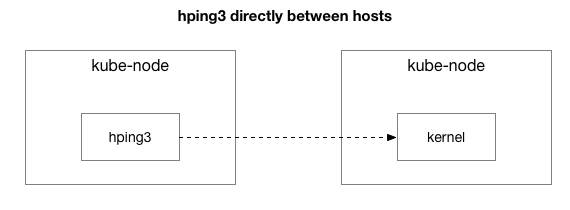
Всички пакети ли се изпращат между тези два хоста?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Упроштихме ситуацията до два узла Kubernetes, изпращащи пакети помежду си, дори ICMP пинг. Те все пак виждат забавяне, ако целевият хост е "лош" (някои са по-лоши от други).
Сега последният въпрос: защо забавянето се проявява само на сървърите kube-node? И той възниква, когато kube-node е изпращач или получател? За щастие, това също е доста лесно да се изясни, като изпратите пакет от хост извън Kubernetes с същия "известен лош" получател. Както виждаме, проблемът не е изчезнал:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
След това ще изпълним същите запитвания от предишния източник kube-node към външния хост (което изключва изходния хост, тъй като пинг включва и RX, и TX компонент):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping статистика ---
 22352 пакета предадени, 22350 пакета получени, 1% загуба на пакети
 време за предаване на пакети мин/средно/макс = 0.2/7.6/1010.6 ms
След като проучихме захващането на пакети с латентност, получихме допълнителна информация. В частност, изпращачът (вдясно) вижда този таймаут, а получателят (вляво) не го вижда — вижте колоната Delta (в секунди):
Освен това, ако разгледате разликата в реда на пакетите TCP и ICMP (по редовите номера) от страната на получателя, пакетите ICMP винаги пристигат в същата последователност, в която са били изпратени, но с различно таймерност. В същото време, пакетите TCP понякога се редуват, а част от тях засядат. В частност, ако разгледаме портовете на пакетите SYN, то от страната на изпращача те са в ред, а от страната на получателя - не.
Има тънка разлика в това как на съвременните сървъри (както в нашия дата център) обработват пакети, съдържащи TCP или ICMP. Когато пристигне пакет, мрежовият адаптер „хешира го по връзката“, тоест се опитва да раздели връзките по опашки и да изпрати всяка опашка на отделно процесорно ядро. За TCP този хеш включва както изходния, така и крайния IP адрес и порт. С други думи, всяка връзка се хешира (потенциално) по различен начин. За ICMP се хешират само IP адресите, тъй като портове няма.
Друго ново наблюдение: през този период наблюдаваме ICMP латентности при всички комуникации между два хоста, а при TCP няма. Това ни дава основание да смятаме, че причината вероятно е свързана с хеширането на RX опашките: почти сигурно, че задръстването възниква в обработката на RX пакети, а не в изпращането на отговори.
Това изключва изпращането на пакети от списъка с възможните причини. Сега знаем, че проблемът с обработката на пакети е от страната на получаването на някои сървъри kube-node.
Разглеждаме как обработката на пакети в ядрото на Linux
За да разберем защо проблемът възниква при получателя на някои сървъри kube-node, нека разгледаме как ядрото на Linux обработва пакетите.
Връщайки се към най-простата традиционна реализация, мрежовата карта получава пакет и изпраща към ядрото на Linux, че има пакет, който трябва да бъде обработен. Ядрото спира друга работа, превключва контекста на обработвача на прекъсвания, обработва пакета, а след това се връща към текущите задачи.
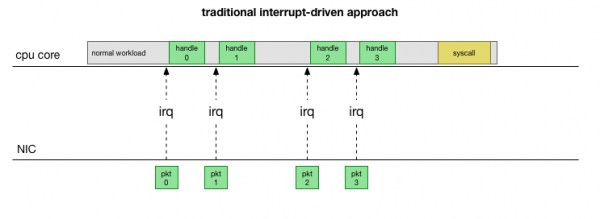
Тази смяна на контекста става бавно: вероятно, забавянето е било незабележимо на 10-гигабитни мрежови карти през 90-те години, но на съвременните 10G карти с максимална честотна лента от 15 милиона пакета в секунда, всяко ядро на малък осемядрен сървър може да прекъсва милиони пъти в секунда.
За да не се налага постоянно обработване на прекъсвания, преди много години в Linux беше добавен : мрежов API, който всички съвременни драйвери използват за повишаване на производителността при високи скорости. При ниски скорости ядрото все още получава прекъсвания от мрежовата карта по стария начин. След като пристигне достатъчно количество пакети, надвишаващо определен праг, ядрото деактивира прекъсванията и вместо това започва да запитва мрежовия адаптер и да взима пакетите на порции. Обработката се извършва в softirq, тоест в след системни повиквания и хардуерни прекъсвания, когато ядрото (в отличие от потребителското пространство) вече е активирано.
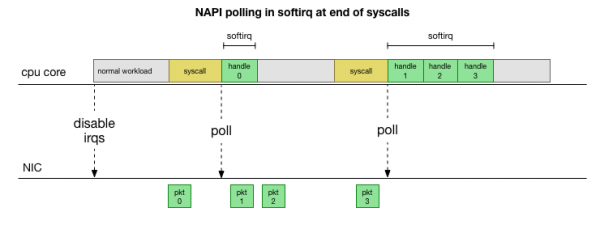
Това е значително по-бързо, но създава друг проблем. Ако пакетите са твърде много, всичкото време се изразходва за обработка на пакети от мрежовата карта, а процесите в потребителското пространство не успяват действително да опразнят тези опашки (четене от TCP-соединения и т.н.). В крайна сметка опашките се запълват и започваме да отпадат пакети. Опитвайки се да намери баланс, ядрото установява бюджет за максималното количество пакети, обработвани в контекста на softirq. След като този бюджет бъде надвишен, се активира отделен поток ksoftirqd (ще видите един от тях в ps за всяко ядро), който обработва тези softirq извън обичайния път syscall/interrupt. Този поток се планира с помощта на стандартния процесорен планиратор, който се опитва да разпредели ресурсите справедливо.
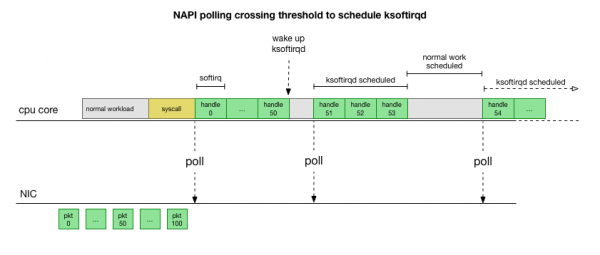
Изучавайки как ядрото обработва пакети, можете да забележите, че тук има определена вероятност за забавяне. Ако повикванията на softirq идват по-рядко, пакетите ще трябва да чакат известно време в опашката RX на мрежовата карта. Вероятно, това е поради някаква задача, която блокира ядрото на процесора, или нещо друго пречи на ядрото да стартира softirq.
Ограничаваме обработката до ядрото или метода
Забавянето на softirq все още е само предположение. Но то има смисъл, и ние знаем, че наблюдаваме нещо много подобно. Следващата стъпка е да потвърдим тази теория. А ако тя се потвърди, да намерим причината за забавянето.
Нека се върнем към нашите бавни пакети:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Както вече обсъждахме, тези ICMP пакети се хешират в едно опашно NIC RX и се обработват от едно ядро на CPU. Ако искаме да разберем работата на Linux, полезно е да знаем къде (на кое ядро на CPU) и как (softirq, ksoftirqd) се обработват тези пакети, за да проследим процеса.
Сега е време да използваме инструменти, които позволяват в реално време да проследяваме работата на ядрото Linux. Тук използвахме . Този набор от инструменти позволява писането на малки програми на C, които прихващат произволни функции в ядрото и буферират събития в програма на Python в потребителското пространство, която може да ги обработи и да върне резултата. Хукването на произволни функции в ядрото е сложен процес, но утилитата е проектирана с максимална безопасност и е предназначена за проследяване на точно такива производствени проблеми, които трудно могат да се възпроизведат в тестова или развойна среда.
Планът тук е прост: знаем, че ядрото обработва тези ICMP пинги, следователно ще поставим хук на функцията на ядрото , която приема входящия ICMP пакет 'echo request' и инициира изпращането на ICMP отговор 'echo response'. Можем да идентифицираме пакета чрез увеличаване на номера icmp_seq, който показва hping3 отгоре.
Код изглежда сложен, но не е толкова страшен, колкото изглежда. Функцията icmp_echo предава struct sk_buff *skb: това е пакет с запитване 'echo request'. Можем да го проследим, да изтеглим последователността echo.sequence (която съответства на icmp_seq от hping3 по-горе), и да я изпратим в потребителското пространство. Освен това е удобно да заснемем текущото име на процеса/идентификатора. По-долу са показани резултатите, които виждаме непосредствено по време на обработката на пакетите от ядрото:
TGID    PID     PROCESS NAME    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Тук трябва да се отбележи, че в контекста softirq процесите, които са направили системни повици, ще се показват като „процеси“, въпреки че всъщност ядрото безопасно обработва пакети в контекста на ядрото.
С този инструмент можем да свържем конкретни процеси с конкретни пакети, които показват забавяне в hping3. Правим прост grep на този улов за определени стойности icmp_seq. Пакетите, съответстващи на горепосочените стойности icmp_seq, бяха отбелязани заедно с техния RTT, който наблюдавахме по-горе (в скобите са посочени очакваните стойности на RTT за пакетите, които филтрирахме поради стойности на RTT под 50 ms):
TGID    PID     PROCESS NAME    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Резултатите ни казват за няколко неща. Първо, всички тези пакети се обработват от контекста ksoftirqd/11. Това означава, че за тази конкретна двойка машини ICMP-пакетите са хеширани на ядро 11 от приемащата страна. Също така виждаме, че при всяко задръстване има пакети, които се обработват в контекста на системен повик cadvisor. След това ksoftirqd поема задачата и обработва натрупаната опашка: точното количество пакети, което се е натрупало след cadvisor.
Фактът, че непосредствено преди това винаги работи cadvisor, предполага неговото участие в проблема. За ирония, предназначението е „да анализира използването на ресурси и производителността на стартираните контейнери“, а не да причинява този проблем с производителността.
Как и с другите аспекти на работата с контейнери, това е изключително напреднал инструментариум, от който спокойно можем да очакваме проблеми с производителността при определени неочаквани обстоятелства.
Какво точно прави cadvisor, което забавя опашката от пакети?
Сега имаме доста добро разбиране за това как се случва сривът, кой процес го причинява и на кой CPU. Виждаме, че заради сериозната блокировка ядрото на Linux не успява да планира навреме. ksoftirqd. И виждаме, че пакетите се обработват в контекста на cadvisor. Логично е да предположим, че cadvisor запуска бавен syscall, след което се обработват всички натрупани в това време пакети:
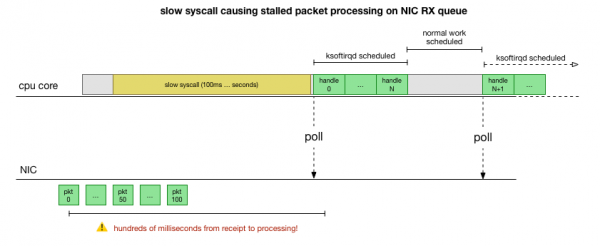
Това е теория, но как можем да я проверим? Какво можем да направим е да проследим работата на ядрото на CPU през целия този процес, да намерим точката, в която се надвишава бюджета за брой пакети и се извиква ksoftirqd, а след това да погледнем малко по-рано – какво точно е работело на ядрото на CPU непосредствено преди този момент. Това е като рентгеново изображение на CPU на всеки няколко милисекунди. То ще изглежда приблизително така:
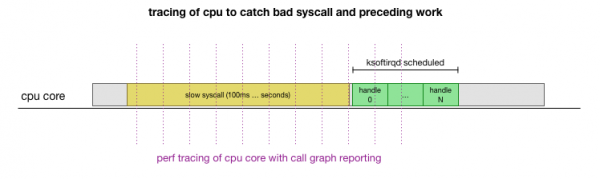
Удобно е, че всичко това може да бъде направено с наличните инструменти. Например, с указан интервал проверява зададения ядро на CPU и може да генерира графика на извикванията на работната система, включително пространство за потребители и ядрото на Linux. Можем да вземем тази записи и да я обработим с малък форк на програмата от Брендан Грегг, който запазва реда на трасировките на стека. Можем да записваме едноредови трасировки на стека на всеки 1 мс, а след това да извадим и запазим образец за 100 милисекунди преди да попадне в трасировката ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Ето и резултатите:
(стотици следи, които изглеждат подобно)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Тук има много какво, но най-важното е, че намираме шаблона „cadvisor пред ksoftirqd“, който вече видяхме в пуржомата ICMP. Какво означава това?
Всяка ред е трасировка на CPU в определен момент. Всеки низходящ повик по стека в реда се разделя с точка и запетая. В средата на редовете виждаме извиквания syscall: read(): .... ;do_syscall_64;sys_read; .... По този начин, cadvisor прекарва много време в системния повик read(), свързан с функциите mem_cgroup_* (горната част на стека от повиквания/края на реда).
В трасировките на повиквания е неудобно да се вижда какво точно се прочита, затова ще стартираме strace и ще видим какво прави cadvisor и ще намерим системни повиквания над 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Както беше възможно да се предположи, тук виждаме бавни повиквания read(). От съдържанието на операциите за четене и контекста mem_cgroup виждаме, че тези извиквания read() се отнасят до файла memory.stat, който показва използването на паметта и ограниченията на cgroup (технология за изолация на ресурси в Docker). Инструментът cadvisor извиква този файл, за да получи информация за използването на ресурси за контейнерите. Нека проверим дали ядрото или cadvisor прави нещо неочаквано:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
истинско 0m0.153s
потребител 0m0.000s
системен 0m0.152s
theojulienne@kube-node-bad ~ $
Сега можем да възпроизведем бъга и разбираме, че ядрото на Linux се сблъсква с патология.
Каква е причината операцията по четене да е толкова бавна?
На този етап е много по-лесно да намерим съобщения от други потребители за подобни проблеми. Оказа се, че в тракера на cadvisor за този бъг е съобщено като , просто никой не е забелязал, че забавянето също случайно се отразява в мрежовия стек. В действителност беше забелязано, че cadvisor консумира повече процесорно време, отколкото се очакваше, но на това не се обърна внимание, тъй като нашите сървъри имат много процесорни ресурси, така че проблемът не беше проучен подробно.
Проблемът е, че контролните групи (cgroups) отчитат използването на паметта в рамките на пространството на имената (контейнер). Когато всички процеси в тази cgroup приключат, Docker освобождава контролната група на паметта. Обаче "паметта" не е просто памет на процеса. Въпреки че самата памет на процесите вече не се използва, се оказва, че ядрото назначава още кеширано съдържание, като dentries и inodes (метаданни на директории и файлове), които се кешират в memory cgroup. От описанието на проблема:
cgroups-зомбита: контролни групи, в които няма процеси и те са премахнати, но за които все още е заделена памет (в моя случай, от кеша на dentry, но тя също може да бъде заделена от кеша на страниците или tmpfs).
Проверяването от ядрото на всички страници в кеша при освобождаване на cgroup може да бъде много бавно, затова е избран ленив процес: да изчака, докато тези страници отново бъдат поискани, и едва тогава, когато паметта наистина е необходима, накрая да се изчисти cgroup. До този момент cgroup все още се включва при събирането на статистика.
От гледна точка на производителността, те жертваха паметта в името на производителността: ускоряване на първоначалното почистване благодарение на наличието на малко кеширана памет. Това е приемливо. Когато ядрото използва последната част от кешираната памет, cgroup в крайна сметка се изчиства, така че това не може да се нарече "изтичане". За съжаление, конкретната реализация на механизма за търсене memory.stat в тази версия на ядрото (4.9), в комбинация с огромния обем памет на нашите сървъри, води до това, че възстановяването на последните кеширани данни и почистването на cgroup-зомби отнема много повече време.
Оказа се, че на някои от нашите възли имаше толкова много cgroup-зомби, че четенето и закъснението надвишаваха секунда.
Начинът за заобикаляне на проблема с cadvisor е незабавното освобождаване на кешовете dentries/inodes в цялата система, което веднага отстранява закъснението при четене, както и мрежовото закъснение на хоста, тъй като премахването на кеша включва кешираните страници cgroup-зомби, които също биват освобождавани. Това не е решение, но потвърдете причината за проблема.
Оказа се, че в по-новите версии на ядрото (4.19+) производителността на извикването е подобрена, memory.statтака че преминаването към това ядро елиминира проблема. В същото време имахме инструментариум за откриване на проблемни възли в Kubernetes клъстери, елегантно изтичане и рестартиране. Прегледахме всички клъстери, намерихме възли с достатъчно високо закъснение и ги рестартирахме. Това ни даде време за обновление на ОС на останалите сървъри.
В обобщение
Тъй като този бъг спираше обработката на опашките NIC RX за стотици милисекунди, той предизвикваше едновременно голямо закъснение на кратките съединения и закъснение в средата на съединението, например, между MySQL заявки и отговорни пакети.
Разбирането и поддръжката на производителността на най-фундаменталните системи, като Kubernetes, е от решаващо значение за надеждността и скоростта на всички услуги, основаващи се на тях. Всички системи, стартиращи върху Kubernetes, печелят от подобренията в производителността.
Източник: habr.com
