

Преди три години Виктор Тарнавски и Алексей Миловидов от Яндекс на сцената HighLoad++ , колко добър е ClickHouse и как не забавя. А на съседната сцена беше Александър Зайцев с за преминаването на ClickHouse от друга аналитична СУБД и с извода, че ClickHouse, разбира се, е добър, но не много удобен. Когато през 2016 година компанията LifeStreet, в която тогава работеше Александър, прехвърляше мултипетабайтовата аналитична система на ClickHouse, това беше вълнуваща "пътечка от жълти тухли", пълна с невидими опасности — ClickHouse тогава напомняше минирано поле.
Три години по-късно ClickHouse стана много по-добре — през това време Александър основа компания Altinity, която не само помага за преместването на ClickHouse десетки проекти, но и усъвършенства самия продукт заедно с колегите си от Яндекс. Сега ClickHouse все още не е безгрижна разходка, но вече не е минирано поле.
Александър се занимава с разпределени системи от 2003 година, разработвал е големи проекти на MySQL, Oracle и Vertica. На проведената HighLoad++ 2019 Александър, един от пионерите в използването на ClickHouse, разказа какво представлява тази СУБД в момента. Ние научаваме за основните характеристики ClickHouse: с какво се различава от другите системи и в кои случаи е по-ефективно да се използва. На примери ще разгледаме свежи и доказани практики по изграждане на системи на ClickHouse.
Ретроспектива: какво беше преди 3 години
Преди три години прехвърляхме компанията LifeStreet на ClickHouse от друга аналитична база данни, и миграцията на аналитиката на рекламната мрежа изглеждаше така:
- Юни 2016. В OpenSource се появи ClickHouse и стартира нашият проект;
- Август. Proof Of Concept: голяма рекламна мрежа, инфраструктура и 200-300 терабайта данни;
- Октомври. Първите продукционни данни;
- Декември. Пълна продуктова натовареност — 10-50 милиарда събития на ден.
- Юни 2017. Успешно преминаване на потребителите на ClickHouse, 2,5 петабайта данни на клъстер от 60 сървъра.
По време на миграцията нарастваше разбирането, че ClickHouse — това е една добра система, с която е приятно да работите, но това е вътрешен проект на компанията Яндекс. Затова има специфики: Яндекс първо ще се занимава със собствените вътрешни поръчки, а едва след това — с общността и нуждите на външните потребители, а ClickHouse по много функционални области не отговаряше на нивото на ентерпрайза. Затова през март 2017 г. основахме компания Altinity, за да направим ClickHouse все по-бърза и удобна не само за Яндекс, но и за други потребители. И сега ние:
- Обучаваме и помагаме да се изградят решения на ClickHouse така, че клиентите да не се сблъскват с трудности и решението в крайна сметка да работи;
- Осигуряваме 24/7 поддръжка ClickHouse-на инсталации;
- Разработваме собствени екосистемни проекти;
- Активно ангажираме с ClickHouse, отговаряйки на запитвания на потребители, които искат да виждат определени функции.
И разбира се, помагаме с миграция към ClickHouse с MySQL, Vertica, Oracle, Greenplum, Redshift и други системи. Участвали сме в най-различни миграции и те всички бяха успешни.
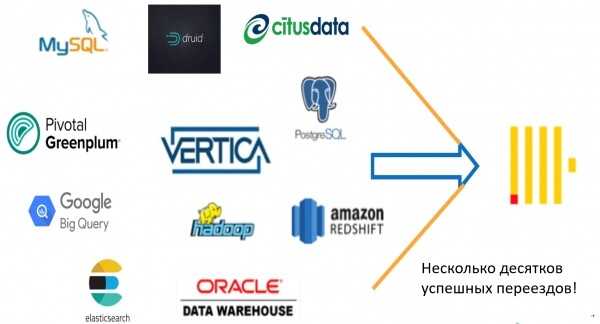
Защо изобщо да мигрирате към ClickHouse
Не забавяне! Това е основната причина. ClickHouse — много бърза база данни за различни сценарии:
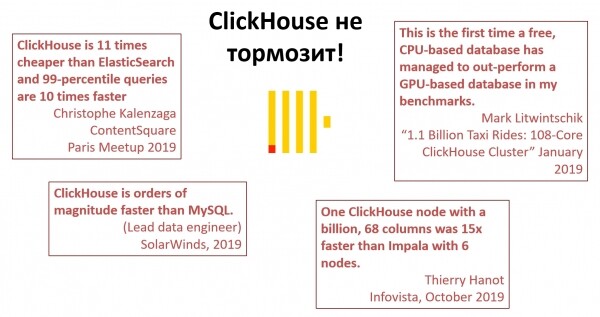
Случайни цитати от хора, които дълго време работят с ClickHouse.
Мащабируемост. На някоя друга база данни може да се постигне добра производителност на едно устройство, но ClickHouse може да мащабирате не само вертикално, но и хоризонтално, просто добавяйки сървъри. Всичко работи не толкова гладко, колкото бихте искали, но работи. Може да разширявате системата заедно с растежа на бизнеса. Важно е, че не сме ограничени до решението в момента и винаги има потенциал за развитие.
Преносимост. Няма обвързване с нещо едно. Например, с Amazon Redshift е трудно да се мигрира. А ClickHouse може да инсталира на лаптопа си, на сървър, да се разположи в облака, да се прехвърли в Kubernetes — няма ограничения за експлоатация на инфраструктурата. Това е удобно за всички и е голямо предимство, с което не могат да се похвалят много други подобни бази данни.
Гъвкавост. ClickHouse не спира на нещо едно, например, на Яндекс.Метрика, а се развива и използва в все повече и повече различни проекти и индустрии. Може да се разширява, добавяйки нови възможности за решаване на нови задачи. Например, смята се, че съхраняването на логовете в база данни е лоша практика, затова за това е измислен Elasticsearch. Но благодарение на гъвкавостта ClickHouse, в него също може да се съхраняват логове, и често това е дори по-добре, отколкото в Elasticsearch — в ClickHouse за това е необходимо 10 пъти по-малко оборудване.
Безплатно Отворен код. Не е нужно да плащате за нищо. Не е нужно да се договаряте за разрешение да инсталирате системата на лаптопа или сървъра си. Няма скрити такси. При това, никоя друга технология за управление на бази данни с отворен код не може да конкурира по бързина с ClickHouse. MySQL, MariaDB, Greenplum — всичките те са значително по-бавни.
Общество, драйв и забавление. Има страхотно общество: срещи, чатове и Алексей Миловидов, който ни зарежда с енергия и оптимизъм. ClickHouse Преминаване на ClickHouse
За да преминете на
от нещо, са необходими само три неща: ClickHouse Да разбирате ограниченията
- и за какво не е подходящ. ClickHouse Да използвате предимствата
- на технологията и нейните най-силни страни. Да експериментирате
- . Дори да разбирате как работи, не винаги е възможно да предвидите, кога ще бъде по-бърз, кога по-бавен, кога по-добър и кога по-лош. Затова опитвайте. ClickHouseПроблема с преминаването
Има само едно “но”: ако преминавате на
от нещо друго, обикновено нещо не върви както трябва. Свикнали сме с определени практики и неща, които работят в любимата ни БД. Например, всеки, който работи с ClickHouse SQL-бази данни, счита, че наличието на такъв набор от функции е задължително: транзакции;ограничения;
- консистенция;
- индекси;
- UPDATE/DELETE
- NULLs
- милисекунди;;
- автоматични преобразувания на типове;;
- множество джойни;
- произволни партиции;
- инструменти за управление на клъстери.
- Сетът е задължителен, но преди три години в
- нямаше нито една от тези функции! Сега от нереализираните е останала по-малко от половината: транзакции, ограничения, консистенция, милисекунди и преобразуване на типове.
И основното — е, че в ClickHouse някои стандартни практики и подходи не работят или работят различно от това, с което сме свикнали. Всичко, което се появява в
, съответства на “ ClickHouse ClickHouse начин ClickHouse”, т.е. функциите се различават от другите бази данни. Например:Индексите не се избират, а се пропускат.не синхронни, а асинхронни.
- Има множество джойни, но няма планировчик за заявки. Как тогава те се изпълняват, изобщо не е много ясно на хората от света на БД.
- милисекунди; Сценарии на ClickHouse
- През 1960 година американският математик с унгарски произход
Wigner E. P.
написа статия “ Нерационалната ефективност на математиката в естествените науки написа статия "Нерационалната ефективност на математиката в естествените науки» («Необикновената ефективност на математиката в естествените науки») за това, че околният свят по някаква причина се описва добре с математически закони. Математиката е абстрактна наука, а физическите закони, изразени в математическа форма, не са тривиални, и Нерационалната ефективност на математиката в естествените науки подчерта, че това е много странно.
От моя гледна точка, ClickHouse — същата странност. Преформулирайки Вигнер, можем да кажем така: удивителна е необикновената ефективност ClickHouse в най-разнообразни аналитични приложения!
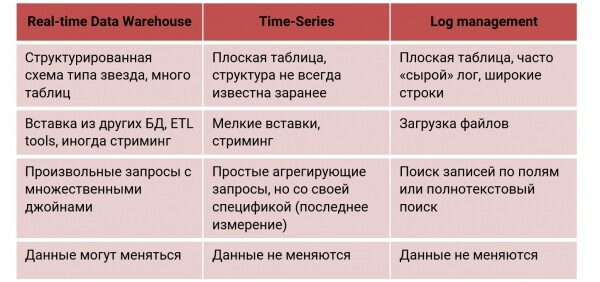
Например, нека вземем Real-Time Data Warehouse, в който данните се зареждат практически непрекъснато. Искаме да получаваме запитвания от него с едносекунден закъснение. Моля — използваме ClickHouse, защото за този сценарий той е разработен. ClickHouse точно така и се използва не само в уеб, но и в маркетингова и финансова аналитика, AdTech, а също и в Fraud detection. В Real-Time Data Warehouse се използва сложна структурирана схема тип «звезда» или «снежинка», много таблици с JOIN (понякога множествени), а данните обикновено се съхраняват и променят в някакви системи.
Нека вземем друг сценарий — Time Series: мониторинг на устройства, мрежи, статистика на използване, интернет на нещата. Тук срещаме подредени по време доста прости събития. ClickHouse за това не е бил първоначално разработен, но се е доказал добре, затова големи компании използват ClickHouse като хранилище за мониторингова информация. За да проучим, дали ClickHouse подходи за time-series, направихме бенчмарк на базата на подхода и резултатите InfluxDB и TimescaleDB — специализирани time-series бази данни. , че ClickHouse, дори без оптимизация за такива задачи, печели и на чуждо поле:
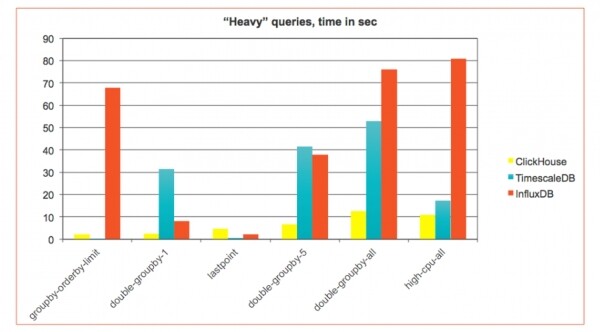
В time-series обикновено се използва тясна таблица — няколко малки колони. От мониторинга може да идват много данни — милиони записи в секунда — и обикновено те постъпват с малки вставки (real-time стрийминг). Затова е нужен друг сценарий на вставка, а самите запитвания — със своя известна специфика.
Log Management. Събирането на логове в БД — това обикновено е лошо, но в ClickHouse това може да се прави с някои коментари, както е описано по-горе. Много компании използват ClickHouse точно за това. В този случай се използва плоска широка таблица, където съхраняваме логовете изцяло (например, под формата на JSON), или гигантски парчета. Данните обикновено се зареждат на големи партиди (файлове), а търсим по някакво поле.
За всяка от тези функции обикновено се използват специализирани бази данни. ClickHouse един може да прави всичко това и да е толкова добър, че да надминава производителността им. Нека сега разгледаме подробно time-series сценария и как правилно да „подготвим“ ClickHouse за този сценарий.
Time-Series
В момента това е основният сценарий, за който ClickHouse се счита стандартно решение. Time-series — това е набор от събития, подредени във времето, представляващи изменения на някакъв процес с времето. Например, това може да бъде честотата на сърдечните удари за ден или броят на процесите в системата. Всичко, което предоставя времеви тикове с някакви измервания – това е time-series:
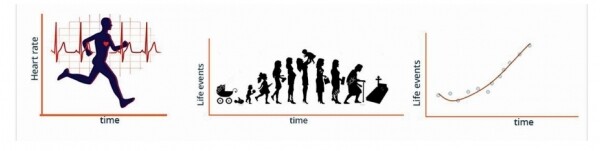
Най-много от този вид събития идват от мониторинга. Това може да бъде не само мониторинг на уеба, но и на реални устройства: автомобили, промишлени системи, IoT, производства или безпилотни таксита, в багажника на които Яндекс вече влага ClickHouse-сървър.
Например, има компании, които събират данни от кораби. На всеки няколко секунди сензорите от контейнерния кораб изпращат стотици различни измервания. Инженерите ги проучват, изграждат модели и се опитват да разберат колко ефективно се използва корабът, защото контейнерният кораб не трябва да престоява нито секунда. Всеки престой — това е загуба на пари, затова е важно да се прогнозира маршрутът така, че спирането да бъде минимално.
В момента се наблюдава растеж на специализираните бази данни, които измерват time-series. На сайта DB-Engines по някакъв начин се класифицират различни бази данни и те могат да се видят по типове:
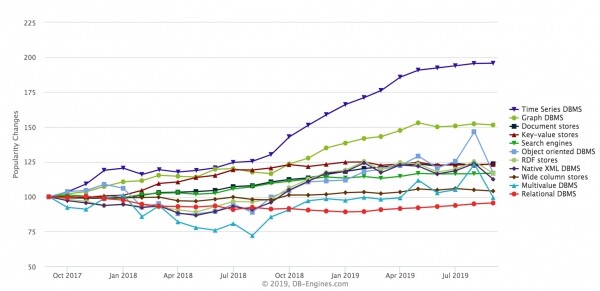
Най-бързо растящият тип — time-series. Също така растат графовите бази данни, но time-series растат по-бързо през последните няколко години. Типични представители на бази данни от това семейство — това е InfluxDB, Prometheus, KDB, TimescaleDB (изградена на PostgreSQL), решения от Amazon. ClickHouse тук също може да бъде използван, и той се използва. Ще дам няколко публични примера.
Един от пионерите — компания CloudFlare (CDN-провайдер). Те наблюдават своя CDN чрез ClickHouse (DNS-запроси, HTTP-запроси) с огромно натоварване — 6 милиона събития в секунда. Всичко минава през Kafka, изпраща се в ClickHouse, който предоставя възможност в реално време да виждате табла за събития в системата.
Comcast е един от лидерите в телекомуникациите в САЩ: интернет, цифрова телевизия, телефония. Те създадоха аналогична система за управление CDN в рамките на Отворен код проекта Apache Traffic Control за работа с огромните си данни. ClickHouse се използва като бекенд за аналитика.
Percona вградили ClickHouse вътре в своя PMM, за да съхраняват мониторинга на различни MySQL.
Специфични изисквания
Към базите данни от тип time-series има свои специфични изисквания.
- Бързо вмъкване от много агенти. Трябва много бързо да вмъкнем данни от много потоци. ClickHouse прави това добре, защото всички вмъквания не блокират. Всеки insert е нов файл на диска, а малките вмъквания могат да се буферират по един или друг начин. В ClickHouse по-добре е да вмъкваме данни с големи пакети, отколкото по един ред.
- Гъвкава схема. В time-series обикновено не знаем окончателната структура на данните. Може да се построи система за мониторинг за конкретно приложение, но тогава е трудно да се използва за друго приложение. За това е необходима по-гъвкава схема. ClickHouse, позволяваща това да се направи, дори и да е строго типизирана база.
- Ефективно съхранение и „забравяне“ на данни. Обикновено в time-series гигантски обеми данни, затова трябва да се съхраняват максимално ефективно. Например, у InfluxDB добрата компресия е основната му характеристика. Но освен съхранението, трябва също така да можем да „забравяме“ стари данни и да правим някакъв downsampling — автоматично изчисляване на агрегати.
- Бързи заявки за агрегирани данни. Понякога е интересно да се видят последните 5 минути с точност до милисекунди, но при месечни данни минуточната или секундната грануларност може да не е необходима — достатъчна е общата статистика. Поддържането на такъв вид е необходимо, в противен случай заявка за 3 месеца ще се изпълнява много бавно дори в ClickHouse.
- Запитвания от типа „last point, as of». Това са типични за time-series запитвания: разглеждаме последното измерване или състояние на системата в определен момент t. За БД техните заявки не са особено приятни, но също така трябва да можем да ги изпълняваме.
- „Склеяване“ на времеви редове. Time-series е времеви ред. Ако има два времеви реда, често трябва да се съединяват и корелират. Не на всички БД това е удобно да се прави, особено с неравностойни времеви редове: тук — едни времеви точки, там — други. Може да се изчисляват средни стойности, но може да има пробив, затова не е ясно.
Нека видим как тези изисквания се изпълняват в ClickHouse.
Схема
В ClickHouse схема за time-series може да бъде направена по различни начини, в зависимост от честотата на данните. Може да се изгради система на базата на редовни данни, когато знаем всички метрики предварително. Например, това направи CloudFlare с мониторинг CDN — това е добре оптимизирана система. Може да се изгради по-обща система, която мониторира цялата инфраструктура и различните услуги. В случай на нерегулярни данни, ние не знаем предварително какво мониторираме — и, вероятно, това е най-общия случай.
Редовни данни. Колони. Схемата е проста – колони с нужните типове:
CREATE TABLE cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* join to dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Това е обикновена таблица, която мониторира някаква активност по натоварване на системата (user, system, idle, nice). Просто и удобно, но не гъвкаво. Ако искаме по-гъвкава схема, можем да използваме масиви.
Нерегулярни данни. Масиви:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...
Структура Nested — това са два масива: metrics.name и metrics.value. Тук могат да се съхраняват произволни мониторингови данни, като масив от имена и масив от измервания при всяко събитие. За по-нататъшна оптимизация вместо една такава структура могат да се направят няколко. Например, едната — за float-стойност, другата — за int-стойност, защото int искаме да съхраняваме по-ефективно.
Но до такава структура е по-трудно да се обращаме. Ще трябва да използваме специална конструкция, за да извлечем стойности първо от индекса, а след това от масива:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FROM ...Но това все пак работи достатъчно бързо. Друг начин за съхранение на нерегулярни данни – редове.
Нерегулярни данни. Редове. В този традиционен метод без масиви се съхраняват веднага имената и стойностите. Ако от едно устройство пристигнат наведнъж 5 000 измервания — се генерират 5 000 реда в БД:
СЪЗДАЙ ТАБЛИЦА cpu_rlc (
  created_date Дата,
  created_at DateTime,
  time Низ,
  tags_id UInt32,
  metric_name LowCardinality(Низ),
  metric_value Float64
) ДВИГАТЕЛ = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


ИЗБЕРИ
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
ОТ cpu_r
КЪДЕ metric_name В ('usage_user', ...)
ClickHouse с което се справя — има специални разширения ClickHouse SQL. Например, maxIf — специална функция, която изчислява максимума по метриката при изпълнение на определено условие. Можеш да напишеш няколко такива израза в една заявка и веднага да изчислиш стойността за няколко метрики.
Нека сравним три подхода:
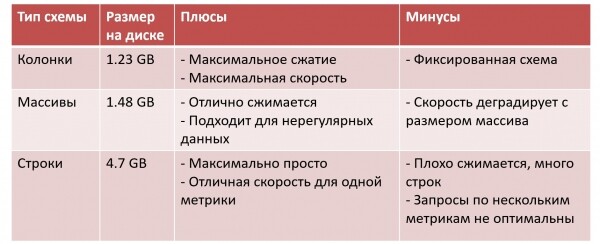
Тук добавих «Размер на данните на диска» за определен тестов набор от данни. В случай на колони, имаме най-малкия размер на данни: максимално компресиране, максимална скорост на заявките, но плащаме, като трябва да фиксираме всичко наведнъж.
В случая с масивите всичко е малко по-лошо. Данните все още се компресират добре и можем да съхраняваме нерегулярна схема. Но ClickHouse — колоночна база данни, а когато започнем да съхраняваме всичко в масив, тя се превръща в редова, и плащаме за гъвкавост с ефективността. За всяка операция ще трябва да прочетем целия масив в паметта, след това да намерим нужния елемент — а ако масивът расте, скоростта деградира.
В една от компаниите, която използва такъв подход (например, ), масивите се нарязват на парчета от 128 елемента. Данните на няколко хиляди метрики, обем от 200 ТБ данни/ден, не се съхраняват в един масив, а в 10 или 30 масива със специална логика за съхранение.
Най-простият подход — с редове. Но данните се компресират трудно, размерът на таблицата е голям, а когато заявките са по няколко метрики, ClickHouse работи неоптимално.
Хибридна схема
Да приемем, че сме избрали схема с масив. Но ако знаем, че повечето от нашите табла показват само метрики user и system, можем допълнително от масива на ниво таблица да материализираме тези метрики в колони по следния начин:
СЪЗДАЙ ТАБЛИЦА cpu_alc (
  created_date Дата,
  created_at DateTime,
  time Низ,
  tags_id UInt32,
  metrics Нестед(
    name LowCardinality(Низ),
    value Float64
  ),
  usage_user Float64
             МАТЕРИАЛИЗИРАН metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             МАТЕРИАЛИЗИРАН metrics.value[indexOf(metrics.name,'usage_system')]
) ДВИГАТЕЛ = MergeTree(created_date, (tags_id, created_at), 8192);
При вмъкване ClickHouse автоматично ще ги преброи. Така можете да съчетаете приятно с полезно: схемата е гъвкава и обща, но най-често използваните колони са извлечени. Забележете, че това не изисква промяна на вставката и ETL, който продължава да вмъква масиви в таблицата. Просто направихме ALTER TABLE, добавихме няколко колони и получихме хибридна и по-бърза схема, с която може да се започне веднага.
Кодеци и компресия
За time-series е важно колко добре опаковате данните, тъй като масивът от информация може да бъде много голям. В ClickHouse има набор от средства за постигане на компресия 1:10, 1:20, а понякога и повече. Това означава, че неупаковани данни с обем 1 ТБ на диска заемат 50-100 ГБ. По-малкият размер е благоприятен, данните могат да бъдат прочетени и обработени по-бързо.
За постигане на висок уровень на компресия, ClickHouse поддържа следните кодеци:
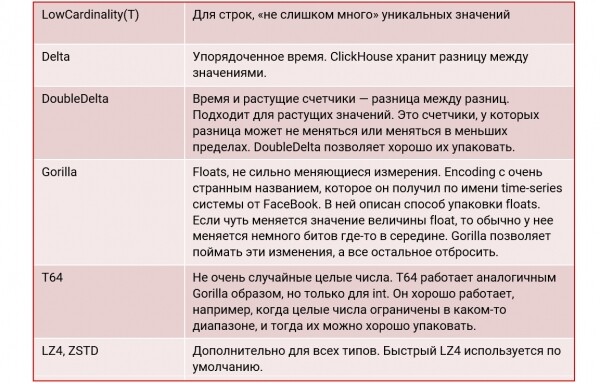
Пример таблица:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Тук определяме кодека DoubleDelta в един случай, а в другия — Gorilla, и задължително добавяме още LZ4 компресия. В резултат размерът на данните на диска значително намалява:
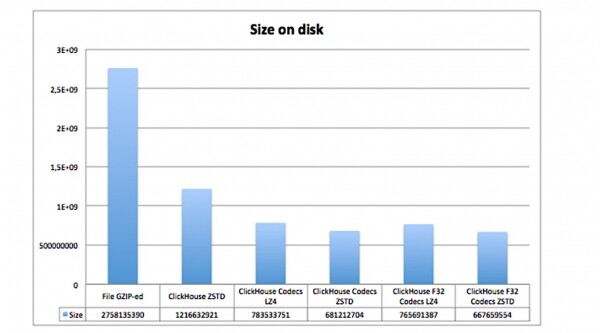
Тук е показано колко място заемат едни и същи данни, но с използване на различни кодеци и компресии:
- в GZIP-ван файл на диска;
- в ClickHouse без кодеци, но с ZSTD-компресия;
- в ClickHouse с кодеци и компресия LZ4 и ZSTD.
Ясно е, че таблиците с кодеци заемат много по-малко място.
Размерът има значение
Не по-малко важно правилния тип данни:
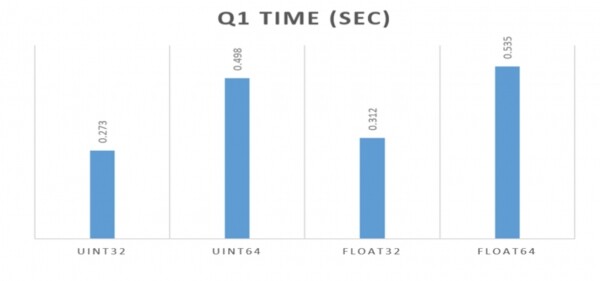
Във всичките примери по-горе използвах Float64. Но ако бяхме избрали Float32, това би било дори по-добре. Това добре демонстрираха момчетата от Перкона в статията по горната връзка. Важно е да се използва максимално компактен тип, подходящ за задачата: дори в по-малка степен за размера на диска, отколкото за скоростта на запитванията. ClickHouse много е чувствителен към това.
Ако можете да използвате int32 вместо int64, то очаквайте почти двойно увеличение производителността. Данните заемат по-малко памет, и цялата „арифметика“ работи много по-бързо. ClickHouse вътре в себе си — много строго типизирана система, той максимално използва всички възможности, които предлагат съвременните системи.
Агрегация и Materialized Views
Агрегацията и материализираните изгледи позволяват да се правят агрегати за различни случаи на употреба:
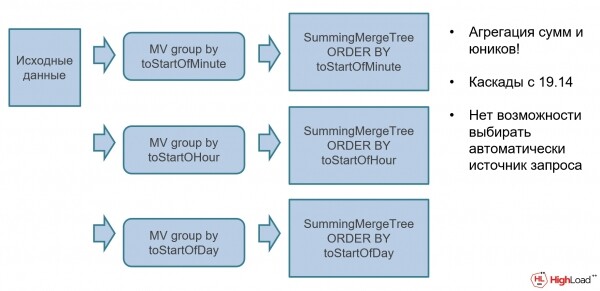
Например, ако имате неагрегирани изходни данни, можете да приложите различни материализирани изгледи с автоматично сумиране чрез специален механизъм SummingMergeTree (SMT). SMT — това е специална агрегираща структура от данни, която автоматично изчислява агрегатите. В базата данни се вмъкват сурови данни, те се агрегатизират автоматично и веднага могат да се използват за табла.
TTL — „забравяме“ стари данни
Как да „забравим“ данни, които вече не са нужни? ClickHouse може да го направи. При създаване на таблици можете да посочите TTL изрази: например, че минутните данни се съхраняват един ден, дневните — 30 дни, а седмичните или месечните никога не се пипат:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Многостепенна — разделяме данните по дискове
Развивайки тази идея, данните могат да се съхраняват в ClickHouse различни места. Да предположим, че искаме да съхраняваме горещи данни от последната седмица на много бърз локален SSD, а по-историческите данни поставяме на друго място. В ClickHouse сега това е възможно:
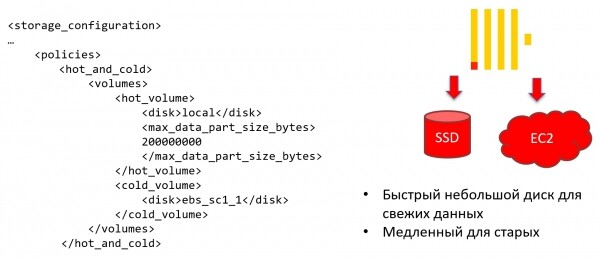
Можете да конфигурирате политиката на съхранение (storage policy) така, че ClickHouse автоматично да премества данните при достигане на определени условия в друга хранилище.
Но и това не е всичко. На ниво конкретна таблица можете да зададете правила, кога точно във времето данните преминават на студено съхранение. Например, данните остават на много бърз диск в продължение на 7 дни, а всичко, което е по-старо, се прехвърля на бавен. Това е добре, защото позволява системата да поддържа максимална производителност, като същевременно контролира разходите и не харчи средства за студени данни:
CREATE TABLE
…
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Уникални възможности ClickHouse
Почти навсякъде в ClickHouse има такива „извънземни“ функции, но те се неутрализират от ексклузивността — нещата, които не съществуват в други бази данни. Например, ето някои от уникалните функции ClickHouse:
- Масиви. В ClickHouse много добра поддръжка за масиви, както и възможност за изпълнение на сложни изчисления върху тях.
- Агрегиращи структури от данни. Това е една от „killer features“ ClickHouse. Въпреки че момчетата от Яндекс казват, че не искаме да агрегирим данни, всички агрегираят в ClickHouse, защото е бързо и удобно.
- Материализирани представяния. Заедно с агрегиращите структури от данни, материализираните представяния позволяват удобно real-time агрегиране.
- ClickHouse SQL. Това е разширение на езика SQL с някои допълнителни и ексклузивни функции, които съществуват само в ClickHouse. Преди това беше от една страна разширение, а от друга страна — недостатък. Сега почти всички недостатъци в сравнение с SQL 92 сме премахнали, сега е само разширение.
- Lambda-изрази. Има ли ги все още в някоя база данни?
- ML-поддръжка. Има го в различни БД, в някои по-добре, в други по-зле.
- Отворен код. Можем да разширяваме ClickHouse заедно. В момента в ClickHouse има около 500贡献者, и това число постоянно расте.
Хитри заявки
В ClickHouse има много различни начини да се направи едно и също. Например, можем да върнем последната стойност от таблицата по три различни начина за CPU (има и четвърти, но той е още по-екзотичен).
Първият показва как удобно да се правят в ClickHouse заявки, когато искате да проверите, че tuple се съдържа в подзапроса. Това е нещо, което на мен лично много ми липсваше в други БД. Ако искам да сравня нещо с подзапрос, в други БД мога да сравня само скаляр, а за няколко колони трябва да напиша JOIN. В ClickHouse може да се използва tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Вторият начин прави същото, но използва агрегатна функция argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
В ClickHouse има няколко десетки агрегатни функции, а ако се използват комбинатори, то по законите на комбинаториката стават около хиляда. ArgMax - една от функциите, която изчислява максималната стойност: заявката връща стойността usage_user, при която се достига максималната стойност created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
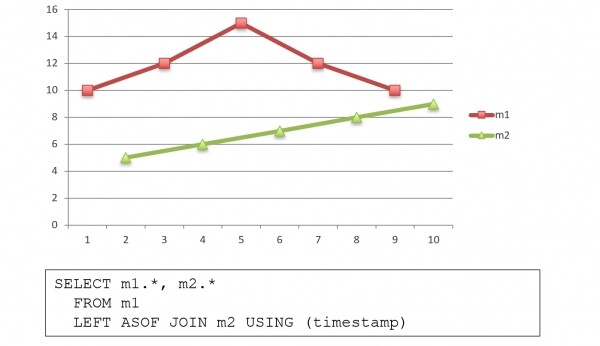
ASOF JOIN - „сливане“ на редове с различно време. Това е уникална функция за бази данни, която съществува само още в kdb+. Ако има две времеви серии с различно време, ASOF JOIN позволява да ги изместим и слепим в една заявка. За всяка стойност в една времева серия се намира най-близката стойност в другата и те се връщат на един ред:
Аналитични функции
В стандарта SQL-2003 може да се пише така:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
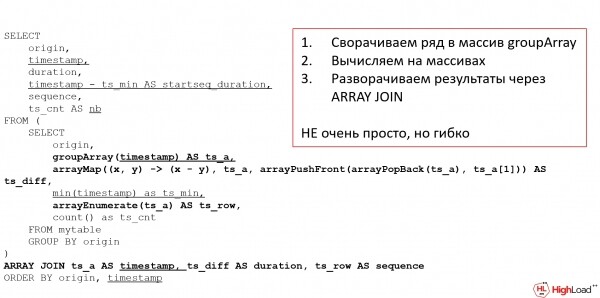
В ClickHouse така не може — той не поддържа стандарта SQL-2003 и вероятно никога няма да го направи. Вместо това в ClickHouse е прието да се пише така:
Обещах лямбди – ето ги!
Това е аналог на аналитично запитване в стандарта SQL-2003: той изчислява разликата между два timestamp, duration, пореден номер — всичко, което обикновено считаме за аналитични функции. В ClickHouse ние ги изчисляваме чрез масиви: първо свиваме данните в масив, след това правим всичко, което искаме на масива, а след това го развиваме обратно. Не е много удобно, изисква любов към функционалното програмиране, поне, но е много гъвкаво.
Специални функции
Освен това в ClickHouse има много специализирани функции. Например, как да определим колко сесии преминават едновременно? Типична задача за мониторинг – да се определи максималната натовареност с едно запитване. В ClickHouse има специална функция за тази цел:
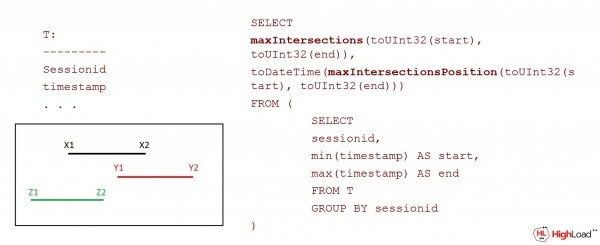
Всъщност, за много цели в ClickHouse има специални функции:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Това не е пълен списък с функции, има общо 500-600. Подсказка: всички функции в ClickHouse са в системната таблица (не всички са документирани, но всички са интересни):
select * from system.functions order by nameClickHouse също така съхранява много информация за себе си, в това число лог таблици, query_log, лог на трасировка, лог на операции с блокове данни (part_log), лог на метрики и системен лог, който обикновено записва на диск. Лог на метрики – това е time-series в ClickHouse в самия ClickHouse: СУБД сама за себе си може да играе ролята на time-series бази данни, по този начин „изяждайки“ самата себе си.
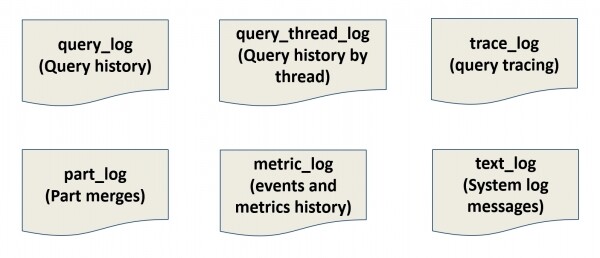
Това е уникална вещ — след като добре изпълняваме задача за time-series, защо не можем сами в себе си да съхраняваме всичко необходимо? Не ни е нужен Prometheus, съхраняваме всичко в себе си. Свързахме Grafana и сами се мониторим. Въпреки това, ако ClickHouse ако падне, ние няма да видим защо, затова обикновено така не се прави.
Голям клъстер или много малки ClickHouse
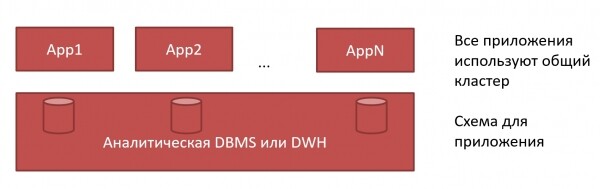
Какво е по-добре – един голям клъстер или много малки ClickHouse? Традиционният подход към DWH е голям клъстер, в който се отделят схеми за всяко приложение. Отидохме при администратора на базите данни – дайте ни схема и ни я предоставиха:
В ClickHouse може да се направи по различен начин. Може за всяко приложение да се направи собствен ClickHouse:
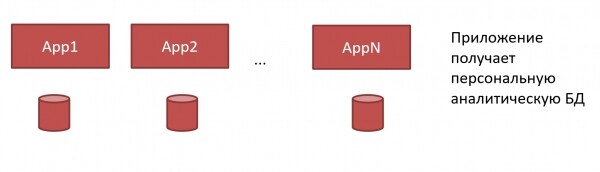
Не ни трябва голямият монструозен DWH и неподатливите администратори. Можем на всяко приложение да предоставим свой собствен ClickHouse, а разработчикът може да го направи сам, тъй като ClickHouse много лесно се инсталира и не изисква сложно администриране:
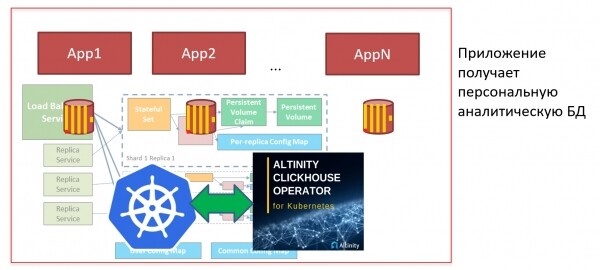
Но ако имаме много ClickHouse, и често трябва да го инсталираме, тогава искаме да автоматизираме този процес. За това можем, например, да използваме Kubernetes и clickhouse-оператор. В Kubernetes ClickHouse може да се инсталира "с едно щракване": мога да натисна бутон, да стартирам манифеста и базата е готова. Може веднага да създам схема, да започна да вкарвам метрики и след 5 минути вече имам готово табло Grafana. Толкова е просто!
Какво в крайна сметка?
И така, ClickHouse е:
- Бързо. Това е известно на всички.
- Просто. Малко спорно, но смятам, че трудното в обучението е лесно в боя. Ако разбереш как ClickHouse работи, нататък всичко е много просто.
- Универсално. То е подходящо за различни сценарии: DWH, Time Series, Log Storage. Но това не е OLTP база данни, така че не се опитвайте да правите кратки вмъквания и четения.
- Интересно. Вероятно, който работи с ClickHouse, е преживял много интересни моменти в добрия и лошия смисъл. Например, излезе нова версия, всичко спря да работи. Или когато се бореше с задача два дни, но след въпрос в чата в Телеграм задачата беше решена за две минути. Или на конференцията на доклада на Леша Миловидов, скрийншот от ClickHouse спрял предаването HighLoad++. Подобни неща се случват постоянно и правят нашия живот с ClickHouse ярък и интересен!
Презентацията може да се види .
Дългоочакваната среща на разработчиците на системи с висока натовареност на ще се проведе на 9 и 10 ноември в Сколково. Накрая това ще бъде офлайн конференция (въпреки че с всички мерки за безопасност), тъй като енергията на HighLoad++ не може да бъде опакована онлайн.
На конференцията ще ви покажем примери за максималните възможности на технологиите: HighLoad++ беше, е и ще остане единственото място, където за два дни можете да научите как работят Facebook, Яндекс, ВКонтакте, Google и Amazon.
Организирайки нашите срещи без прекъсване от 2007 година, тази година ще се срещнем за 14-ти път. През това време конференцията нарасна 10 пъти, миналата година ключовото събитие в бранша събра 3339 участници, 165 лектори и митапове, а паралелно се проведоха 16 потока.
Миналата година за вас осигурихме 20 автобуса, 5280 литра чай и кафе, 1650 литра сокове и 10200 бутилки вода. Освен това 2640 килограма храна, 16000 чинии и 25000 чаши. Между другото, с парите от рециклираната хартия посадихме 100 дъбови фиданки 🙂Билети могат да се закупят , за да получите новини за конференцията — , а за да поговорите — във всички социални мрежи: , , и .
Източник: habr.com
