

Първият API на МоегоСклада се появи преди 10 години. През всичките тези години работехме върху съществуващите версии на API и разработвахме нови. А няколко версии на API вече успяха да бъдат погребани.
В тази статия ще има много неща: как създадохме API, защо е нужен на облачния сервис, какво дава на потребителите, на какви капани успяхме да стъпим и какво искаме да правим напред.
Казвам се Олег Алексиев , аз съм технически директор и съосновател на МоегоСклада.
Защо да се прави API за услуга
Нашите клиенти, а това са десетки хиляди предприемачи, активно ползват облачни решения: банково дело, интернет магазини, стоков инвентар, CRM. Свързвайки се с един от тях, е трудно да спреш. И вече петият, осмият, десетият сервис прави работата на предприемача по-лесна, но потребителите прехвърлят данните между тези облачни услуги ръчно. Работата се превръща в кошмар.
Очевидното решение е да се предостави на потребителите възможност да прехвърлят данни между облачните услуги. Например, да импортират и експортират данни като файлове, които след това могат да бъдат заредени в нужната услуга. Файловете обикновено се адаптират за формата на всяка услуга. Това е сравнително проста ръчна работа, но с увеличаването на броя на тези услуги, става все по-трудно да се изпълнява.
Следователно, следващата стъпка е API. С него облачният сервис печели от свързването на няколко услуги на една точка. Появата на такава екосистема привлича нови клиенти чрез допълнителни възможности. Продукт с нови функционалности става по-изгоден и полезен.
Ако създавате собствени програмни интерфейси, това привлича външни търговци под формата на програмисти, които знаят за вашия продукт благодарение на API. Те започват да изграждат решения на базата на предложеното API и печелят пари от автоматизация на задачите на своите клиенти.
Системата за отчетност на МоегоСклада е изградена на простите процеси. Основното е работата с основни документи, възможността за приемане и отгрузка на стоки, получаване на отчети за бизнеса на базата на основните документи. Освен това има предаване на данни, например в облачна счетоводна система, и получаване от банкови системи или търговски точки. Също така работим с интернет магазини: получаваме данни за стоките и изпращаме информация за наличностите.
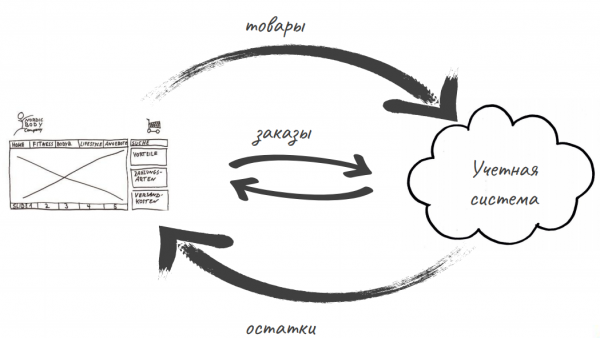
Първият API на МоегоСклада
През 10-те години работа на МоегоСклада с API натрупахме множество интеграции, които позволяват обмен на данни, работа с банки, извършване на плащания и използване на външна телефония.
В първата година създадохме възможността да изнасяме всякакви данни в XML формат. Тогава на потребителите беше много по-ясно и познато да държат данните офлайн, отколкото в някое там облако, и ние им го предоставихме. Износът се стартираше чрез ръчен експорт от интерфейса. Тоест, тогава не можехме да наречем това API.
Тогава започнахме да си сътрудничим с компанията Русагро — те вече използваха "възрастна" ERP система за планиране на производство и продажби, а автоматизацията на натоварването на вагоните в заводите бе реализирана в МоитеСклади. Така се появиха първите зачатъци на истински API: обменът между нашия сервиз и ERP се осъществяваше чрез изпращане на голям файл с данни за всички видове документи.
Това беше добър вариант за пакетен обмен на данни, но заедно с документите трябваше да се предават и техните зависимости: информация за стоките, контрагентите и складовете. Такава купчина не е толкова трудна за генериране при експортиране, но е доста трудна за разбиране при импортиране, тъй като в един пакет идват всички данни: както за новите документи, така и за вече съществуващите.
Първият XML API не просъществува дълго — две години по-късно започнахме неговото преизграждане. Още в началото на работата му направихме няколко грешки при изграждането на програмния интерфейс.
Как ставаше XML API: илюстрация от един от нашите архитекти. Между другото, очаквайте неговите статии.
Ето нашите основни грешки:
- JAXB-разметката беше направена директно върху entity beans. За комуникация с базата данни използваме Hibernate и върху същите бинове беше направена JAXB-разметка. Тази грешка се прояви почти веднага: всяко обновление на структурата на данните водеше до необходимост от спешно уведомяване на всички, които използват API, или изграждане на импровизации, които да осигурят съвместимост с предишната структура на данните.
- API се разви като допълнение, и в началото не определихме каква част от продукта представлява. Не обмисляхме и дали API е нещо важно, нужно ли е да поддържаме обратна съвместимост за първоначалните му клиенти. В определен момент потребителите на API бяха около 5% от общия брой, и не обръщахме внимание на тях. Универсалната филтрация, направена тогава, доведе до това, че започнаха да ни използват като бекенд. Тази филтрация не беше съвсем GraphQL, но нещо подобно – работеше чрез множество параметри в заявките. С такъв мощен инструмент на потребителите им беше трудно да се въздържат, и към нас се изпращаха заявки директно от UI на техните интернет магазини. Ситуацията се оказа неприятна изненада, защото предоставянето на такава услуга би изисквало различна тарификация и изобщо различно разбиране на самия API като продукт.
- Поради факта, че API се развиваше не като основен продукт, документацията по API се изготвяше и публикуваше на остатъчен принцип – чрез реверс-инжиниринг. Този подход изглежда достатъчно прост и удобен, но противоречи на работата по договора. Тоест, има един компонент с предварително зададена схема на работа. Разработчикът го реализира в съответствие с тази схема и задачата, компонентът преминава тестиране, клиентът получава продукт, който отговаря на концепцията на аналитика. Реверс-инжиниринг обаче пуска на пазара продукт, който просто съществува: с особености, странни решения и "велосипеди" вместо необходимия функционал.
- Целият поток от заявки, които идваха през API, можеше да бъде анализиран максимум като лог на Nginx или application server. Това не позволяваше да се отделят предметните области, освен може би да се раздели по потребители и абонати. Ако няма възможност за регулиране на регистрацията на приложението или клиентите, анализът на ситуацията става невъзможен. Този проблем в най-малка степен повлия на развитието на API, той е повече свързан с разбирането на търсенето му и наличието на функционалност.
Опит номер две: REST API
През 2010 година се опитахме да изградим система за обмен с онлайн счетоводство — БухСофт. Не успяхме. Въпреки това, по време на интеграцията се появи напълно функционален API: REST услуга за обмен, в която отсъстваха свободи като извиквания на операции под формата на RPC. Цялата комуникация с API беше приведена в стандартния за REST режим: в заявката се съдържа името на съществото, а операцията, която се извършва с него, се указва с помощта на http метод. Добавихме филтриране по време на актуализация на съществата, като така потребителите получиха възможност за изграждане на репликация със собствените си системи.
Същата година се появи API за извличане на складови и продуктови наличности. Чрез API на потребителите станаха достъпни най-ценните части на системата — обмен на първични документи и числови данни относно остатъците и себестойността на стоките.
През декември 2015 година RetailCRM публикува първата външна библиотека за достъп до нашия API. Тя стана доста активно използвана, като същевременно нарастваше популярността на услугата като цяло, а натоварването на API растеше по-бързо от натоварването на уеб интерфейса. Един ден ръстът се превърна в скок на натоварването.
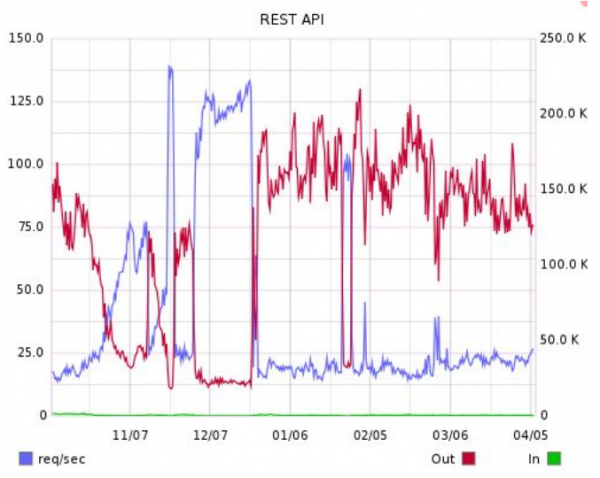
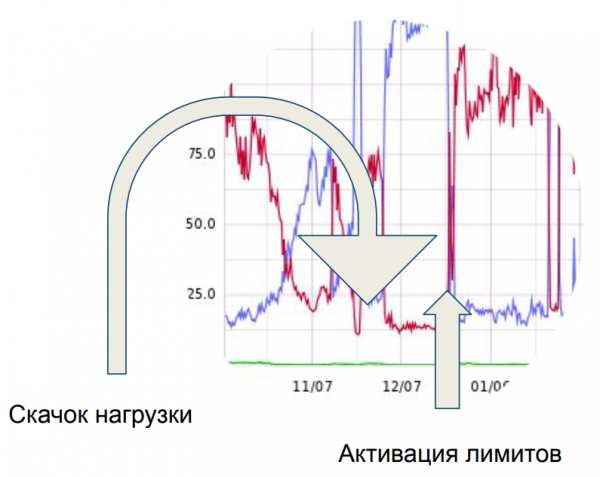
И този скок, на който показва стрелката наляво, доведе до пълно учудване на сървъра, обслужващ нашия API. Цяла седмица се опитвахме да разберем какво точно генерира тази натовареност. Оказа се, че това са именно тези заявки, предавани на нашия API от фронтовете на клиентите. Всичко беше генерирано от около 50 клиенти. Тук осъзнахме една от нашите грешки — пълното отсъствие на лимити.
В крайна сметка въведохме лимит на броя на едновременните заявки. От единичен акаунт вече можеше да се отворят не повече от две заявки едновременно. Това е достатъчно за работа в режим на репликация за обмен на данни в пакетен режим. А тези, които искат да ни използват като бекенд, от този момент нататък бяха принудени да отговарят на тарифите, тъй като въведоха работа с няколко акаунта в своите софтуерни средства.
Привеждаме в ред
Вече от 2014 година търсенето на съществуващия API стана важна част от бизнеса, а самият API генерираше най-голям обем данни в обмена с клиентите. През 2015 година стартирахме проекта за организиране на API. Избрахме формата JSON вместо XML и започнахме да го изграждаме на базата на особеностите, които разбрахме при реализирането на предишната версия:
- Възможност за управление на версиите. Версионирането позволява разработването на нова версия без засягане на съществуващото приложение и без нарушение на работата на потребителите.
- Възможност за потребителя да вижда метаданни в самия отговор, който получава.
- Възможност за обмен на големи документи. Ако обработваме документ с повече от 4-5 хиляди позиции, това става проблем за сървъра: дълга транзакция, дълга http-заявка. Изградихме специален механизъм, позволяващ обновяване на документа на части и управление на отделни позиции от този документ, изпращайки ги на сървера.
- Инструменти за репликация — имаше и в предишната версия.
- Ограничения по натоварването — като наследство от грешките, направени в предишната версия. Въведохме ограничения на броя на заявките в определен интервал от време, броя на паралелните заявки и заявките от един IP адрес.
Оттогава издадохме две минорни версии на API и стартирахме няколко специализирани API, но общият подход остана без промяна. Обновеният формат на обмена и новата архитектура позволиха да се поправят недостатъците в API много по-бързо.
API на МояСклад днес
Днес API на МояСклад решава много задачи:
- обмен на данни с интернет-магазини, счетоводни системи, банки;
- получаване на изчислителни данни, отчети;
- използване като бекенд за клиентски приложения — нашите мобилни приложения и десктоп каса работят чрез API
- изпращане на уведомления за промени в данните в МояСклад — webhooks;
- телефония;
- системи за лоялност.
На базата на API нашият генерален директор Аскар Рахимбердиев за четири часа написа телеграм-бот, който извлича чрез API наличности:
Сега сухите цифри.
Ето нашата статистика по стария REST API:
- 400 компании;
- 600 потребители;
- 2 милиона заявки на ден;
- 200 Гб/ден изходящ трафик.
А ето до какво стигнахме по всички API на МояСклад:
- над 70 интеграции (част от тях можете да видите тук );
- 8500 компании;
- 12000 потребители;
- 46 милиона заявки на ден;
- 2 Тб/ден изходящ трафик.
Какво следва
Плановете за развитие на API в активно обсъждане. Стремим се да вземем предвид опита от експлоатация, който ни предоставят потребителите. Не винаги и не всичко може да се направи веднага, но новата версия на API с по-удобни метаданни и по-малко сложна структура, OAuth за удостоверяване и API за вграждане в интерфейси на приложения е близо.
Може да следите новините на специален сайт за разработчици на интеграции с МоимСкладом: .
Източник: habr.com
