

Наскоро разказах как да се увеличи производителността на SQL заявките за четене може да направим записите в базата данни по-ефективни без да използваме каквито и да било 'крутилки' в конфигурацията — просто чрез добра организация на потоците данни. Статията за това как и защо трябва да се организира
#1. Секционирование
прикладното секциониране 'в теорията' сервиз за мониторинг на стотици PostgreSQL сървъри .
Първоначално, както всеки MVP, нашият проект стартира при сравнително малко натоварване — мониторингът беше само за десетина най-критични сървъра, като всички таблици бяха относително компактни… Но времето минаваше, проследяваните хостове ставаха все повече, и опитвайки се отново да направим нещо с една от
таблиците размер 1.5TB , осъзнахме, че така да живеем е възможно, но много неудобно.Времената бяха почти легендарни, актуални бяха различни версии на PostgreSQL 9.x, така че всичкото секциониране се наложи да бъде направлено 'на ръка' — чрез
наследяване на таблици и тригери за рутинга с динамични Полученото решение се оказа достатъчно универсално, за да може да бъде променяно за всичките таблици: EXECUTE.
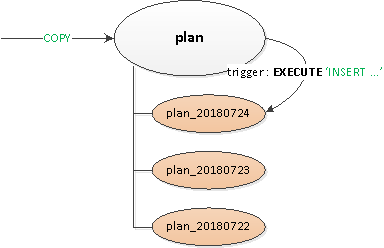
Обявена беше празна 'заглавна' родителска таблица, на която бяха описани всички
- необходими индекси и тригери Записът от гледна точка на клиента се извършваше в 'коренната' таблица, а вътре чрез.
- тригера за рутинга BEFORE INSERT
записът 'физически' се вмъкваше в нужния сектор. Ако такъв все още нямаше — улавяхме изключение и …… с помощта на - CREATE TABLE ... (LIKE ... INCLUDING ...) сектор с ограничение за необходимата дата , за да се осигури, че при извличането на данни четенето става само в него.PG10: първоначален опит
Но секционирането чрез наследяване исторически не беше много подходящо за работа с активен поток на запис или голям брой наследници. Например, можем да си спомним, че алгоритъмът за избор на нужния сектор имаше
квадратна сложност , което при 100+ секции работи, сами разбирате как...В PG10 тази ситуация беше значително оптимизирана, реализирайки поддръжка за
нативно секциониране . Затова се опитахме да го приложим веднага след миграцията на хранилището, но…
Както се оказа след изучаване на ръководството, нативно секционираната таблица в тази версия:
- не поддържа описания на индекси
- не поддържа тригери на нея
- не може да бъде „потомък“ на никого
- не поддържа
INSERT ... ON CONFLICT - не може автоматично да генерира секции
След като получихме удари по главата, осъзнахме, че без модификация на приложението няма да минем и отложихме по-нататъшните изследвания за шест месеца.
PG10: втори шанс
И така, започнахме да решаваме възникналите проблеми по ред:
- Тъй като тригерите и
ON CONFLICTсе оказаха на места необходими, направихме междинна прокси-таблица. - Освободихме се от „рутинга“ в тригерите — т.е. от
EXECUTE. - Изнесохме отделно таблицата-шаблон с всички индекси, за да не присъстват дори на прокси-таблицата.
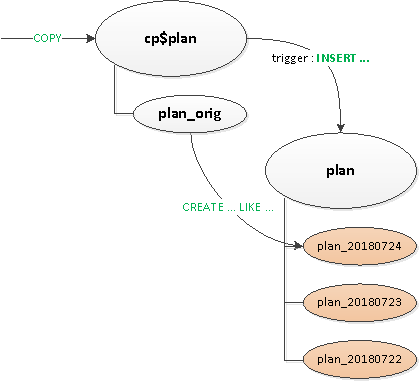
Накрая, след всичко това, нативно секционирахме основната таблица. Създаването на нова секция засега остана на съвестта на приложението.
„Режем“ речниците
Както в всяка аналитична система, при нас също имаше „факти“ и „разрези“ (речници). В нашия случай, в това качество бяха, например, еднотипни бавни заявки или самия текст на заявката.
„Фактите“ ни бяха секционирани по дни отдавна, затова спокойно премахвахме остарелите секции и те не ни пречеха (все пак бяха логовете!). Но с речниците се получи беда…
Не бих казал, че имаше много, но около на 100TB „факти“ се получи речник от 2.5TB. От такава таблица е удобно нищо да не се премахва, не може да се компресира за нормално време, а записите в нея постепенно ставаха все по-бавни.
Речникът… всяка записи е представена точно веднъж… и това е вярно, но!.. Никой не пречи да имаме по отделен речник за всеки ден! Да, това носи определена излишност, но позволява:
- по-бързо писане/четене заради по-малкия размер на секцията
- да консумира по-малко памет заради работа с по-компактни индекси
- да съхранява по-малко данни заради възможността за бързо премахване на остарели
В резултат на целия комплекс от дейности натоварването по CPU се намали с около 30%, а по диска — с около 50%:
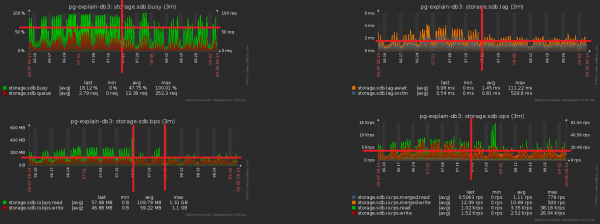
При това продължихме да записваме в базата точно същото, просто с по-малко натоварване.
#2. Эволюция и рефакторинг БД
Така, спряхме на това, че имаме за всеки ден своя секция с данни. Всъщност, CHECK (dt = '2018-10-12'::date) — и това е ключът за секциониране и условието да се попадне на записа в конкретна секция.
Тъй като всички отчети в нашия сервис се изграждат в разрез на конкретна дата, то и индексите, още от "несеционираните времена", бяха все от типа (Сървър, Дата, Шаблон на плана), (Сървър, Дата, Възел на плана), (Дата, Клас на грешката, Сървър),…
Но сега на всяка секция живеят своите инстанции на всеки такъв индекс… И в рамките на всяка секция датата е константа… Излиза, че сега записваме в всеки такъв индекс банално константа като едно от полетата, което увеличава както обема му, така и времето за търсене по него, но не носи никакъв резултат. Сами си оставихме капани, упс…
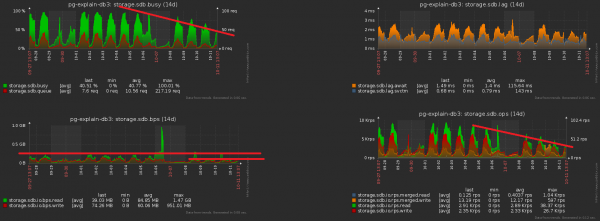
Посоката на оптимизация е очевидна — просто премахваме полето с датата от всички индекси в секционираните таблици. При нашите обеми спестяването е около 1TB/седмица!
А сега нека забележим, че този терабайт все пак трябваше да бъде записан. Тоест, плюс това и дискът също трябва да се натоварва по-малко! На тази картинка е добре видим получените ефекти от извършеното почистване, на което посветихме седмица:
#3. «Размазываем» пиковую нагрузку
Една от големите бедствия на натоварените системи — това е излишната синхронизация на операции, които не я изискват. Понякога "защото не забелязаха", понякога "така беше по-лесно", но рано или късно трябва да се освободим от нея.
Приближаваме предишната картинка — и виждаме, че дискът ни "вдига" натоварването с двукратна амплитуда между съседни измервания, което явно "статистически" не би трябвало да е така при такова количество операции:
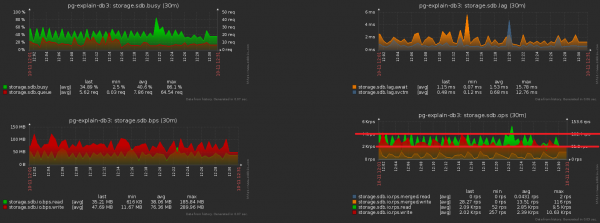
Да постигнем това е достатъчно просто. На мониторинг бяха записани вече почти 1000 сървъра, всеки се обработва от отделен логически поток, а всеки поток изпраща натрупаната информация за изпращане в базата с определена периодичност, приблизително така:
setInterval(sendToDB, interval)Проблемата тук произтича точно от това, че всички потоци стартират приблизително по едно и също време, затова моментите на изпращане почти винаги съвпадат "до точка". Упс №2…
Щастие, че е лесно да се коригира, чрез добавяне на "случайно" разминаване по време:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Третият традиционен проблем на highload — отсъствието на кеш там, където трябва могъл да .
Например, ние направихме възможността за анализ по разрез на плановите възли (всички тези Seq Scan на потребители), но веднага да помислим, че те, в масата, са еднакви — забравихме.
Не, разбира се, в базата нищо не се записва повторно, това отрязва тригера с INSERT ... ON CONFLICT DO NOTHING. Но до базата тези данни все пак достигат, да не говорим за излишното четене за проверка на конфликта което трябва да се прави. Упс №3…
Разликата в броя на записите, изпратени в базата преди/след активирането на кеширането — е очевидна:
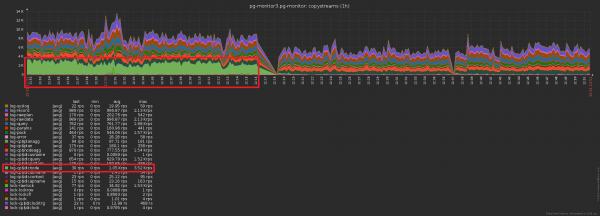
А това е съпътстващо намаление на натоварването на хранилището:
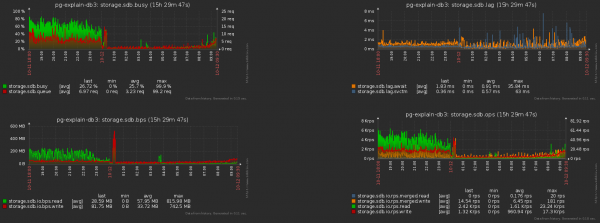
Общо
«Терабайт на ден» само звучи страшно. Ако всичко правите правилно, това е всъщност 2^40 байта / 86400 секунди = ~12.5MB/s, което дори настолните IDE-дискове можеха да поддържат. 🙂
А ако бъдем сериозни, дори при десетократен «перекос» в натоварването в рамките на денонощие, спокойно можете да се впишете в възможностите на съвременните SSD.
Източник: habr.com
