

Стандарт ASCII е приет през 1963 г. и в момента едва ли някой използва кодировка, чийто първи 128 символа да се различават от ASCII. Въпреки това, до края на миналия век активно се използваше EBCDIC — стандартна кодировка за мейнфреймове IBM и техните съветски клонинг ЕС ЕВМ. EBCDIC остава основна кодировка в z/OS — стандартна ОС за съвременни мейнфреймове IBM Z.
Това, което веднага прави впечатление при поглед на EBCDIC, е, че буквите не са подредени последователно: между I и J и между R и S остават неизползвани позиции (на ЕС ЕВМ по тези промеждутъци символи на кирилица). Кому ли би дошло на ум да кодира букви с неравни разстояния между съседните букви?
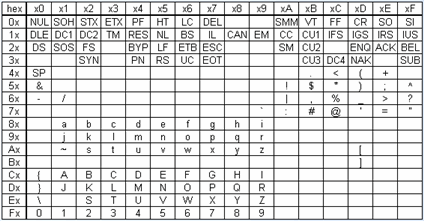
Самото наименование EBCDIC («Extended BCDIC») намеква, че тази кодировка — за разлика от ASCII — не е създадена на празно място, а на базата на шестобитната кодировка BCDIC, която се е използвала от (1954):
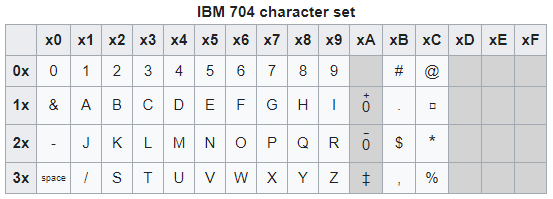
Няма непосредствена обратна съвместимост: удобна черта на BCDIC, загубена при прехода към EBCDIC, беше, че на цифрите 0—9 съответстват кодове 0-9. Въпреки това, разривите от седем кода между I и J и осем кода между R и S в BCDIC вече съществуваха. Как се появиха?
Историята на (E)BCDIC започва едновременно с историята на IBM — дълго преди електронните компютри. IBM е образувана в резултат на сливането на четири компании, от които най-технологично напреднала е била «Tabulating Machine Company», основана през 1896 г. от Херман Холерит — изобретателя на . Първоначалните табулатори просто брояха количеството перфокарти, пробити на определено място; но през 1905 г. Холерит започва производство на десетични табулатори. Всяка карта за десетичен табулатор се състои от полета с произволна дължина, а числата, записани в тези полета в обичаен десетичен формат, се сумират през цялата колода. Разпределението на картата на полета се задава чрез свързване на проводници на комутационната платка на табулатора. Например, на тази перфокарта на Холерит, в Библиотеката на Конгреса, очевидно е набито числото 23456789012345678, неизвестно как разделено на полета:
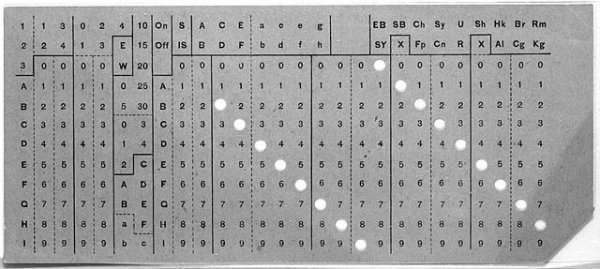
Най-внимателните биха могли да забележат, че на картата на Холерит има 12 реда за отвори, въпреки че за цифрите са достатъчни десет; а в BCDIC за всяка стойност на старшите два бита се използват само 12 кода от 16 възможни.
Разбира се, това не е случайно съвпадение. Първоначално Холерит е предвидил допълнителни редове за „специални отметки“, които не се сумират, а просто се броят – както в най-ранните табулатори. (Днес бихме ги нарекли „битови полета“.) Освен това, сред „специалните отметки“ можеше да се зададат групови индикатори: ако при табулиране бяха необходими не само окончателни суми, но и междинни, табулаторът спираше, когато откриваше промяна на който и да е от груповите индикатори, и операторът трябваше да запише междинните суми от цифровите дисплеи на хартия, да нулира дисплея и да възобнови табулирането. Например, при изчисляване на счетоводни баланси, група карти може да отговаря на дата или контрагент.
Към 1920 г., когато Холерит вече е в пенсионна възраст, в употреба навлязоха „печатящи табулатори“, които се свързваха с телетайп и можеха сами да печатат междинни суми, без да изискват намеса от оператора. Сложността вече се състоеше в това, да се определи към какво се отнася всяко от напечатаните числа. През 1931 г. IBM решава да обозначава буквите с „специални отметки“: отметката в 12-ти ред означаваше буквата от A до I, в 11-ти — от J до R, в нулевия — от S до Z. Новият „алфавитен табулатор“ можеше да печата името на всяка група карти заедно с междинните суми; при това непробитият стълб се превръщаше в интервал между символите. Обърнете внимание, че S се обозначава с комбинация от отвори 0+2, а комбинацията 0+1 първоначално не се използваше от страх, че два отвора един до друг в един стълб могат да предизвикат механични проблеми в четеца.
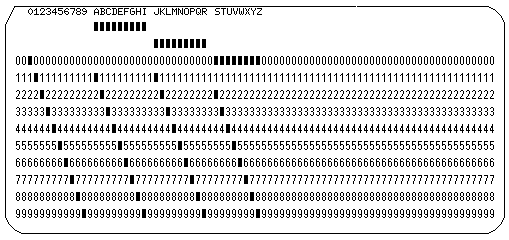
Сега на таблицата BCDIC можем да погледнем малко от другата страна:
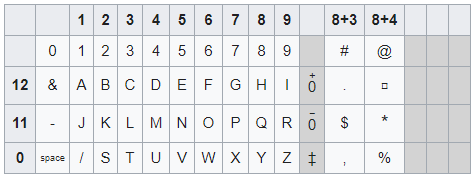
С изключение на това, че 0 и интервалът са разменени местата, старшите два бита определят „специалната отметка“, която от 1931 г. се пробива в перфокартата за съответния символ; а младшите четири бита определят числото, което се пробива в основната част на картата. Поддръжката на символи & - / добави се в табулатори на IBM през 30-те години и кодирането на тези символи в BCDIC съответства на пробиванията за тях. Когато стана необходимо поддръжка на още по-голям брой символи, в качеството на допълнителна „специална отметка“ започнаха да пробиват ред 8 — по този начин, в една колона можеше да има до три пробивания. Този формат на перфокартите остана почти непроменен до края на века. В СССР оставиха IBM-овските кодировки на латиницата и пунктуацията, а за буквите на кирилицата пробиваха веднага по няколко „специални отметки“ в редове 12, 11, 0 — без да се ограничават до три пробивания в една колона.
Когато се създаваше компютърът IBM 704, за кодиране на символите не се мислеше дълго: взеха кодировката, която вече се използваше в перфокартите, и само 0 „поставиха на мястото си“. През 1964, при прехода от BCDIC към EBCDIC, младшите четири бита на всеки символ оставиха без промяна, въпреки че малко разместват старшите на битове. Така форматът на перфокартите, избран от Холлерит в началото на миналия век, оказа влияние върху архитектурата на всички компютри на IBM, включително IBM Z.
Източник: habr.com
