

Здравей, Хабър! Представям ви превод на статия авторов Burak Yavuz, Brenner Heintz и Denny Lee, который был подготовлен в преддверии старта курса от OTUS.
Данните, както и нашият опит, постоянно се натрупват и развиват. За да не изоставаме, нашите ментални модели на света трябва да се адаптират към новите данни, част от които съдържат нови измерения - нови начини да наблюдаваме неща, за които преди това не сме имали представа. Тези ментални модели не се различават много от схемите на таблиците, които определят как класифицираме и обработваме нова информация.
Това ни води до въпроса за управлението на схемите. С времето бизнес задачите и изискванията се променят, а с тях и структурата на вашите данни. Delta Lake позволява лесно внедряване на нови измерения при промяна на данните. Потребителите имат достъп до проста семантика за управление на схемите на своите таблици. Тези инструменти включват принудително прилагане на схемата (Schema Enforcement), което защитава потребителите от неволно замърсяване на таблиците с грешки или ненужни данни, както и еволюция на схемата (Schema Evolution), която позволява автоматично добавяне на нови колони с ценни данни на съответните места. В тази статия ще се задълбочим в използването на тези инструменти.
Разбиране на схемите на таблиците
Всеки DataFrame в Apache Spark съдържа схема, която определя формата на данните, като типове данни, колони и метаданни. С Delta Lake схемата на таблицата се запазва във формат JSON в записа на транзакциите.
Какво представлява принудителното прилагане на схемата?
Принудителното прилагане на схемата (Schema Enforcement), известно също като проверка на схемата (Schema Validation), е защитен механизъм в Delta Lake, който гарантира качеството на данните, отхвърляйки записи, които не съответстват на схемата на таблицата. Подобно на хостес на рецепцията в популярен ресторант, който приема само с предварителни резервации, той проверява дали всеки стълб данни, въвеждан в таблицата, е в съответния списък с очаквани стълбове (с други думи, дали за всеки от тях има „резервация“) и отхвърля всякакви записи, които не са в списъка.
Как работи принудителното прилагане на схемата?
Delta Lake използва проверка на схема при запис, което означава, че всички нови записи в таблицата се проверяват за съвместимост със схемата на целевата таблица по време на записа. Ако схемата не е съвместима, Delta Lake напълно отменя транзакцията (данните не се записват) и създава изключение, за да уведоми потребителя за несъответствието.
За определяне на съвместимостта на записа с таблицата Delta Lake използва следните правила. Записаният DataFrame:
- не може да съдържа допълнителни колони, които не са в схемата на целевата таблица. И обратно, всичко е наред, ако входящите данни не съдържат абсолютно всички колони от таблицата — на тези колони просто ще бъдат зададени нулеви стойности.
- не може да има типове данни на колоните, които се различават от типовете данни на колоните в целевата таблица. Ако колоната на целевата таблица съдържа данни от тип StringType, но съответстващата колона в DataFrame съдържа данни от тип IntegerType, принудителното прилагане на схемата ще предизвика изключение и ще предотврати изпълнението на операцията по запис.
- не може да съдържа имена на колони, които се различават само по регистър. Това означава, че не можете да имате колони с имена ‘Foo’ и ‘foo’, дефинирани в една и съща таблица. Въпреки че Spark може да се използва в режим, чувствителен или нечувствителен (по подразбиране) към регистъра, Delta Lake запазва регистъра, но е нечувствителен в рамките на съхранението на схемата. Parquet е чувствителен към регистъра при съхранение и връщане на информация за колоната. За да се избегнат възможни грешки, повреждане на данни или загуба на данни (с което ние лично сме се сблъсквали в Databricks), решихме да добавим това ограничение.
За да илюстрираме това, нека погледнем какво се случва в предоставения по-долу код при опит за добавяне на някои наскоро генерирани колони в таблица Delta Lake, която все още не е настроена да ги приема.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Вместо автоматично да добавя нови колони, Delta Lake налага схемата и спира записа. За да помогне да се определи коя колона (или множество от тях) е причина за несъответствието, Spark извежда и двете схеми от стека за сравнение.
Каква е ползата от принудителното прилагане на схемата?
Тъй като принудителното прилагане на схемата представлява доста строга проверка, то е отличен инструмент за използване като портиер на чист, напълно трансформиран набор от данни, готов за производство или консумация. Обикновено се прилага към таблици, които директно подават данни:
- Алгоритмите за машинно обучение
- BI табла
- Анализ на данни и инструменти за визуализация
- Всяка производствена система, изискваща строго структурирани, строго типизирани семантични схеми.
За да подготвите данните си за този финален бариера, много потребители използват проста архитектура "multi-hop", която постепенно внася структура в таблиците им. За да научите повече за това, можете да се запознаете със статията
Разбира се, принудителното прилагане на схемата може да се използва навсякъде в процеса ви, но помнете, че потоковият запис в таблицата в такъв случай може да бъде фрустриращ, тъй като, например, сте забравили, че сте добавили още една колона в входящите данни.
Предотвратяване на разреждане на данните
До този момент може да се запитате, защо такова вълнение? В крайна сметка, понякога неочакваната грешка „несъответствие на схемата“ може да ви подложи на дразнене в работния процес, особено ако сте новатор в Delta Lake. Защо просто не позволяваш на схемата да се промени така, както е необходимо, за да мога да запиша своя DataFrame, независимо от всичко?
Както казва старата поговорка, "унция превенция струва фунт лечение". На някакъв етап, ако не се погрижите за приложението на схемата си, ще се повдигнат отвратителни проблеми с съвместимостта на типове данни — на пръв поглед хомогенни източници на необработени данни могат да съдържат гранични случаи, повредени колони, неправилно оформени отображения или други страшни неща, които се сънуват в нощните ви страхове. Най-добрият подход е да спрете тези врагове на портата — с принудителното прилагане на схемата — и да се справите с тях на светло, а не по-късно, когато започнат да се скитат в тъмните дълбини на вашия работен код.
Задължителното прилагане на схемата дава увереност, че схемата на вашата таблица няма да се промени, освен ако вие сами не одобрите варианти на промяна. Това предотвратява "разреждане" (dilution) на данните, което може да се случи, когато нови колони се добавят толкова често, че преди това ценните, компресирани таблици губят значението и полезността си заради наводнението от данни. Насърчавайки ви да бъдете целенасочени, да установявате високи стандарти и да очаквате високо качество, задължителното прилагане на схемата върши точно това, за което е предназначено - да ви помага да останете добросъвестни, а вашите таблици - чисти.
Ако при по-нататъшното разглеждане решите, че всъщност им е необходимо искате да добавите нова колона - без проблем, по-долу е едноредовото решение. Решението е еволюция на схемата!
Какво е еволюция на схемата?
Еволюцията на схемата е функция, която позволява на потребителите лесно да променят текущата схема на таблицата в съответствие с променящите се данни с времето. Най-често се използва при извършване на операция по добавяне или презапис, за да автоматично се адаптира схемата да включва една или няколко нови колони.
Как работи еволюцията на схемата?
Следвайки примера от предишния раздел, разработчиците могат лесно да използват еволюцията на схемата за добавяне на нови колони, които преди са били отхвърляни поради несъответствие с схемата. Еволюцията на схемата се активира чрез добавяне на .option('mergeSchema', 'true') к вашата Spark команда .write или .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
За да видите графика, изпълнете следния Spark SQL заявка
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 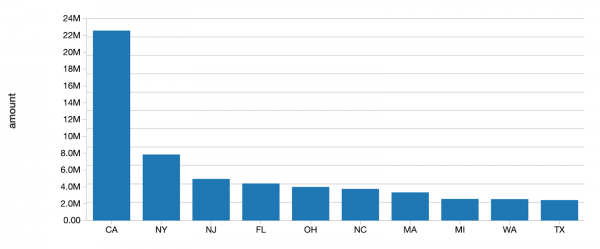
Като алтернатива, можете да зададете тази опция за сесията на Spark, като добавите spark.databricks.delta.schema.autoMerge = True в конфигурацията на Spark. Но бъдете внимателни, тъй като задължителното прилагане на схемата вече няма да ви предупреждава за непреднамерени несъответствия със схемата.
Включвайки параметъра в заявката mergeSchema, всички колони, които присъстват в DataFrame, но липсват в целевата таблица, автоматично се добавят в края на схемата в рамките на транзакцията на запис. Също така могат да бъдат добавени вложени полета, и те също ще бъдат добавени в края на съответстващите колони на структурата.
Датата инженерите и учените могат да използват тази опция, за да добавят нови колони (възможно, ново проследявана метрика или колона за продажби за този месец) в своите съществуващи производствени таблици за машинно обучение, без да нарушават съществуващите модели, базирани на стари колони.
Следните типове промени в схемата са допустими в рамките на еволюцията на схемата при добавяне или презаписване на таблица:
- Добавяне на нови колони (това е най-разпространеният сценарий)
- Промяна на типове данни от NullType -> всеки друг тип или ъпгрейд от ByteType -> ShortType -> IntegerType
Други промени, недопустими в рамките на еволюцията на схемата, изискват схемата и данните да бъдат презаписани чрез добавяне .option("overwriteSchema", "true"). Например, в случай, че колоната "Foo" първоначално е била integer, а новата схема е стринг, тогава всички файлове Parquet (данни) трябва да бъдат презаписани. Към тези промени спада:
- изтриване на колона
- промяна на типа данни на съществуваща колона (на място)
- преименуване на колони, които се различават само по регистър (например "Foo" и "foo")
Накрая, с предстоящото издание на Spark 3.0, ще бъде напълно поддържан явен DDL (чрез използване на ALTER TABLE), което ще позволи на потребителите да извършват следните действия върху схемите на таблиците:
- добавяне на колони
- промяна на коментарите към колоните
- настройка на свойства на таблицата, които определят поведението ѝ, например, задаване на продължителност на съхранение на журнала за транзакции.
Каква е ползата от еволюцията на схемата?
Еволюцията на схемата може да бъде използвана всеки път, когато намирявате да промените схемата на таблицата си (в противовес на случаите, когато случайно сте добавили колони в DataFrame, които не трябва да присъстват там). Това е най-простият начин да мигрирате схемата си, тъй като автоматично добавя правилните имена на колоните и типове данни, без необходимост от тяхното явяване.
Заключение
Принудителното прилагане на схемата отхвърля всякакви нови колони или други промени в схемата, които не са съвместими с вашата таблица. Чрез установяване и поддържане на тези високи стандарти, анализаторите и инженерите могат да разчитат на това, че техните данни имат най-високо ниво на целостност, разсъждавайки за това ясно и отчетливо, което им позволява да вземат по-ефективни бизнес решения.
От друга страна, еволюцията на схемата допълва принудителното прилагане, опростявайки предполагаемите автоматични промени в схемата. В крайна сметка, това не трябва да бъде усложнение — добавянето на колона.
Принудителното прилагане на схемата е янь, където еволюцията на схемата е Ин. При съвместно използване, тези функции както никога не опростяват потискането на шума и настройването на сигнала.
Също така, бихме искали да благодарим на Мукула Мурти и Пранава Ананда за техния принос в тази статия.
Други статии от тази серия:
Статии по темата
Източник: habr.com
