

TL;DR: Преди четири години напуснах Google с идеята за нов инструмент за мониторинг на сървъри. Идеята беше да обединя в една услуга обикновено изолирани функции и анализ на логове, събиране на метрики, и табло за мониторинг. Един от принципите е, че услугата трябва да бъде наистина бърза, осигурявайки на девопсите лесна, интерактивна, приятна работа. Това изисква обработка на набори от данни с размери в гигабайти за части от секундата, без да излизаме извън бюджета. Съществуващите инструменти за работа с логове често са бавни и тромави, затова предизвикателството пред нас беше: умело да разработим инструмент, който да осигури на потребителите нови усещания от работата.
В тази статия се описва как в Scalyr решихме този проблем, прилагайки методи от старата школа, груб подход, премахвайки излишни слоеве и избягвайки сложни структури от данни. Тези уроци можете да приложите към собствените си инженерни задачи.
Силата на старата школа
Анализът на логове обикновено започва с търсене: намиране на всички съобщения, отговарящи на определен шаблон. В Scalyr това са десетки или стотици гигабайти логове от много сървъри. Съвременните подходи обикновено предполагат изграждане на някаква сложна структура от данни, оптимизирана за търсене. Аз, разбира се, съм виждал такова нещо в Google, където те са доста добри в тези неща. Но ние избрахме много по-груб подход: линейно сканиране на логовете. И това проработи — осигуряваме интерфейс с търсене, който е с порядък по-бърз от този на конкурентите (вж. анимацията в края).
Ключовото прозрение беше, че съвременните процесори наистина са много бързи в простите, директни операции. Това лесно може да се пропусне в сложни, многослойни системи, които разчитат на скоростта на I/O и мрежовите операции, а такива системи днес са много разпространени. Така че проектирахме дизайн, който минимизира броя на слоевете и излишния шум. С няколко процесора и сървъри паралелно, скоростта на търсене достига 1 ТБ в секунда.
Ключови изводи от тази статия:
- Грубото търсене е напълно жизнеспособен подход за решаване на реални, мащабни проблеми.
- Грубата сила е техника на проектиране, а не освобождаване от работа. Както всяка техника, тя е по-подходяща за едни проблеми, отколкото за други и може да бъде реализирана лошо или добре.
- Грубата сила е особено ефективна за постигане на фаза) решение е производителност.
- Ефективното използване на грубата сила изисква оптимизация на кода и навременно прилагане на достатъчно ресурси. Това е подходящо, ако вашите сървъри са под голямо натоварване, несвързано с потребители, а оперативните действия на потребителите остават приоритет.
- Производителността зависи от дизайна на цялата система, а не само от алгоритъма на вътрешния цикъл.
(В тази статия се описва търсене на данни в паметта. В повечето случаи, когато потребителят търси в логовете, сървърите на Scalyr вече са ги кеширали. В следващата статия ще обсъдим търсенето в некеширани логове. Прилаганите принципи са същите: ефективен код, метод на грубата сила с големи изчислителни ресурси).
Метод на грубата сила
Традиционно, търсенето в голям набор от данни се извършва по индекс на ключови думи. По отношение на сървърните логове, това означава търсене на всяка уникална дума в журнала. За всяка дума трябва да се състави списък на всички включвания. Това позволява лесно да се намерят всички съобщения с тази дума, например 'error', 'firefox' или 'transaction_16851951' — просто поглеждаме в индекса.
Използвал съм такъв подход в Google и той работеше добре. Но в Scalyr търсим в логовете байт след байт.
Защо? От абстрактна алгоритмична гледна точка индекси на ключови думи са много по-ефективни от грубото търсене. Все пак ние не продаваме алгоритми, ние продаваме производителност. А производителността не е само алгоритми, а и системна инженерия. Трябва да вземем предвид всичко: обем на данните, тип търсене, налично оборудване и софтуерен контекст. Решихме, че за нашия конкретен проблем вариант като 'grep' е по-подходящ от индекс.
Индексите са отлични, но имат ограничения. Лесно е да се намери една дума. Но търсенето на съобщения с няколко думи, като 'googlebot' и '404', е вече много по-сложно. Търсенето на фраза като 'uncaught exception' изисква по-обемен индекс, който регистрира не само всички съобщения с тази дума, но и конкретното местоположение на думата.
Настоящата трудност възниква, когато търсите не думи. Да предположим, че искате да видите колко трафик идва от ботове. Първата мисъл е търсене в логовете по думата ‘bot’. Така ще откриете някои ботове: Googlebot, Bingbot и много други. Но тук ‘bot’ е част от дума, а не самата дума. Ако търсите ‘bot’ в индекса, няма да намерите съобщенията със словосъчетанието ‘Googlebot’. Ако проверявате всяка дума в индекса и след това сканирате индекса по намерените ключови думи, търсенето ще се забави значително. В резултат на това някои програми за работа с логове не позволяват търсене по части от дума или (в най-добрия случай) позволяват използването на специален синтаксис с по-ниска производителност. Ние искаме да избегнем това.
Още един проблем – пунктуацията. Искате да намерите всички заявки от 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Накрая, инженерите обичат мощни инструменти, а понякога проблемът може да бъде решен само с регулярни изрази. Индексът на ключовите думи не е много подходящ за това.
Освен това, индексите са сложни. Всяко съобщение трябва да се добави в няколко списъка на ключови думи. Тези списъци трябва постоянно да се поддържат в удобен за търсене формат. Заявките с фрази, фрагменти от думи или регулярни изрази трябва да се превеждат в операции с множество списъци, а резултатите да се сканират и обединяват за получаване на крайния набор. В контекста на мащабна многофункционална услуга такава сложност създава проблеми с производителността, които не са видими при анализа на алгоритмите.
Индексите на ключовите думи също заемат много място, а хранилището е основен разход в системата за управление на логовете.
От друга страна, всеки търсене може да изисква много изчислителна мощ. Нашите потребители ценят бързото търсене по уникални запитвания, но такива запитвания се правят сравнително рядко. За типични търсения, например, за мониторинг панела, прилагаме специални техники (ще ги опишем в следващата статия). Други запитвания са достатъчно редки, така че рядко се налага да обработваме повече от едно наведнъж. Но това не означава, че нашите сървъри не са заети: те са натоварени с работа по приемане, анализиране и компресиране на нови съобщения, оценка на уведомления, компресиране на стари данни и така нататък. Така че имаме доста значителен резерв от процесори, които можем да използваме за извършване на запитвания.
Грубата сила работи, ако имате груб проблем (и много сила)
Грубата сила най-добре работи при прости задачи с малки вътрешни цикли. Често можете да оптимизирате вътрешния цикъл да работи с много високи скорости. Ако кодът е сложен, значително по-трудно е да го оптимизирате.
Първоначално в нашия код за търсене имаше доста голям вътрешен цикъл. Съхраняваме съобщения на страници по 4K; всяка страница съдържа няколко съобщения (в UTF-8) и метаданни за всяко съобщение. Метаданните са структура, в която са кодирани дължината на стойността, вътрешния ID на съобщението и други полета. Цикълът за търсене изглеждаше така:
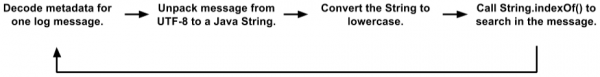
Това е опростен вариант в сравнение с фактическия код. Но дори и тук се виждат няколко разположения на обекти, копия на данни и извиквания на функции. JVM доста добре оптимизира извикванията на функции и разпределя еферни обекти, така че този код работеше по-добре, отколкото заслужавахме. По време на тестовете клиентите доста успешно го използваха. Но накрая преминахме на ново ниво.
(Можете да се запитате защо съхраняваме съобщения в такъв формат с 4K страници, текст и метаданни, а не работим директно с логове. Има много причини, които се свеждат до това, че вътрешно движението Scalyr по-скоро прилича на разпределена база данни, отколкото на файлова система. Текстовото търсене често се комбинира с филтри в стил СУБД на полета след парсинг на логовете. Можем едновременно да търсим в много хиляди логове, а обикновените текстови файлове не са подходящи за нашето транзакционно, реплицирано, разпределено управление на данни).
Първоначално изглеждаше, че такъв код не е много подходящ за оптимизация по метода на грубата сила. "Истинската работа" в String.indexOf() дори не доминираше в профила на CPU. Тоест, оптимизацията само на този метод няма да доведе до съществени ефекти.
Случи се, че съхраняваме метаданни в началото на всяка страница, а текстът на всички съобщения в UTF-8 е опакован в другия край. Използвайки това, пренаписахме цикъла за търсене да работи изцяло на страницата:
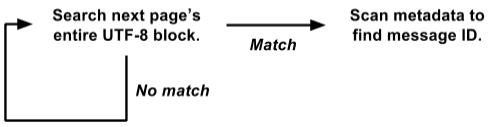
Тази версия работи директно на представяне raw byte[] и извършва търсене на всички съобщения веднага на цялата страница 4K.
Това е много по-лесно за оптимизиране за метода на грубата сила. Вътрешният търсещ цикъл се извиква едновременно за цялата страница 4K, а не отделно за всяко съобщение. Няма копиране на данни, нито разпределение на обекти. И по-сложните операции с метаданни се извикват само при положителен резултат, а не за всяко съобщение. По този начин избегнахме тонове разходи, а остатъчната натовареност е съсредоточена в малък вътрешен цикъл за търсене, който е добре пригоден за допълнителна оптимизация.
Нашият фактически алгоритъм за търсене се основава на . Той наподобява алгоритъма на Бойер – Мура с пропуск около дължината на търсената низ на всяка стъпка. Основната разлика е, че проверява два байта наведнъж, за да минимизира фалшивите съвпадения.
Нашата реализация изисква за всяко търсене да се създаде търсене на таблица от 64K, но това е маловажно в сравнение с гигабайтите данни, в които търсим. Вътрешният цикъл обработва няколко гигабайта в секунда на едно ядро. На практика стабилната производителност е около 1,25 GB в секунда на всяко ядро, а има потенциал за подобрение. Можем да премахнем някои разходи извън вътрешния цикъл и планираме да експериментираме с вътрешния цикъл на C вместо Java.
Прилагаме сила
Обсъдихме, че търсенето в лог файловете може да бъде реализирано "грубо", но колко "сила" имаме? Не малко.
1 ядро: при правилно използване, едно ядро на съвременен процесор е доста мощно само по себе си.
8 ядра: в момента работим на сървъри Amazon hi1.4xlarge и i2.4xlarge SSD, всеки от които разполага с 8 ядра (16 потока). Както споменахме по-горе, обикновено тези ядра са заети с фонови операции. Когато потребителят извършва търсене, фоновите операции се спират, освобождавайки всичките 8 ядра за търсене. Търсенето обикновено завършва за част от секундата, след което фоновата работа се възобновява (програмата-регулатор гарантира, че валът от търсения не пречи на важната фонова работа).
16 ядра: за надеждност организираме сървърите в групи master/slave. Всяка master има подчинен SSD сървър и един EBS. Ако главният сървър падне, сървърът на SSD незабавно заема неговото място. Почти през цялото време master и slave работят нормално, така че всеки блок данни е достъпен за търсене на два различни сървъра (подчиненият EBS сървър има слаб процесор, затова не го разглеждаме). Разделяме задачата между тях, така че общо разполагаме с 16 ядра.
Много ядра: в близко бъдеще ще разпределим данните по сървъри по такъв начин, че всички да участват в обработката на всяко нетривиално запитване. Всички ядра ще работят. [Примечание: планирали сме и увеличили скоростта на търсене до 1 TB/s, вижте бележката в края на статията].
Простотата осигурява надеждност
Още едно предимство на метода на грубата сила е доста стабилната производителност. Обикновено, търсенето не е много чувствително към детайлите на задачата и набора от данни (мисля, че затова се нарича "груб").
Индексът на ключовите думи понякога предоставя невероятно бърз резултат, а в други случаи не. Да предположим, че имате 50 ГБ дневници, в които терминът 'customer_5987235982' се среща точно три пъти. Търсенето по този термин директно от индекса открива три местоположения и приключва мигновено. Но сложното търсене с заместващи знаци може да сканира хиляди ключови думи и да отнеме много време.
От друга страна, търсенето с метод на груба сила за всяко запитване се извършва с повече или по-малко еднаква скорост. Търсенето на дълги думи е по-добро, но дори търсенето на един символ става достатъчно бързо.
Простотата на метода на груба сила означава, че производителността му е близка до теоретичния максимум. Тук имаме по-малко опции за неочаквано претоварване на дисковете, конфликти при блокировките, гонитба на указатели и хиляди други причини за сривове. Просто погледнах на запитванията, направени от потребителите на Scalyr през миналата седмица на нашия най-натоварен сървър. Имаше 14 000 запитвания. Само осем от тях отнеха повече от една секунда; 99% бяха изпълнени в рамките на 111 милисекунди (ако не сте използвали инструменти за анализ на дневници, повярвайте: това е бързо).
Стабилната, надеждна производителност е важна за удобството на ползване на услугата. Ако тя периодично забавя, потребителите ще я възприемат като ненадеждна и няма да искат да я използват.
Търсене в дневници в действие
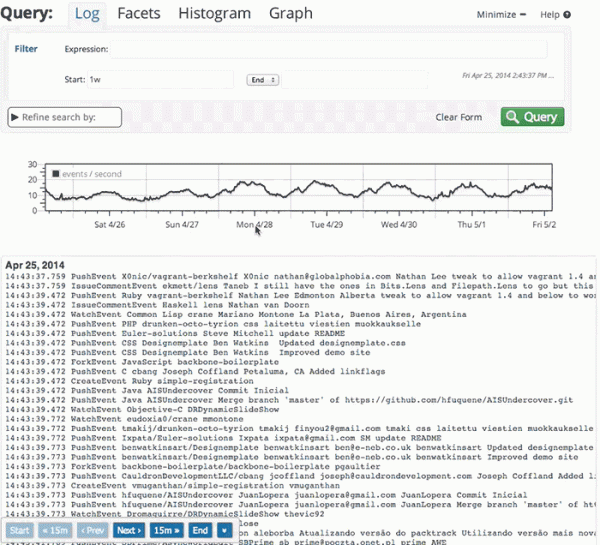
Ето малка анимация, която показва търсенето в Scalyr в действие. Имаме демонстрационен акаунт, където импортираме всяко събитие от всеки публичен репозитории в Github. В тази демонстрация разглеждам данните за седмица: около 600 МБ необработени дневници.
Видеото е записано на живо, без специална подготовка, на моя десктоп (около 5000 километра от сървъра). Производителността, която ще видите, е до голяма степен благодарение на , а също и на бързия и надежден бекенд. Всеки път, когато има пауза без индикатор 'loading', аз правя пауза, за да успеете да прочетете какво обмислям.
В заключение
При обработка на големи обеми данни е важно да изберете добър алгоритъм, но "добър" не означава "причудлив". Помислете как вашият код ще работи на практика. От теоретичния анализ на алгоритмите изпадат някои фактори, които могат да имат голямо значение в реалния свят. По-простите алгоритми са по-лесни за оптимизиране и те са по-стабилни в критични ситуации.
Също така помислете за контекста, в който ще се изпълнява кодът. В нашия случай са необходими достатъчно мощни сървъри за управление на фоновите задачи. Потребителите сравнително рядко инициират търсене, поради което можем да наемем цяла група сървъри за кратък период, необходим за извършване на всяко търсене.
С метода на грубата сила реализирахме бързо, надеждно и гъвкаво търсене в набор от логове. Надяваме се тези идеи да бъдат полезни за вашите проекти.
Редакция: заглавието и текстът бяха променени от «Търсене с скорости 20 ГБ в секунда» на «Търсене с скорости 1 ТБ в секунда», за да отразят увеличението на производителността през последните няколко години. Тази увеличена скорост е свързана основно с промяната в типа и количеството EC2 сървъри, които днес разгръщаме за обслужване на увеличената клиентска база. В близко бъдеще се очакват промени, които ще осигурят още едно рязко повишаване на效率, и с нетърпение очакваме да имаме възможност да разкажем за това.
Източник: habr.com
