

Ефектът на надуването на таблици и индекси (bloat) е широко известен и присъства не само в Postgres. Съществуват начини за справяне с него "из коробката", като VACUUM FULL или CLUSTER, но те блокират таблиците по време на работа и следователно не винаги могат да бъдат използвани.
В статията ще има малко теория за това как възниква bloat, как можем да се борим с него, за отложените ограничения и за проблемите, които те внасят в използването на разширението pg_repack.
Тази статия е написана на базата на на PgConf.Russia 2020.
Защо възниква bloat
В основата на Postgres лежи многоверсионната модел (). Същността му е, че всеки ред в таблицата може да има няколко версии, като транзакциите виждат не повече от една от тези версии, но не е задължително да бъде една и съща. Това позволява на няколко транзакции да работят едновременно и практически да не оказват влияние една на друга.
Очевидно е, че всички тези версии трябва да се съхраняват. Postgres работи с паметта странично и страницата е минималният обем данни, който може да бъде прочетен от диска или записан. Нека разгледаме малък пример, за да разберем как става това.
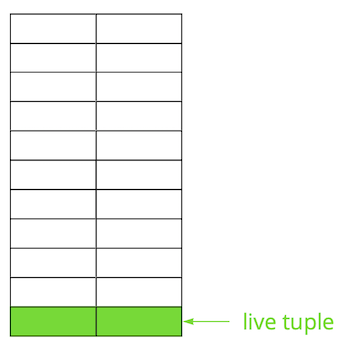
Предположим, че имаме таблица, в която добавихме няколко записа. На първата страница на файла, където е съхранена таблицата, се появиха нови данни. Това са живите версии на редовете, които са достъпни за другите транзакции след комит (за опростеност, да приемем, че нивото на изолация е Read Committed).
След това актуализирахме една от записите и по този начин маркирахме старата версия като неактуална.
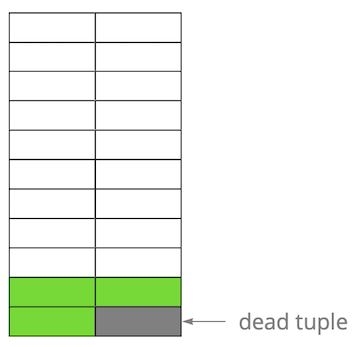
Стъпка по стъпка, актуализирайки и изтривайки версии на редове, получихме страница, в която около половината данни са "боклук". Тези данни не са видими за нито една транзакция.
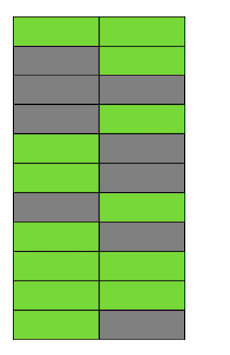
В Postgres съществува механизъм , който почиства неактуалните версии и освобождава място за нови данни. Но ако е конфигуриран недостатъчно агресивно или е зает с работа в други таблици, "боклукът" остава, и ние сме принудени да използваме допълнителни страници за новите данни.
Така в нашия пример в един момент таблицата ще се състои от четири страници, но живите данни в нея ще бъдат само половината. В резултат на това, при достъп до таблицата, ще изчитаме много повече данни, отколкото е необходимо.
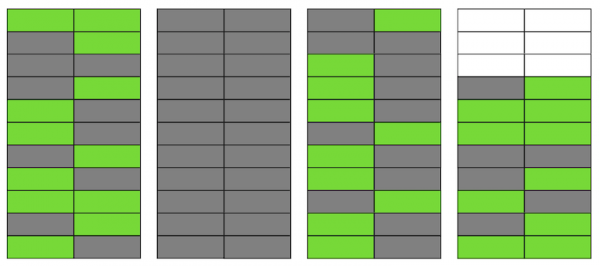
Дори ако VACUUM в момента премахне всички неактуални версии на редовете, ситуацията няма да се подобри драстично. Ще имаме свободно пространство на страниците или дори цели страници за нови редове, но все пак ще извършваме повече прочитане на данни, отколкото е необходимо.
Между другото, ако напълно празната страница (втората в нашия пример) е накрая на файла, VACUUM би могъл да я отрежа. Но в момента тя се намира в средата, така че не може да се направи нищо с нея.
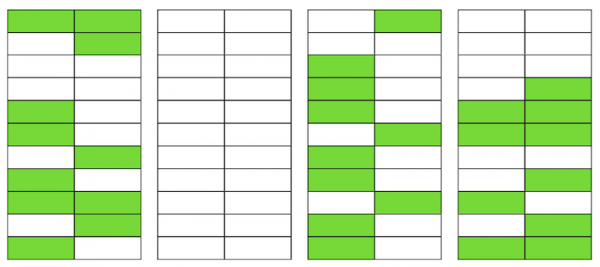
Когато броят на подобни празни или силно разредени страници стане голям, което се нарича bloat, това започва да влияе на производителността.
Всичко описано по-горе е механиката на възникване на bloat в таблиците. В индексите това се случва по същия начин.
Имам ли bloat?
Има няколко начина да определите дали имате bloat. Идеята на първия е да използвате вътрешната статистика на Postgres, която съдържа приблизителна информация за броя на редовете в таблиците, броя на “живите” редове и др. В интернет можете да намерите много вариации на готови скриптове. Ние взехме за основа от PostgreSQL Experts, който може да оцени bloat в таблиците заедно с toast и bloat btree индексите. Според нашия опит, неговата грешка е между 10-20%.
Друг начин е да използвате разширение , което позволява да се види вътре в страниците и да се получи както оценъчно, така и точно значение на bloat. Но в този случай ще трябва да сканирате цялата таблица.
Ниско значение на bloat, до 20%, считаме за приемливо. Може да се счита за аналог на fillfactor за и . При 50% и повече могат да започнат проблеми с производителността.
Методи за борба с bloat
В Postgres има няколко метода за борба с bloat "извън кутията", но те не винаги са приложими за всички.
Настройте AUTOVACUUM, за да предотвратите появата на bloat. И за да бъде по-точно, за да се поддържа на приемливо за вас ниво. Изглежда, че това е „капитанов“ съвет, но в действителност не винаги е лесно да се постигне. Например, ако активната разработка включва редовни промени в схемата на данните или се извършва миграция на данни. В резултат на това профилът на натоварване може често да се променя и обикновено той е различен за различни таблици. Следователно, трябва да работите малко напред и да настроите AUTOVACUUM според променящия се профил на всяка таблица. Но очевидно е, че не е лесно да се направи това.
Друг разпространен проблем, поради който AUTOVACUUM не успява да обработи таблиците, е наличието на дълги транзакции, които не му позволяват да изчисти данни, защото те са достъпни за тези транзакции. Препоръката тук също е очевидна – избавете се от „висящи“ транзакции и минимизирайте времето на активните транзакции. Но ако натоварването на вашето приложение е хибрид между OLAP и OLTP, то вие може да имате както много чести актуализации и кратки заявки, така и дълги операции – например, изграждане на определен отчет. В такава ситуация, си струва да помислите за разпределение на натоварването на различни бази, което ще позволи по-финна настройка на всяка от тях.
Още един пример – дори ако профилът е хомогенен, но БД е под много високо натоварване, дори максимално агресивен AUTOVACUUM може да не се справи и bloat да се появи. Масштабиране (вертикално или хоризонтално) – единственото решение.
Какво да правим в ситуация, когато сте настроили AUTOVACUUM, но bloat продължава да нараства?
Екип VACUUM FULL преструктурира съдържанието на таблиците и индекси и оставя само актуалните данни в тях. За премахване на bloat работи идеално, но по време на нейното изпълнение се получава ексклузивна блокировка на таблицата (AccessExclusiveLock), която не позволява изпълнението на заявки към тази таблица, дори и select-ове. Ако можете да си позволите да спрете вашия сервис или неговата част за известно време (от десетки минути до няколко часа в зависимост от размера на БД и вашето оборудване), то този вариант е най-добър. За съжаление, нямаме време да изпълним VACUUM FULL в рамките на заплануваното поддържане, така че този метод не е подходящ за нас.
Екип CLUSTER премества съдържанието на таблиците, подобно на VACUUM FULL, но позволява да посочите индекс, по който данните ще бъдат физически наредени на диска (но в бъдеще редът не е гарантиран за новите редове). В определени ситуации това е добра оптимизация за редица заявки – с четене на няколко записа по индекс. Недостатъкът на тази команда е същият като при VACUUM FULL – тя блокира таблицата по време на работа.
Екип REINDEX е подобна на двете предишни, но извършва реконструкция на конкретен индекс или на всички индекси на таблицата. Блокировките са малко по-слаби: ShareLock на таблицата (влияе на модификациите, но позволява изпълнение на select) и AccessExclusiveLock на реконструирания индекс (блокира заявки, използващи този индекс). Въпреки това, в 12-та версия на Postgres е добавен параметър , който позволява реконструкция на индекса без блокиране на паралелното добавяне, изменение или изтриване на записи.
В по-ранни версии на Postgres може да се постигне резултат, подобен на REINDEX CONCURRENTLY, с помощта на . Той позволява да се създаде индекс без строга блокировка (ShareUpdateExclusiveLock, която не пречи на паралелните заявки), след което да се замени старият индекс с новия и да се изтрие старият индекс. Това позволява да се отстрани bloat на индексите, без да се пречи на работата на вашето приложение. Важно е да се има предвид, че по време на реконструкция на индексите ще има допълнителна натовареност на дисковата подсистема.
Следователно, ако за индексите съществуват начини за отстраняване на bloat “в движение”, то за таблиците такива не съществуват. Тук влизат в действие различни външни разширения: (преди pg_reorg), , и други. В рамките на тази статия, аз няма да ги сравнявам и ще разкажа само за pg_repack, което след известно доработка използваме при нас.
Как работи pg_repack
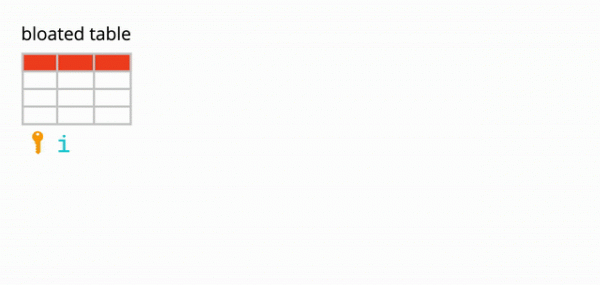
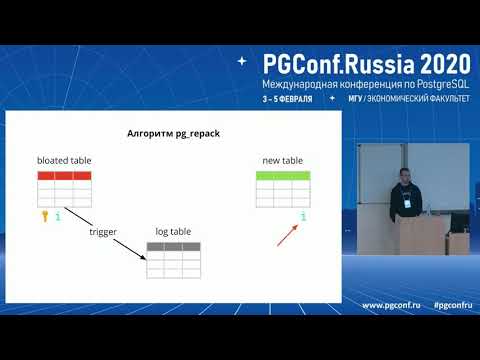
Да предположим, че имаме напълно нормална таблица – с индекси, ограничения и, за съжаление, с bloat. Първата стъпка на pg_repack е създаването на лог-таблица, за да съхранява данни относно всички изменения по време на работа. Триггерът ще репликира тези изменения при всеки insert, update и delete. След това се създава таблица, аналогична на оригиналната по структура, но без индекси и ограничения, за да не забавя процеса на вмъкване на данни.
След това pg_repack премества данните от старата таблица в нова, автоматично филтрирайки всички неактуални редове, а след това създава индекси за новата таблица. В процеса на изпълнение на всичките тези операции в лог таблицата се натрупват промени.
Следващата стъпка е да се прехвърлят промените в новата таблица. Прехвърлянето се извършва в няколко итерации и когато в лог таблицата останат по-малко от 20 записа, pg_repack хваща строга блокировка, прехвърля последните данни и замества старата таблица с новата в системните таблици на Postgres. Това е единственото и много кратко време, когато няма да можете да работите с таблицата. След това старата таблица и таблицата с логовете се изтриват и в файловата система се освобождава място. Процесът е завършен.
В теорията всичко изглежда отлично, какво обаче става на практика? Тествали сме pg_repack без натоварване и под натоварване, проверявайки работата му в случай на преждевременна спиране (по-просто казано, с Ctrl+C). Всички тестове бяха положителни.
Потеглихме на прод — и тук всичко тръгна не както очаквахме.
Първият провал на проде
На първия клъстер получихме грешка за нарушаване на уникалното ограничение:
$ ./pg_repack -t tablename -o id
INFO: репакетиране на таблица "tablename"
ERROR: заявката не успя:
    ERROR: дублирана стойност на ключ нарушава уникалното ограничение "index_16508"
DETAIL: Ключът (id, index)=(100500, 42) вече съществува.
Това ограничение имаше автоматично генерирано наименование index_16508 – създадено е от pg_repack. По атрибутите, включени в него, определихме “нашето” ограничение, което му отговаря. Проблемът се оказа, че това не е съвсем обикновено ограничение, а отложено (), т.е. проверката му се извършва по-късно от sql командата, което води до неочаквани последици.
Отложени ограничения: защо са нужни и как работят
Малко теория за отложените ограничения.
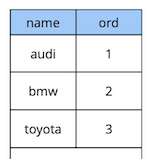
Нека разгледаме прост пример: имаме таблица-справочник на автомобили с два атрибута – наименование и ред на автомобила в справочника.
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Да кажем, че ни е необходимо да сменим местата на първия и втория автомобил. Решението „в лоб“ – да обновим първата стойност на втората, а втората на първата:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Но при изпълнението на този код очаквано ще получим нарушаване на ограничението, тъй като реда на стойностите в таблицата е уникален:
[23305] ГРЕШКА: дублиране на ключова стойност нарушава уникалната ограниченост “uk_cars”
Детайли: Ключът (ord)=(2) вече съществува.
Как да направим нещата по различен начин? Първи вариант: добавете допълнителна замяна на стойността на реда, която със сигурност не съществува в таблицата, например “-1”. В програмирането това се нарича “размяна на стойностите на две променливи чрез трета”. Единственият недостатък на този метод е допълнителното обновяване.
Втори вариант: преосмислете таблицата, за да използвате плаваща точка за тип данни за стойността на реда вместо цели числа. Тогава при обновяване на стойността от 1, например, на 2,5, първият запис автоматично ще “влезе” между втория и третия. Това решение работи, но има две ограничения. Първо, не е подходящо, ако стойността се използва някъде в интерфейса. Второ, в зависимост от точността на типа данни, ще имате ограничен брой възможни вставки, преди да се наложи прекалкулиране на стойностите на всички записи.
Трети вариант: направете ограничението отложено, за да се проверява само в момента на комита:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Тъй като логиката на нашето първоначално запитване гарантира, че до момента на комита всички стойности са уникални, то то ще се изпълни успешно.
Разгледаният по-горе пример, разбира се, е много синтетичен, но разкрива идеята. В нашето приложение използваме отложени ограничения за реализиране на логиката, която отговаря за разрешаване на конфликти, когато потребителите работят едновременно с общи обекти-виджети на платформа. Използването на такива ограничения ни позволява да направим приложния код малко по-прост.
Общо взето, в зависимост от типа на ограничението в Postgres, съществуват три нива на грануларност на проверките: на ниво ред, транзакция и израз.
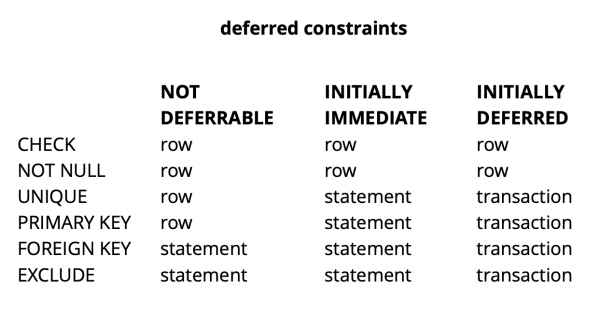
Източник:
CHECK и NOT NULL винаги се проверяват на ниво ред; за останалите ограничения, каквато е показано в таблицата, има различни варианти. Повече информация може да бъде прочетена .
Накратко казано, отложените ограничения в определени ситуации предоставят по-ясен код за четене и по-малко команди. Обаче за това се плаща с усложняване на процеса на дебъгване, тъй като моментът на възникване на грешката и моментът, в който вие разбирате за нея, са отдалечени във времето. Още един възможен проблем е, че планировачът не винаги може да състави оптимален план, ако в заявката участва отложено ограничение.
Довършване на pg_repack
Разгледахме какво представляват отложените ограничения, но как те са свързани с нашия проблем? Нека си припомним грешката, която получихме по-рано:
$ ./pg_repack -t tablename -o id
INFO: репакетиране на таблица "tablename"
ERROR: заявката не успя:
    ERROR: дублирана стойност на ключ нарушава уникалното ограничение "index_16508"
DETAIL: Ключът (id, index)=(100500, 42) вече съществува.
Тя възниква в момента на копиране на данни от лог-таблица в нова таблица. Изглежда странно, тъй като данните в лог-таблицата се комитират заедно с данните от изходната таблица. Ако те отговарят на ограниченията на изходната таблица, как тогава могат да нарушат същите ограничения в новата?
Както се оказа, коренът на проблема се крие в предишната стъпка на работа с pg_repack, на която се създават само индексите, но не и ограниченията: в старата таблица имаше уникално ограничение, а в новата вместо него се създаде уникален индекс.
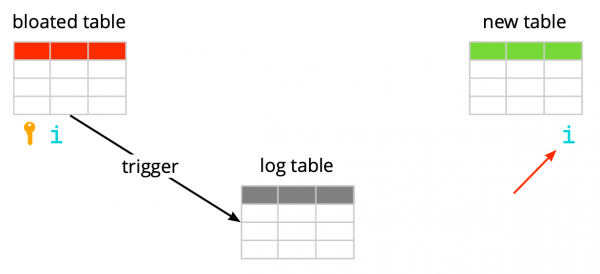
Тук е важно да се отбележи, че ако ограничението е обикновено, а не отложено, то създаденият вместо него уникален индекс е равносилен на това ограничение, тъй като уникалните ограничения в Postgres се реализират чрез създаване на уникален индекс. Но в случая с отложеното ограничение поведението не е идентично, тъй като индексът не може да бъде отложен и винаги се проверява в момента на изпълнение на sql-команда.
Така че, същността на проблема се състои в “отложеността” на проверката: в изходната таблица тя се извършва в момента на комита, а в новата – в момента на изпълнение на sql-команда. Следователно, трябва да направим така, че проверките да се изпълняват еднакво в двата случая: или винаги отложено, или винаги веднага.
И така, какви идеи имахме.
Създаване на индекс, аналогичен на deferred
Първата идея е да се извършват и двете проверки в режим на незабавност. Това може да предизвика няколко фалшиви положителни реакции на ограниченията, но ако те са малко, не трябва да влияят на работата на потребителите, тъй като такива конфликти са нормална ситуация за тях. Те се случват, например, когато двама потребители започнат едновременно да редактират един и същ виджет и клиентът на втория потребител не успява да получи информация, че виджетът вече е блокиран за редактиране от първия потребител. В такава ситуация сървърът отказва на втория потребител, а неговият клиент отменя промените и блокира виджета. По-късно, когато първият потребител завърши редакцията, вторият ще получи информация, че виджетът вече не е блокиран и ще може да повтори своето действие.
За да могат проверките винаги да бъдат в спешен режим, създадохме нов индекс, подобен на оригиналното отложено ограничение:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- изпълни pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
В тестовата среда получихме само няколко очаквани грешки. Успех! Отново стартирахме pg_repack на продукция и получихме 5 грешки в първия кластер за един час работа. Това е приемлив резултат. Въпреки това, втората кластерна грешка нарасна многократно и ни се наложи да спрем pg_repack.
Защо се случи това? Вероятността да възникне грешка зависи от това колко много потребители работят едновременно с едни и същи виджети. Изглежда, че в момента с данните, съхранявани в първия кластер, е имало значително по-малко конкурентни промени, отколкото в останалите, т.е. просто сме „имали късмет“.
Идеята не сработи. В този момент видяхме две други варианта за решение: да презапишем нашия приложен код, за да се откажем от отложените ограничения, или да „научим“ pg_repack да работи с тях. Избрахме второто.
Да заменим индексите в новата таблица с отложени ограничения от изходната таблица.
Целта на доработката беше очевидна – ако изходната таблица има отложено ограничение, за новата трябва да се създаде такова ограничение, а не индекс.
За да проверим промените, написахме прост тест:
- таблица с отложено ограничение и една запис;
- вмъкваме в цикъл данни, които предизвикват конфликт с вече съществуващата запис;
- правим обновление – данните вече не конфликтуват;
- комитваме промените.
създаване на таблица test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
първоначалната версия на pg_repack винаги падна при първото вмъкване, подобрената версия работеше без грешки. Отлично.
Отиваме на продукция и отново получаваме грешка в същата фаза на копиране на данни от лог таблицата в новата:
$ ./pg_repack -t tablename -o id
INFO: репакетиране на таблица "tablename"
ERROR: заявката не успя:
    ERROR: дублирана стойност на ключ нарушава уникалното ограничение "index_16508"
DETAIL: Ключът (id, index)=(100500, 42) вече съществува.
Класическа ситуация: в тестовите среди всичко работи, а на продукцията – не?!
APPLY_COUNT и свързването на два партиди
Започнахме да анализираме кода буквално ред по ред и открихме важен момент: преливането на данни от лог таблицата в новата става на партиди, константата APPLY_COUNT определяше размера на партидата:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;   there might be still some tuples, repeat.
...
}
Проблемът е, че данните от първоначалната транзакция, в която няколко операции потенциално могат да нарушат ограниченията, при прехвърляне могат да попаднат на свързването на две партиди – половината от командите ще бъдат комитнати в първата партида, а другата половина – във втората. И тук каквото стане: ако командите в първата партида не нарушават нищо, всичко е наред, а ако нарушават – се получава грешка.
APPLY_COUNT е равен на 1000 записа, което обяснява защо нашите тестове преминаваха успешно – те не покриваха случая „свързване на партиди“. Използвахме две команди – insert и update, следователно точно 500 транзакции по две команди винаги попадаха в партида и не срещахме проблеми. След добавяне на втория update нашето изменение спря да работи:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- още един update
    COMMIT;
  END;
END LOOP;
И така, следващата задача е да накараме данните от първоначалната таблица, които се променяха в една транзакция, да попаднат в новата таблица също в една транзакция.
Отказ от партиди
И при нас отново имаше два варианта за решения. Първият: да се откажем изцяло от разчленението на батуци и да направим прехвърлянето на данни с една транзакция. В полза на това решение беше неговата простота – необходимите изменения в кода бяха минимални (между другото, в по-старите версии pg_reorg работеше точно така). Но има проблем – създаваме дълга транзакция, а това, както беше споменато по-рано, е заплаха за възникването на нов bloat.
Второто решение – по-сложно, но вероятно по-правилно: да създадем в лог-таблицата колона с идентификатор на транзакцията, която е добавила данните в таблицата. Тогава при копирането на данните можем да ги групираме по този атрибут и да гарантираме, че свързаните изменения ще бъдат пренесени заедно. Батчът ще бъде формиран от няколко транзакции (или една голяма) и размерът му ще варира в зависимост от това, колко много данни са били променени в тези транзакции. Важно е да се отбележи, че тъй като данните от различни транзакции попада в лог-таблицата в произволен ред, не можем да я четем последователно, както беше по-рано. seqscan при всяко запитване с филтриране по tx_id е твърде скъпо, нужен е индекс, но и той ще забави работата на метода заради разходите по актуализацията му. В общи линии, както винаги е нужно да се жертва нещо.
И така, решихме да започнем с първия вариант, като по-прост. За начало беше необходимо да разберем дали дългата транзакция ще бъде реален проблем. Тъй като основното прехвърляне на данни от старата таблица в новата също се извършва с една дълга транзакция, въпросът се трансформира в "колко ще увеличим тази транзакция?" Продължителността на първата транзакция зависи основно от размера на таблицата. Продължителността на новата – от това колко много изменения ще се натрупат в таблицата по време на преливането на данните, т.е. от интензивността на натоварването. Процесът на pg_repack се извърши по време на минимално натоварване на услугата и обемът на измененията беше несравнимо малък в сравнение с първоначалния обем на таблицата. Решихме, че можем да пренебрегнем времето на новата транзакция (за сравнение, средно това е 1ч и 2-3 минути).
Експериментите бяха положителни. Стартирането на продукция също. За нагледност – изображение с размера на една от базите след прегледа:
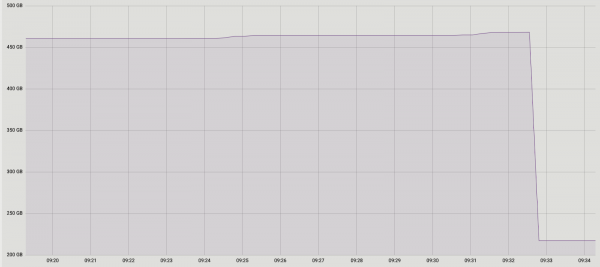
Тъй като това решение ни удовлетворява напълно, не опитахме да реализираме второто, но обмисляме възможността да го обсъдим с разработчиците на разширението. Нашето текущо подобрение, за съжаление, все още не е готово за публикуване, тъй като решихме проблема само с уникалните отложени ограничения, а за пълноценен пач е необходимо да направим поддръжка и на другите типове. Надяваме се, че ще успеем да го реализираме в бъдеще.
Възможно е да сте се запитали защо изобщо се захванахме с тази история с доработката на pg_repack, а не решихме, например, да използваме неговите аналози? В определен момент и ние мислехме за това, но положителният опит от предишното му използване, на таблици без отложени ограничения, ни мотивира да опитаме да разберем същността на проблема и да го коригираме. Освен това, за да използваме други решения, е необходимо време за провеждане на тестове, затова решихме, че първо ще опитаме да решим проблема в него, а ако разберем, че не можем да го направим за разумно време, тогава ще започнем да разглеждаме аналогите.
Изводи
Какво можем да препоръчаме въз основа на собствен опит:
- Наблюдавайте вашия bloat. На базата на данните от мониторинга ще можете да разберете, колко добре е настроен autovacuum.
- Настройвайте AUTOVACUUM, за да поддържате bloat на допустимо ниво.
- Ако все пак bloat нараства и не можете да се справите с него с помощта на средства "извън кутията", не се страхувайте да използвате външни разширения. Важно е всичко да бъде добре тествано.
- Не се страхувайте да доработвате външни решения според своите нужди – понякога това може да бъде по-ефективно и дори по-просто, отколкото да променяте своя собствен код.
Източник: habr.com
