

В SQL описвате «какво» искате да получите, а не «как» да бъде изпълнено. Затова проблемът с разработването на SQL заявки в стил „както звучи, така и се пише“ заема своето почетно място, наред с .
Днес ще разгледаме на крайно прости примери до какво може да доведе това в контекста на използването на GROUP/DISTINCT и LIMIT заедно с тях.
Ако например в заявката сте написали «първо свържи тези таблици, а след това премахни всички дубликати, трябва да остане само един екземпляр за всеки ключ» — точно така и ще заработи, дори ако свързването изобщо не е било нужно.
И понякога се случва и това «просто работи», понякога — неочаквано се отразява на производителността, а понякога дава напълно неочаквани ефекти от гледна точка на разработчика.
Ами, да, може би не толкова зрелищни, но…
«Сладката двойка»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Както изглежда, е ясно, че искат да изберат записи X, за които в Y има свързани с изпълняващото се условие. Написали сте заявка през JOIN — получили сте някакви стойности pk по няколко пъти (точно колкото подходящи записи в Y се оказали). Как да ги премахнете? Разбира се DISTINCT!
Особено „радва“, когато за всяка X-запис се намират по няколко стотин свързани Y-записи, а после героично се премахват дубликатите…
Как да го поправите? Първо, осъзнайте, че задачата може да бъде модифицирана до «да изберат записи X, за които в Y има ПОНЕ ЕДИН свързан с изпълняващото се условие» — тъй като от самата Y-запис не ни трябва нищо.
Вложен EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Някои версии на PostgreSQL разбират, че в EXISTS е достатъчно да се намери първата попаднала запис, по-старите — не. Затова предпочитам винаги да указвам LIMIT 1 вътре EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Тази опция позволява при нужда веднага да върне някои данни от намерената свързана Y-запис. Подобен вариант е разгледан в статията .
«Защо да плащате повече»: DISTINCT [ON] + LIMIT 1
Допълнителното предимство на подобни преобразувания на запитвания е възможността лесно да се ограничи прегледа на записите, ако е необходим само един/няколко от тях, както в следния случай:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Сега четем запитването и се опитваме да разберем какво се предлага да направи СУБД:
- свързване на таблиците
- уникализираме по X.pk
- от останалите записи избираме някакъв един
Тоест какво получихме? „Някакъв един запис“ от уникализираните – а ако вземем този един от неуникализираните, резултатът не би ли се променил...? „А ако няма разлика, защо да плащаме повече?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- тук може да се поставят подходящи условия
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
И точно такава е темата с GROUP BY + LIMIT 1.
„Имам само да попитам“: неявен GROUP + LIMIT
Подобни случаи се срещат при различни проверки на непостоянство таблица или CTE по време на изпълнението на запитването:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Агрегатни функции (count/min/max/sum/...) успешно се изпълняват на целия набор, дори без явно посочване GROUP BY. Но с LIMIT не вярват много.
Разработчикът може да мисли „вот ако там има записи, то трябва да няма повече от LIMIT“. Но не трябва! Защото за базата данни това е:
- изчисли какво искат всички записи
- върни толкова реда, колкото искат
В зависимост от целевите условия тук е уместно да се направи една от замените:
(count + LIMIT 1) = 0наNOT EXISTS(LIMIT 1)(count + LIMIT 1) > 0наEXISTS(LIMIT 1)count >= Nна(SELECT count(*) FROM (... LIMIT N))
„Колко да сложим в грамове“: DISTINCT + LIMIT
SELECT DISTINCT
  pk
FROM
  X
LIMIT $1
Наивният разработчик може искрено да вярва, че изпълнението на запитването ще се спре, веднага щом намерим $1 първите попаднали различни стойности.
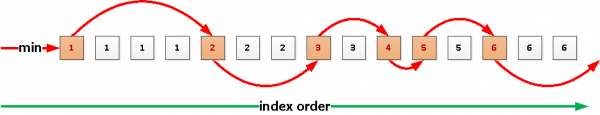
В бъдеще това може да работи така благодарение на новия възел Index Skip Scan, чиято реализация в момента се разработва, но засега - не.
В момента първо ще се извлекат всички записи, уникализират се и само от тях ще се върне толкова, колкото е поискано. Особено тъжно е, ако сме искали нещо подобно $1 = 4, а записите в таблицата са стотици хиляди…
За да не тъгуваме напразно, ще се възползваме от рекурсивното запитване :
Източник: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish