

В сложните ERP системи многообразието на съществата има йерархичен характер, когато хомогенни обекти се подреждат в дърво на отношенията "родител — потомък" — това е както организационната структура на предприятието (всички тези клонове, отдели и работни групи), така и каталог на стоките, участъци от работа и география на търговските точки,…
Всъщност, няма нито една , в която да няма какая йерархия в резултат. Но дори и да не работите "в бизнеса", все пак можете лесно да се сблъскате с йерархични връзки. Просто, дори вашето родословно дърво или етажна схема на помещенията в търговския център — це такава същата структура.
Има много начини за съхранение на такова дърво в СУБД, но днес ще се спрем само на един вариант:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- не забравяйте, че FK не предполага автоматично създаване на индекс, за разлика от PK
И докато вниквате в дълбочината на йерархията, тя търпеливо очаква, колко "не"ефективни ще се окажат вашите "наивни" начини за работа с такава структура.
Нека разгледаме типичните възникващи задачи, тяхната реализация на SQL и да опитаме да подобрим тяхната производителност.
#1. Насколько глубока кроличья нора?
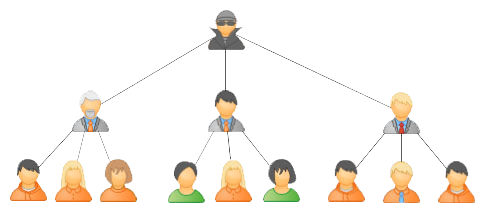
Нека, за яснота, приемем, че тази структура ще отразява подчинеността на отделите в организационната структура: департаменти, дивизии, сектори, клонове, работни групи,… — както и да ги наречем.
Първо ще генерираме нашето 'дърво' от 10K елемента
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Ще започнем с най-простата задача — да намерим всички служители, които работят в конкретен сектор, или в термини на йерархия — да намерим всички потомци на възела. А също така «дълбочината» на потомка също би могла да бъде полезна… Всичко това може да бъде необходимо, например, за изграждане на някакво .
Всичко би било наред, ако потомците там са само на няколко нива и са ограничени до десетина, но ако нивата са повече от 5, а потомците вече са десетки — могат да възникнат проблеми. Нека да видим как функционират традиционните методи за търсене "надолу по дървото". Но първо нека определим кои възли ще бъдат най-интересни за нашите изследвания.
Най-дълбоките поддървета: WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id  | pid  | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
... ШирокитеНай-дълбоките ... SELECT path[1] id , count(*) FROM T GROUP BY 1 ORDER BY 2 DESC; WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id   | count
------------
5300 |   30
 450 |   28
1239 |   27
1573 |   25
За тези заявки използвахме типичния
рекурсивен JOIN Очевидно, при такъв модел на запитване:
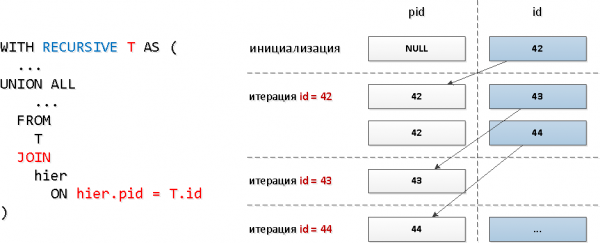
броят на итерациите ще съвпадне с общия брой потомци (а те са десетки), и това може да изисква значителни ресурси и, следователно, време. Да проверим на най-"широкото" поддърво:
WITH RECURSIVE T AS ( SELECT id FROM hier WHERE id = 5300 UNION ALL SELECT hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T;
[да видим на explain.tensor.ru] 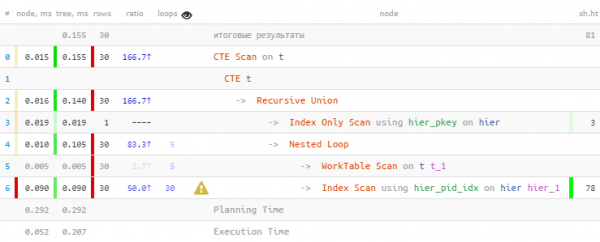
Масова прочитка по индекса
А нужно ли е да правим отделно запитване към индекса за всеки възел? Оказва се, че не — можем да четем от индекса
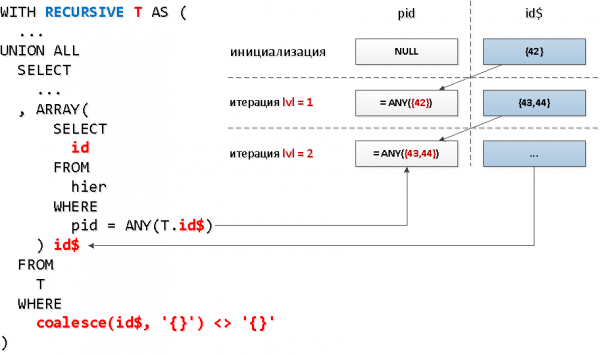
веднага по няколко ключа с едно повикване = ANY(array) чрез А в тези групи от идентификатори можем да вземем всички намерени на предишната стъпка ID по "възли". Тоест на всяка следваща стъпка ще търсим веднага всички потомци на определено ниво..
Само, че има проблем, в рекурсивния избор не може да се обърне към самия себе си в вложено запитване.
, а ние трябва да изберем точно това, което е намерено на предишното ниво… Оказва се, че правенето на вложено запитване към цялото селектиране — не може, но към конкретно поле — може. А това поле може да бъде и масив — което точно ни трябва за използване ANYЗвучи малко странно, но на схемата всичко е просто. , или.
Звучи малко странно, но на схемата — всичко е просто.
С РЕКУРСИВНА УСЛУГА T AS (
  ИЗБЕРЕТЕ
    MASIV[id] id$
  ОТ
    hier
  КЪДЕ
    id = 5300
СЪЮЗ ВСИЧКО
  ИЗБЕРЕТЕ
    MASIV(
      ИЗБЕРЕТЕ
        id
      ОТ
        hier
      КЪДЕ
        pid = ВСИЧКО(T.id$)
    ) id$
  ОТ
    T
  КЪДЕ
    coalesce(id$, '{}') <> '{}' -- условие за изход от цикъла - празен масив
)
ИЗБЕРЕТЕ
  unnest(id$) id
ОТ
T; 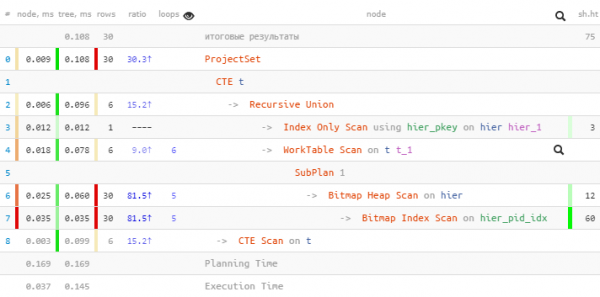
И тук най-важното не е дори печалба от 1.5 пъти по време, а че извадихме по-малко buffers, тъй като обращенията към индекса са само 5 вместо 30!
Допълнителен бонус е фактът, че след финалния unnest идентификаторите ще останат подредени по "нива".
Признак на нода
Следващата идея, която ще помогне за подобряване на производителността — при "листьята" не може да има деца, тоест за тях търсенето "надолу" изобщо не е необходимо. В контекста на нашата задача, това означава, че ако сме преминали през веригата на отделите и сме достигнали до служителя, то по тази клонка търсенето вече не е нужно.
Нека да въведем в нашата таблица допълнително boolean-поле, което ще ни казва веднага дали конкретният запис в нашето дърво е "нода" — тоест, могат ли да съществуват потомци на него.
ALTER TABLE hier
  ДОДАЙ КОЛОНА branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
КЪДЕ
  СЪЩЕСТВУВА(
    ИЗБЕРЕТЕ
      НИЩО
    ОТ
      hier
    КЪДЕ
      pid = T.id
    LIMIT 1
);
-- Запитването е успешно изпълнено: 3033 реда променени за 42 мс.
Страхотно! Оказва се, че само малко над 30% от всички елементи на дървото имат потомци.
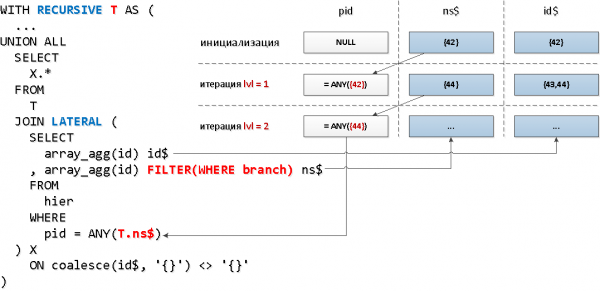
Сега ще приложим малко по-различна механика — свързване с рекурсивната част чрез LATERAL, което ще ни позволи веднага да се обърнем към полета на рекурсивната "таблица", а агрегатната функция с условие за филтриране по признака нода ще използваме за намаляване на набора от ключове:
С РЕКУРСИВНА УСЛУГА T AS (
  ИЗБЕРЕТЕ
    array_agg(id) id$
  , array_agg(id) ФИЛТЪР(КЪДЕ branch) ns$
  ОТ
    hier
  КЪДЕ
    id = 5300
СЪЮЗ ВСИЧКО
  ИЗБЕРЕТЕ
    X.*
  ОТ
    T
  СВЪРЗИ LATERAL (
    ИЗБЕРЕТЕ
      array_agg(id) id$
    , array_agg(id) ФИЛТЪР(КЪДЕ branch) ns$
    ОТ
      hier
    КЪДЕ
      pid = ВСИЧКО(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}') <> '{}'
)
ИЗБЕРЕТЕ
  unnest(id$) id
ОТ
T; 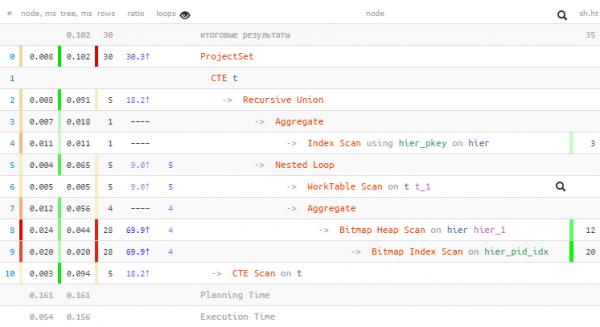
Успяхме да намалим още едно обращение към индекса и спечелихме повече от 2 пъти по обем изчетен.
#2. Вернемся к корням
Този алгоритъм ще бъде полезен, ако ви е необходимо да съберете записи за всички елементи "нагоре по дървото", като запазите информацията, с кое начално листо (и с какви показатели) е предизвикано попадането му в изборката — например, за съставяне на обобщен отчет с агрегация на нодовете.
По-нататъшното трябва да се разглежда единствено като proof-of-concept, тъй като запитването става твърде обемно. Но ако доминира във вашата база – е време да се замислите за използването на подобни методи.
Нека започнем с две прости твърдения:
- Същата запись от базата е по-добре да се чете само веднъж.
- Записите от базата е по-ефективно да се четат "на куп", отколкото поединично.
Сега нека опитаме да конструираме необходимо за нас запитване.
Стъпка 1
Очевидно е, че при инициализацията на рекурсията (как не!) трябва да извлечем записите на самите листа по набора от изходни идентификатори:
WITH RECURSIVE tree AS (
  SELECT
    rec -- това е цялостен запис в таблицата
  , id::text chld -- това е "набор" от водещи тук изходни листа
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Ако на някого му се е сторило странно, че "набор" се съхранява като строка, а не като масив, за това има просто обяснение. За строките съществува вградена агрегираща "съединяваща" функция string_agg, а за масиви – не. Въпреки че я .
Стъпка 2
Сега трябва да получим набор от ID на разделите, които трябва да изтеглим по-нататък. Почти винаги те ще се дублират при различни записи на изходния набор – затова ние трябва да ги групираме, като запазим информацията за източниците-листа.
Но тук ни очакват три неприятности:
- "Подрекурсивната" част на запитването не може да съдържа агрегационни функции с
GROUP BY. - Обращението към рекурсивната "таблица" не може да бъде във вложено подзапитване.
- Запитването в рекурсивната част не може да съдържа CTE.
За щастие, всички тези проблеми могат да се заобиколят доста лесно. Нека започнем от края.
CTE в рекурсивната част
Така не работи:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
А така – работи, скобите решават!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Вложено запитване към рекурсивната "таблица"
Хм… Обращението към рекурсивната CTE не може да бъде във вложено запитване. Но може да е вътре в CTE! А вложеното запитване може да се отнася вече към тази CTE!
GROUP BY в рамките на рекурсията
Неприятно, но… имаме прост начин как да симулираме GROUP BY с помощта на DISTINCT ON и прозоречни функции!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- не работи!
А ето така – работи!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Ето сега виждаме защо числовият ID се превръща в текст — за да могат да се свързват с запетая!
Стъпка 3
За финала ни остава само още:
- извеждаме записите на «разделите» по набор от групирани ID
- сопоставяме извлечените раздели със «наборите» от оригинални листове
- «разгъваме» наборния ред с помощта на
unnest(string_to_array(chld, ',')::integer[])
С РЕКУРСИВЕН tree КАТО (
  ИЗБЕРИ
    rec
  , id::text chld
  ОТ
    hier rec
  КЪДЕ
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
СЪЮЗ ВСИЧКИ
  (
    С
    prnt КАТО (
      ИЗБЕРИ DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      ОТ
        tree
      КЪДЕ
        (rec).pid НЕ Е NULL
    )
    , nodes КАТО (
      ИЗБЕРИ
        rec
      ОТ
        hier rec
      КЪДЕ
        id = ANY(ARRAY(
          ИЗБЕРИ
            id
          ОТ
            prnt
        ))
    )
    ИЗБЕРИ
      nodes.rec
    , prnt.chld
    ОТ
      prnt
    JOIN
      nodes
        ОН (nodes.rec).id = prnt.id
  )
)
ИЗБЕРИ
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
ОТ
tree; 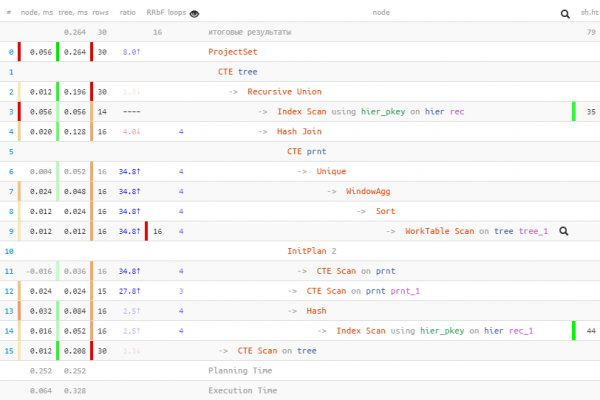
Източник: habr.com
