

Днес няма да обсъждаме сложни случаи или налудничави алгоритми на SQL. Всичко ще бъде много просто, на нивото на Капитан Очевидност — правим преглед на регистра на събития с подреждане по време.
Тоест, имаме таблица в базата events, а тя има поле ts — точно това време, по което искаме да показваме записите подредено:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Ясно е, че записите ни няма да са десет, следователно ще ни трябва по някакъв начин странична навигация.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Дори почти не е шега — рядко, но се среща в природата. Понякога след работа с ORM е трудно да се пренастроим на „директна“ работа с SQL.
Но нека преминем към по-разпространени и по-малко очевидни проблеми.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - записа на страницата, $1 - начало на страницата
От къде дойде числото 26? Това е приблизителният брой записи за запълване на един екран. По-точно, 25 показвани записа, плюс 1, сигнализираща, че в избора има още нещо и е смислено да продължим.
Разбира се, това значение не е задължително да се вгражда в тялото на запитването, а може да се предава чрез параметър. Но в този случай планировчикът на PostgreSQL няма да може да се опре на знанието, че записите би трябвало да са относително малко, — и може просто да избере неефективен план.
И докато в интерфейса на приложението прегледът на регистра е реализиран като превключване между визуални „страници“, никой дълго не забелязва нещо подозрително. Точно до момента, когато в името на удобството на UI/UX не решат да преработят интерфейса на „безкрайно превъртане“ — тоест всички записи от регистъра се показват в един списък, който потребителят може да превърта нагоре-надолу.
И ето, при следващото тестване ви хващат на дублиране на записи в регистъра. Защо, след като таблицата има нормален индекс (ts), на който се опира вашето запитване?
Точно защото не сте взели предвид, че ts не е уникален ключ в тази таблица. Всъщност и значенията му не са уникални, както при всяко „време“ в реални условия - затова една и съща записка в две съседни запитвания лесно „прескача“ от страница на страница заради различен краен ред в рамките на сортиране на едно и също ключово значение.
Всъщност, тук се крие и втори проблем, който е много по-труден за забелязване - някои записи няма да се покажат изобщо! В крайна сметка „дублираните“ записи заемат мястото на други. Подробно обяснение с красиви картинки можете .
Разширяване на индекса
Измамният разработчик разбира - необходимо е да се направи ключът на индекса уникален, а най-простият начин е да се разшири с преднамерено уникално поле, което е перфектно подходящо за PK:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);А запитването мутира:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Някое време по-късно при вас идва DBA и ви „радва“, че вашите запитвания , а изобщо е време да преминете на навигация от последната показана стойност. Вашето запитване отново мутира:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- последните получени стойности от предишната стъпка
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Вие си вдигнали дълбоко дъх, докато не настъпило…
#3. Чистка индексов
Защото веднъж вашият DBA прочете и разбра, че „непоследният“ timestamp - не е добре. И отново дойде при вас - сега с мисълта, че онзи индекс все пак трябва да се върне обратно в (ts DESC).
Но какво да правим с първоначалния проблем с „скачането“ на записите между страниците?.. А всичко е просто - необходимо е да избирате блокове с неопределен брой записи!
Всъщност, кой ни забранява да четем не „точно 26“, а „не по-малко от 26“? Например, така, че в следващия блок да се окажат записи с очевидно различни стойности ts - тогава наистина няма да има проблеми с „прескачането“ на записи между блоковете!
Ето как да постигнем това:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
Какво всъщност става тук?
- Слизаме с 25 записа „надолу“ и получаваме „прагова“ стойност
ts. - Ако там вече няма нищо, заменяме NULL-стойността с
-infinity. - Изваждаме целия сегмент стойности между получената стойност
tsи предадената от интерфейса променлива $1 (последната „посочена“ стойност). - Ако блокът се е върнал с по-малко от 26 записа — той е последният.
Или същото на картинка:
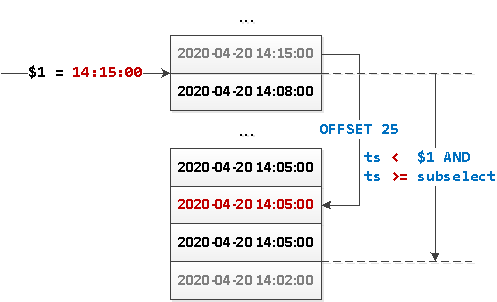
Тъй като вече имаме извадката няма определен «начало», нищо не ни пречи да «развърнем» тази заявка наобратно и да реализираме динамично зареждане на блокове данни от «опорната точка» в двете посоки — както надолу, така и нагоре.
Бележка
- Да, в такъв случай се обръщаме към индекса два пъти, но всичко е «чисто по индекса». Затова вложената заявка ще доведе само до едно допълнително Index Only Scan.
- Достатъчно очевидно е, че тази методика може да се използва само когато имате стойности,
tsкоито могат да се пресекат само случайно, и ги има малко. Но ако типичният ви случай е «милион записа в 00:00:00.000», не бива да правите така. С други думи, не бива да допускаме такъв случай. Но ако все пак се е получило, използвайте варианта с разширен индекс.
Източник: habr.com
