

Напоследък колегите в "братството" независимо започнаха да ме питат как да се получат всички канали Bluetooth едновременно от един SDR приемник? Плътността позволява, има SDR с изходна плътност от 80 MHz и повече. Разбира се, може да се направи на FPGA, но времето за разработка ще бъде доста голямо. Отдавна ми беше известно, че е сравнително лесно да се направи това на GPU, но толкова просто!
Стандартът Bluetooth определя физическото ниво в две версии: Classic и Low Energy. Има спецификация. Документът е ужасно обемен, четенето му изцяло е опасно за мозъка. За щастие, големи компании, произвеждащи измервателна техника, имат средства за създаване на нагледни документи по темата. и , например. Нямам абсолютно никакъв шанс в конкуренцията с тях по качеството на представянето на материала. Занимаващите се с темата моля да проучат по линковете.
Всичко, което трябва да знам за физическото ниво за създаване на многоканален филтър, е стъпката на мрежата от честоти и скоростта на модулация. Те са представени в таблица в един от указаните документи:
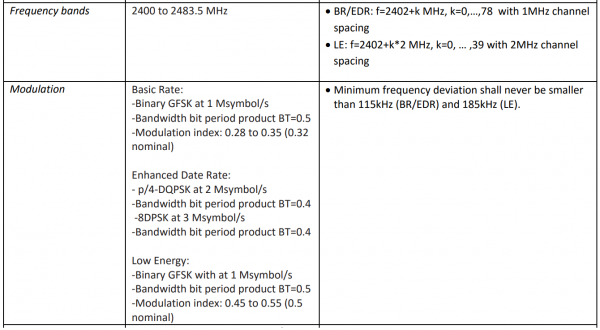
Така, трябва да разделим 80 MHz на 79 филтъра с настройка от 1 MHz и, едновременно с това, на 40 филтъра с настройка от 2 MHz. Честотите на пробите от изходите на филтрите трябва да са 1 MHz и 2 MHz, съответно.
Следователно, необходим ни е два комплекта филтри.
Първо, да изберем параметрите на тези филтри въз основа на полосите на сигналите Bluetooth Classic и Bluetooth Low Energy. Нужни са ни техните импулсни характеристики, за да изчислим натоварването на изчислителното устройство на филтъра. Тук веднага трябва да уточня, че дължината на импулсните характеристики сме избрали в зависимост от изискванията на "бързия" алгоритъм за филтриране. Същността не се променя. И броят на коефициентите на импулсната характеристика не трябва да е твърде голям, за да бъде филтърът реализируем на разумна изчислителна апаратура.
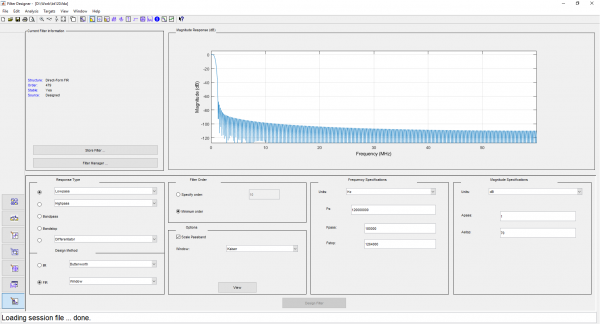
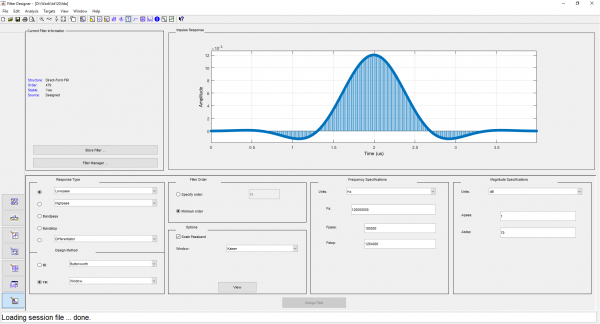
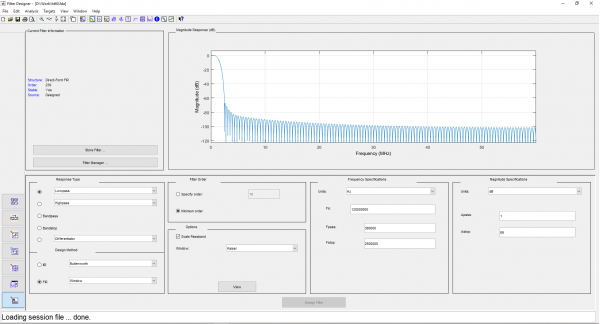
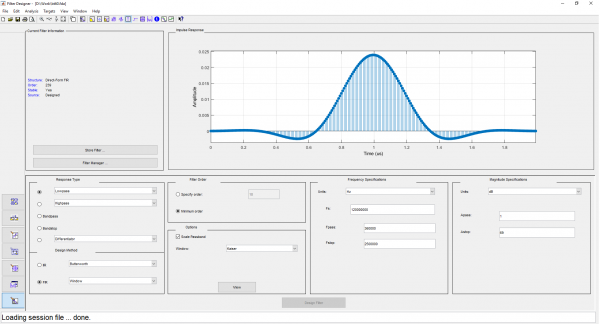
За филтри с настройка 1 MHz ще изберем пропускателна лента на LPF (половината на пропускателната лента на филтъра) от 500 kHz, а дължината на импулсната характеристика ще настроим на 480 отводи. За филтри с настройка 2 MHz тези параметри ще изберем 1 MHz и 240 отводи, съответно. Типът на прозореца избираме на Кайзера. Ще изчислим импулсните характеристики в filterDesigner и ще ги експортираме във формат C-header:
Снимки от filterDesigner
Може да се реши проблемът директно: да се изгради масив DDC, съответстващ на броя на филтрите (). Този подход е добър за FPGA, където може да се спести енергия чрез намаляване на разрядността на изчислителите в първите стъпки. Освен това, FPGA е най-енергийно ефективният начин за реализиране. Но трудоемкостта при този метод е най-висока.
При изпълнението на филтровата решетка на популярни днес GPU, се появява възможност да се реализира по-сложен алгоритъм: полифазна филтрова решетка на базата на БПФ, който на CUDA е наличен в библиотеката. В чуждестранната литература алгоритмът се нарича Polyphase или WOLA (Weight, Overlap and Add) FFT Filterbank. Липсата на време за рисуване не ми позволява да изпълня визуално обяснение самостоятелно. В мрежата има много материали по темата, особено на осезаем график, изпълнен на страница 11 (огромно благодаря на уважаваните автори), ето го:
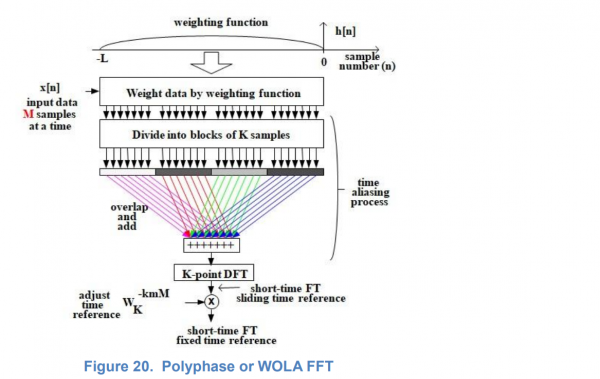
Ще се опитам да обясня схемата на обработка със собствените си думи. Слабонервните да не четат.
Ще се опитам да обясня схемата на обработка със свои думи в рамките на моите методически възможности. БПФ е свързването на входния сигнал с целия спектър от комплексни ортогонални хармоници, които се побират в интервала на импулсната характеристика. Импулсната характеристика на филтъра, на която се умножава сигналът преди входа на БПФ, се модулира от този спектър на хармониците. С други думи, обвивката на импулсните характеристики на резултатните филтри на решетката се изнася извън скобите. След това спектърът от хармоники се редуцира в определен брой пъти, поради разширяването на пропускателната лента на филтъра спрямо филтъра с правоъгълно прозорец. На рисунка виждаме редуциране на четири. С други думи, след разширяването на лентата с прозореца на Кайзера (с едновременно увеличаване на загасването в задържащата лента), вече не са необходими всички филтри, а единствено една четвърт от тях. Останалите са излишни, техните честотни характеристики се припокриват. Из четири последователни точки БПФ, избираме само нулевата, чийто изчисление е сумата на четирите
входни точки, взети след време, равно на четвърт от продължителността на изходния БПФ.
Избираме хардуера, който имаме под ръка. Това е входна платка на компанията "Инструментални Системи" FMC126P. За нея вече съм писал в една от предишните . В слота FMC на плате е поставен субмодул от същата компания с трансивер AD9371 с ширина 100 MHz. Целият поток от трансивера може да бъде непрекъснато предаден на компютър за обработка.
Избираме видеокарта с GPU GTX 1050. (Лъжа, тя ни избра: това е всичко, което беше под ръка, беше извадена от изчислителя за проектиране на антени, но толкова по-необичайно беше да видим работеща гребенка). Преминаваме към софтуерната част.
За съжаление, поради лицензионни ограничения не можем да публикуваме целия код. Можем да покажем само ядрото на GPU. Все пак, останалият код не е особено интересен.
Ето ядрото, което извършва умножение на сигнала заедно с прозорец и сумиране, и обвързването за неговото извикване:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
Кодът за обработка на сигнала, който извиква това ядро, напълно повтаря схемата на алгоритма, показана на изображението по-горе, затова не виждам смисъл да го представям тук.
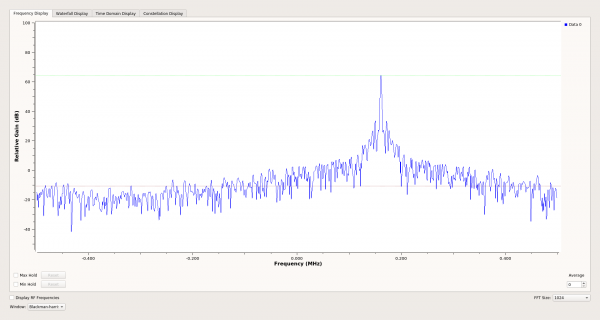
Гребенките бяха проверени на изходния спектър на каналите в реално време. На входа на AD9371 беше подаден сигнал от генератора на сигнали на 2450 MHz, селективността на филтрите съответстваше на изчисленията.
В плановете: адаптиране на софтуера за платката XRTX и реализиране на търсене на пакети, ако на някого му потрябва или ако остане свободно време.
Цялата работа по софтуера е извършена от , слава на него!
Източник: habr.com
