

Бъдещето е тук, технологиите на изкуствения интелект и машинното обучение вече успешно се използват от вашите любими магазини, транспортни компании и дори ферми, отглеждащи индийски пуешки.
Ако нещо съществува, значи в интернет вече има… открит проект! Вижте как Open Data Hub помага за мащабиране на новите технологии и избягване на трудности при внедряването им.
При всички предимства на изкуствения интелект (artificial intelligence, AI) и машинното обучение (machine learning, ML) организациите често срещат трудности при мащабирането на тези технологии. Основните проблеми обикновено са следните:
- Обмен на информация и сътрудничество – обменът на информация без излишни усилия и сътрудничеството в режим на бързи итерации практически е невъзможно.
- Достъп до данни – за всяка задача той трябва да се изгражда от нулата и ръчно, което отнема много време.
- Достъп по всяко време – няма възможност за получаване на on-demand достъп до инструментите и платфората за машинно обучение, както и до изчислителната инфраструктура.
- Производство – моделите остават на етап прототип и не достигат до промишлено внедряване.
- Проследяване и обяснение на резултатите от AI – възпроизведимостта, проследяването и обяснението на резултатите от AI/ML са затруднени.
Оставени без решение, тези проблеми негативно влияят на скоростта, ефективността и продуктивността на ценните специалисти по обработка и анализ на данни. Това води до тяхната фрустрация, разочарование от работата и в крайна сметка очакванията на бизнеса относно AI/ML се рушат.
Отговорността за решаването на тези проблеми лежи на ИТ-специалистите, които трябва да осигурят на дата-аналитиците – правилно, нещо като облак. По-подробно, необходима е платформа, която предлага свобода на избора и има удобен, лесен достъп. В същото време тя да е бърза, лесно настраиваемa, мащабируема при необходимост и устойчива на повреди. Изграждането на такава платформа на база технологии с отворен код помага да не попаднете в зависимост от доставчици и да запазите дългосрочно стратегическо предимство по отношение на контрола на разходите.
Преди няколко години нещо подобно се случваше в разработката на приложения и доведе до появата на микросервизи, хибридни облачни среди, ИТ автоматизация и agile процеси. За да се справят с всичко това, ИТ специалистите започнаха да използват контейнери, Kubernetes и отворени хибридни облаци.
Сега този опит се прилага за отговаряне на предизвикателствата в AI. Затова ИТ специалистите създават платформи, базирани на контейнери, които позволяват създаването на AI/ML услуги в рамките на agile процесите, ускоряват иновациите и са изградени с поглед към хибридното облако.
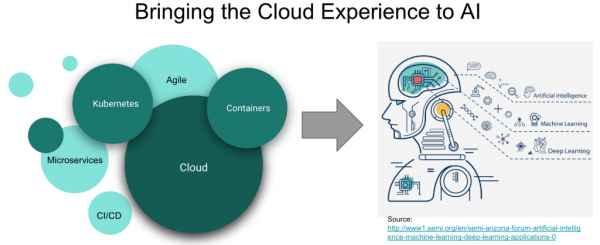
Изграждането на такава платформа ще започнем с Red Hat OpenShift, нашата контейнерна Kubernetes платформа за хибридно облако, която разполага с бързо развиваща се екосистема от софтуерни и хардуерни ML решения (NVIDIA, H2O.ai, Starburst, PerceptiLabs и др.). Някои от клиентите на Red Hat, като BMW Group, ExxonMobil и други, вече разгръщат контейнеризирани ML инструменти и DevOps процеси на базата на тази платформа и нейната екосистема, за да изведат своите ML архитектури в режим на промишлена експлоатация и да ускорят работата на данни анализатори.
Още една причина, поради която стартирахме проекта Open Data Hub, е да демонстрираме пример за архитектура на базата на няколко проекта с отворен код и да покажем как да реализираме целия жизнен цикъл на ML решение на базата на платформата OpenShift.
Проект Open Data Hub
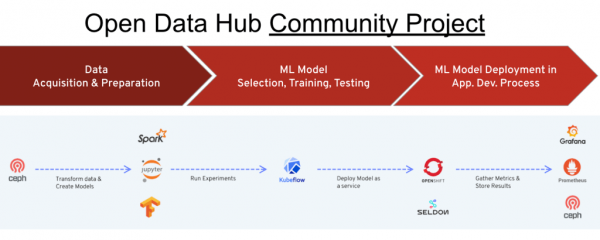
Това е проект с отворен код, който се развива в рамките на съответната общност за разработка и реализира целия цикъл на операции – от зареждането и преобразуването на първични данни до формулирането, обучението и поддръжката на модела – при решаване на задачи AI/ML с помощта на контейнери и Kubernetes на платформата OpenShift. Този проект може да се разглежда като референтна реализация, пример за това как да създадете отворено решение от клас „AI/ML като услуга“ на базата на OpenShift и съответните инструменти с отворен код, като Tensorflow, JupyterHub, Spark и др. Важно е да се подчертае, че Red Hat самата използва този проект за предоставяне на своите услуги AI/ML. Освен това OpenShift се интегрира с ключови софтуерни и хардуерни ML решения от NVIDIA, Seldon, Starbust и други доставчици, което улеснява изграждането и стартирането на собствени системи за машинно обучение.
Проект Open Data Hub е насочен към следните категории потребители и сценарии на употреба:
- Данни аналитик, който се нуждае от облачно решение за реализиране на ML проекти с функции за самообслужване.
- Данни аналитик, който иска максимален избор от най-новите инструменти и платформи с отворен код за AI/ML.
- Данни аналитик, който се нуждае от достъп до източниците на данни при обучението на модели.
- Данни аналитик, който се нуждае от достъп до изчислителни ресурси (CPU, GPU, памет).
- Данни аналитик, който се нуждае от възможността да сътрудничи и обменя резултати с колеги, получава обратна връзка и прави подобрения с бързи итерации.
- Данни аналитик, който иска да взаимодействия с разработчиците (и екипите devops), за да гарантира, че неговите ML модели и резултати от работа влизат в продукция.
- Инженер по данни, който трябва да осигури на данни аналитика достъп до разнообразни източници на данни, спазвайки нормите и изискванията за безопасност.
- Администратор/оператор на ИТ системи, който се нуждае от възможността да контролира жизнения цикъл (инсталиране, конфигуриране, обновяване) на компоненти и технологии с отворен код без излишни усилия. И също са необходими съответните инструменти за управление и квотиране.
Проектът Open Data Hub обединява множество инструменти с отворен код за изпълнение на целия цикъл от операции AI/ML. Основният работен инструмент за данни аналитика тук е Jupyter Notebook. Този инструмент днес е много популярен сред специалистите по обработка и анализ на данни, а Open Data Hub им дава възможност лесно да създават и управляват работни пространства Jupyter Notebook, използвайки интегрирания JupyterHub. Освен създаването и импортирането на Jupyter notebooks, проектът Open Data Hub включва и набор от готови notebooks под формата на AI Library.
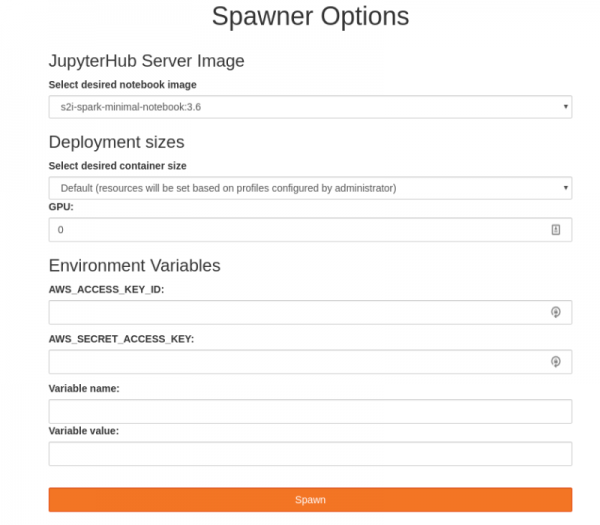
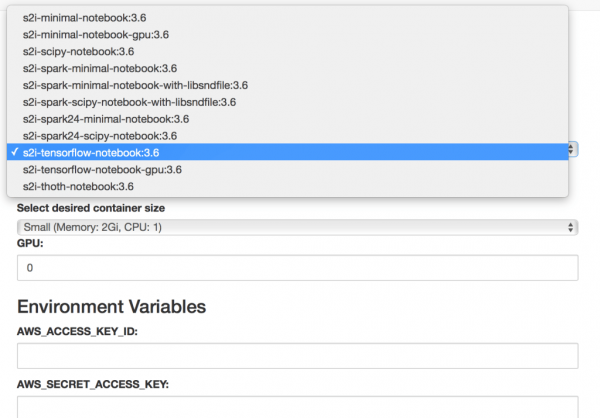
Тази библиотека е колекция от open-source компоненти за машинно самообучение и решения за типични сценарии, които опростяват бързото прототипиране. JupyterHub е интегриран с RBAC модел на достъп в OpenShift, който позволява използването на вече съществуващи OpenShift акаунти и реализира единен вход. Освен това, JupyterHub предлага удобен потребителски интерфейс, наречен spawner, чрез който потребителят може лесно да настрои обема на изчислителните ресурси (процесорни ядра, памет, GPU) за избрания Jupyter Notebook.
След като дата-аналитикът създаде и настрои ноутбука, всички останали ангажименти по него поема Kubernetes планировчика, който е част от OpenShift. Потребителите просто трябва да провеждат своите експерименти, да запазват и споделят резултатите от работата си. Освен това, напредналите потребители могат да се обръщат директно към CLI интерфейса на OpenShift от Jupyter notebooks, за да активират Kubernetes примитиви като Job или функционалността на OpenShift, например Tekton или Knative. В противен случай, могат да използват удобния графичен интерфейс на OpenShift, наречен "веб-конзола на OpenShift".
Преминавайки към следващия етап, Open Data Hub предоставя възможност за управление на конвейерите за данни (data pipelines). За това се използва Ceph обект, предоставен под формата на S3-совместимо обектно хранилище за данни. Apache Spark осигурява стрийминг на данни от външни източници или вграденото хранилище Ceph S3, както и позволява извършване на предварителни преобразования на данните. Apache Kafka предлага разширено управление на конвейерите за данни (където могат да се извършват многократни зареждания, както и операции по преобразоване, анализ и запазване на данните).
И така, дата-аналитикът е получил достъп до данните и е построил модел. Сега той иска да сподели получените резултати с колегите или разработчиците на приложения, предоставяйки им своя модел на принципа на услугата. За това е необходим изходен сървър, и Open Data Hub разполага с такъв, наречен Seldon, който позволява публикуването на модела под формата на RESTful услуга.
В某个阶段,Seldon服务器上出现了多个此类模型,因此需要监控它们的使用情况。为此,Open Data Hub提供了相关指标的集合以及基于广泛使用的开源监控工具Prometheus和Grafana的报告引擎。最终,我们获得了用于监控AI模型使用的反馈,特别是在生产环境中。
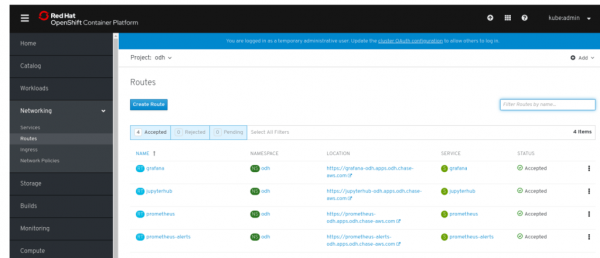
因此,Open Data Hub在整个AI/ML操作周期内提供了一种类云的解决方案,从数据访问和准备开始,到模型的训练和工业应用结束。
Събираме всичко в едно
现在问题是,OpenShift管理员如何组织这一切。在这方面,Open Data Hub项目的专用Kubernetes操作员发挥了作用。
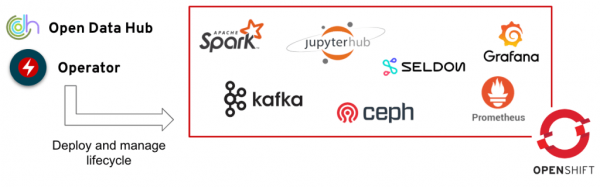
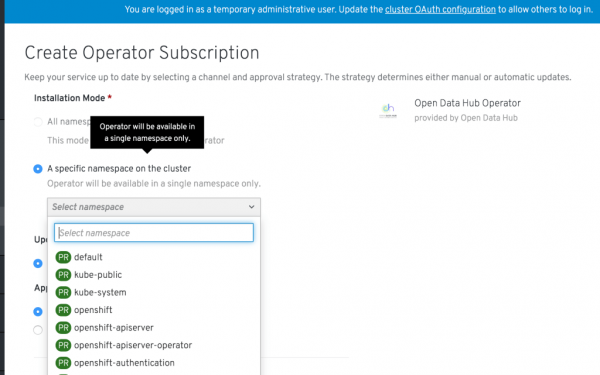
该操作员负责Open Data Hub项目的安装、配置和生命周期管理,包括部署上述工具,如JupyterHub、Ceph、Spark、Kafka、Seldon、Prometheus和Grafana。在OpenShift的Web控制台中,可以找到Open Data Hub项目,属于社区操作员一类。因此,OpenShift管理员可以指定相应的OpenShift项目属于“Open Data Hub项目”类别。这一步骤只需要进行一次。之后,数据分析师通过OpenShift的Web控制台进入他的项目空间,看到相应的Kubernetes操作员已为他的项目安装和可用。然后,他只需轻点一下即可创建Open Data Hub项目的实例,并立即获得上述工具的访问权限。所有这些都可以在高可用性和容错的模式下进行配置。
如果您想亲自尝试Open Data Hub项目,请从 开始。有关Open Data Hub架构的技术详细信息可以在 找到,项目发展的计划是 。未来,计划实现与Kubeflow的额外集成,解决数据管理和安全性的问题,以及与基于规则的Drools和Optaplanner系统进行集成。您可以在 的页面上表达您的意见并参与项目 .
Резюмираме: сериозни проблеми с мащабируемостта пречат на организациите да реализират напълно потенциала на изкуствения интелект и машинното обучение. Red Hat OpenShift отдавна и успешно се използва за решаване на подобни проблеми в софтуерната индустрия. Проектът Open Data Hub, реализиран в рамките на обществото за разработка с отворен код, предлага референтна архитектура за организиране на целия цикъл на операции AI/ML на базата на хибридното облако OpenShift. Имаме ясен и обмислен план за развитие на този проект и сериозно сме настроени да създадем активно и плодотворно общество за разработка на отворени AI решения на платформата OpenShift.
Източник: habr.com
