

Днес ще поговорим за това как по-добре да съхраняваме данни в свят, в който мрежите от пето поколение, геномните скенери и безпилотните автомобили произвеждат на ден повече данни, отколкото човечеството е създало до индустриалната революция.
Нашият свят генерира все повече информация. Част от нея е мимолетна и се губи толкова бързо, колкото се събира. Друга трябва да се съхранява по-дълго, а трета е предназначена за 'векове' — най-малкото, така ни изглежда в настоящето. Информационните потоци се натрупват в дата центровете с такава скорост, че всеки нов подход, всяка технология, предназначена да задоволи този безкраен 'търсене', бързо остаряват.
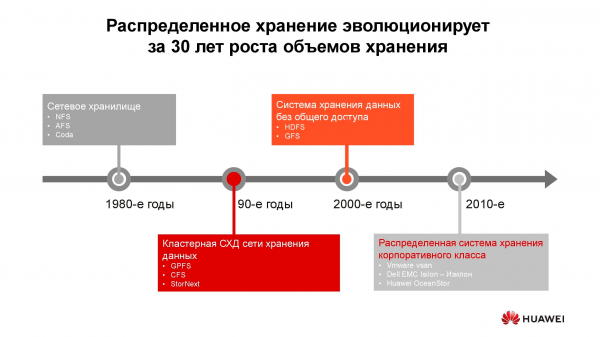
40 години развитие на разпределени СХД
Първите мрежови хранилища в познатия ни вид се появяват през 80-те години. Мнозина от вас са се сблъсквали с NFS (Network File System), AFS (Andrew File System) или Coda. След десетилетие модата и технологиите се променят, а разпределените файлови системи отстъпват място на кластерни СХД на базата на GPFS (General Parallel File System), CFS (Clustered File Systems) и StorNext. Като основа се използват блочни хранилища с класическа архитектура, върху които с помощта на софтуерен слой се създава единна файловата система. Тези и подобни решения все още се прилагат, заемат своята ниша и са напълно търсени.
На прага на хилядаелетието парадигмата на разпределените хранилища се промени, и на водещи позиции излязоха системи с архитектура SN (Shared-Nothing). Се случи преход от кластерно съхранение към съхранение на отделни възли, като през тях обикновено минават класически сървъри с осигуряващ надеждно съхранение софтуер; на такива принципи са построени, да речем, HDFS (Hadoop Distributed File System) и GFS (Global File System).
Към 2010 година, концепциите, заложени в основата на разпределените системи за съхранение, все по-често намират отражение в пълноценни търговски продукти, като VMware vSAN, Dell EMC Isilon и нашата . Зад споменатите платформи вече не стои общност от ентусиасти, а конкретни вендори, които отговарят за функционалността, поддръжката, сервизното обслужване на продукта и гарантират неговото по-нататъшно развитие. Такива решения са най-търсени в няколко сфери.
Оператори на връзки
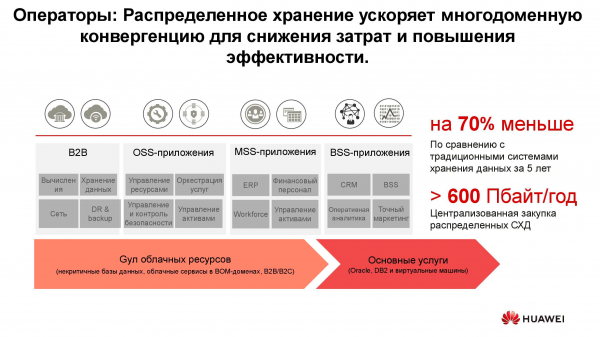
Вероятно, одними из самых старых пользователей распределенных систем хранения являются операторы связи. На схеме видно, какие группы приложений производят основной объем данных. OSS (Operations Support Systems), MSS (Management Support Services) и BSS (Business Support Systems) представляют собой три взаимодополняющих программных слоя, необходимых для предоставления сервиса абонентам, финансовой отчетности провайдеру и технической поддержки инженерам оператора.
Часто данные этих слоев сильно переплетены друг с другом, и, чтобы избежать накопления ненужных копий, используются распределенные хранилища, которые аккумулируют весь объем информации, поступающей от активной сети. Хранилища объединяются в общий пул, к которому обращаются все сервисы.
Наши расчеты показывают, что переход от классических СХД к блочным позволяет сэкономить до 70% бюджета только за счет отказа от выделенных СХД класса hi-end и использования обычных серверов классической архитектуры (обычно x86), работающих в сочетании со специализированным ПО. Мобильные операторы уже довольно давно начали приобретать подобные решения в значительных объемах. В частности, российские операторы используют такие продукты от Huawei более шести лет.
Да, ряд задач с помощью распределенных систем выполнить не получится. Например, при повышенных требованиях к производительности или совместимости со старыми протоколами. Но не менее 70% данных, которые обрабатывает оператор, вполне возможно разместить в распределенном пуле.
Банковски сектор
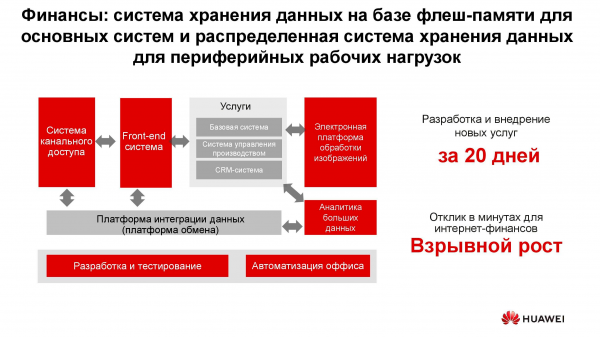
В любом банке сосуществует множество разнообразных IT-систем, начиная с процессинга и заканчивая автоматизированной банковской системой. Эта инфраструктура также работает с огромным объемом информации, при этом большая часть задач не требует высокой производительности и надежности систем хранения, например разработка, тестирование, автоматизация офисных процессов и т.д. Здесь применение классических СХД возможно, но с каждым годом становится все менее выгодным. Кроме того, в этом случае отсутствует гибкость в расходовании ресурсов СХД, производительность которой рассчитывается исходя из пиковой нагрузки.
При използване на разпределени системи за съхранение, техните възли, които всъщност са обикновени сървъри, могат по всяко време да бъдат конвертирани, например, в сървърна ферма и да се използват като изчислителна платформа.
Данни от езера
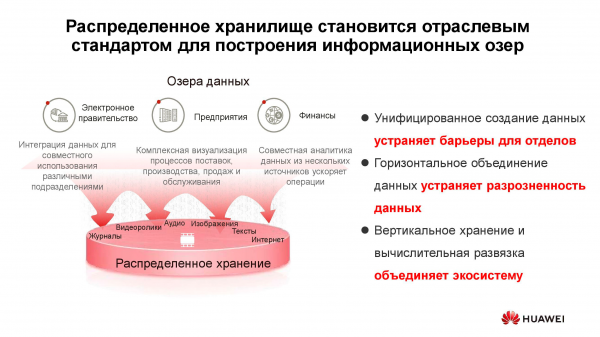
На схемата по-горе е показан списък на типични потребители на услуги . Това могат да бъдат електронни правителствени служби (например, „Госуслуги“), преминали цифровизация, финансови структури и др. Всички те трябва да работят с големи обеми разнородна информация.
Експлоатацията на класическите СХД за решаване на такива задачи е неефективна, тъй като е необходим както високо производителен достъп до блокови бази данни, така и обикновен достъп до библиотеки със сканирани документи, съхранявани като обекти. Тук може да бъде свързана и, да речем, система за поръчки чрез уеб портал. За да реализирате всичко това на платформа с класическа СХД, ще е необходим голям комплект оборудване за различни задачи. Една хоризонтална универсална система за съхранение може напълно да покрие всички изброени задачи: нужно е само да се създадат в нея няколко пулове с различни характеристики за съхранение.
Генератори на нова информация
Количество на съхраняваната в света информация расте с около 30% годишно. Това е добра новина за доставчиците на системи за съхранение, но какво е и ще бъде основният източник на тези данни?
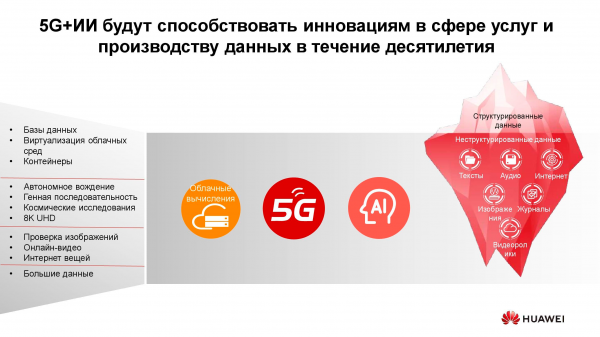
Десет години по-рано такива генератори станаха социалните мрежи, което изискваше създаването на голям брой нови алгоритми, хардуерни решения и т.н. В момента се открояват три основни двигатели на растежа на обемите на съхранение. Първият — облачните услуги. В момента около 70% от компаниите така или иначе използват облачни услуги. Това могат да бъдат електронни пощенски системи, резервни копия и други виртуализирани единици.
Вторият двигател са мрежите от пето поколение. Това са нови скорости и нови обеми на предаване на данни. Според нашите прогнози, широкото разпространение на 5G ще доведе до спад в търсенето на флеш карти. Колкото и памет да има в телефона, все пак тя свършва, а при наличие на 100 мегабитен канал в устройството няма никаква необходимост да се съхраняват снимки локално.
К третата група причини, поради които нараства търсенето на системи за съхранение, принадлежи стремглавото развитие на изкуствения интелект, преминаването към аналитика на големи данни и тенденцията за всеобща автоматизация на всичко, което е възможно.
Характерна особеност на "новия трафик" е . Трябва да съхраняваме тези данни, без да определяме формата им. Той е необходим само при последващо четене. Например, банковата система за оценка на кредитоспособността ще разглежда публикуваните от вас снимки в социалните мрежи, определяйки колко често посещавате морето и ресторанти, и същевременно ще изучава наличните удостоверения от медицинските ви документи. Тези данни, от една страна, са всеобхватни, а от друга — лишени от еднородност.
Океан от неструктурирани данни
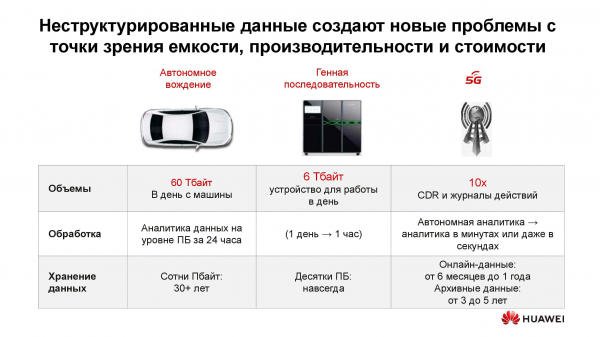
Какви проблеми предизвиква появата на "нови данни"? Най-важният от тях, разбира се, е самият обем информация и сроковете за нейно съхранение. Само един съвременен автономен автомобил без шофьор генерира до 60 TB данни всеки ден, идващи от всички негови сензори и механизми. За разработването на нови алгоритми за движение, тази информация трябва да бъде обработена в същия ден, иначе започва да се натрупва. В същото време, тя трябва да се съхранява много дълго — десетилетия. Само тогава в бъдеще ще може да се правят заключения на базата на големи аналитични извадки.
Едно устройство за декодиране на генетични последователности генерира около 6 TB на ден. А данните, събрани с неговата помощ, изобщо не предвиждат изтриване, тоест хипотетично трябва да се съхраняват вечно.
Най-накрая, същите мрежи от пето поколение. Освен самата предавана информация, такава мрежа е и огромен генератор на данни: журнали на действия, записи на обаждания, междинни резултати от взаимодействия между машини и пр.
Всичко това изисква разработването на нови подходи и алгоритми за съхранение и обработка на информация. И такива подходи вече се появяват.
Технологии на новата епоха
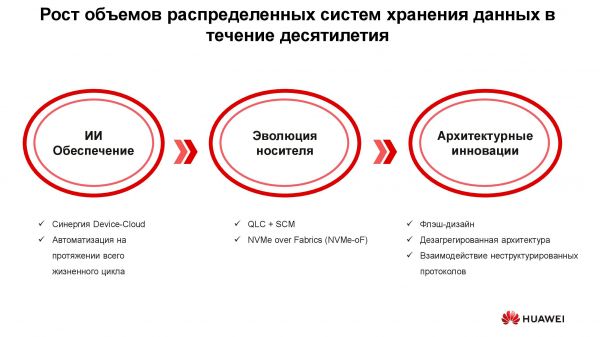
Могат да се разграничат три групи решения, предназначени да се справят с новите изисквания към системите за съхранение на информация: внедряване на изкуствен интелект, техническа еволюция на носителите на данни и иновации в областта на системната архитектура. Нека започнем с ИИ.
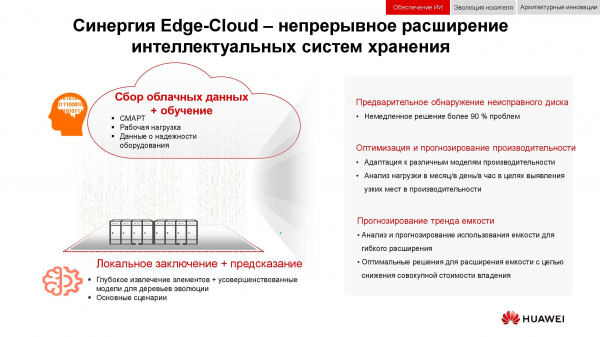
В новите решения на Huawei изкуственият интелект вече се използва на ниво самото хранилище, което е оборудвано с AI процесор, позволяващ на системата сама да анализира състоянието си и да предсказва повреди. Ако системата за съхранение бъде свързана с облачен сервис, разполагащ със значителни изчислителни способности, изкуственият интелект ще може да обработва повече информация и да увеличи точността на своите хипотези.
Освен повреди, този AI може да прогнозира бъдещия пик на натоварване и времето, оставащо до изчерпване на капацитета. Това позволява оптимизиране на производителността и разширяване на системата преди настъпването на нежелани събития.
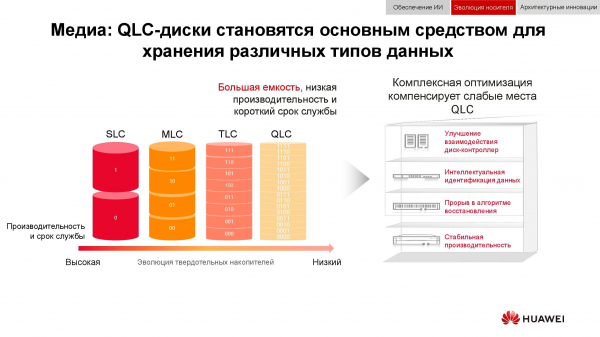
Сега за еволюцията на носителите на данни. Първите флаш памети бяха изработени по технологията SLC (Single-Level Cell). Устройствата, базирани на нея, бяха бързи, надеждни и стабилни, но имаха малък капацитет и цената им беше много висока. Ростът на обема и намалението на цената беше постигнато чрез определени технически компромиси, поради които скоростта, надеждността и срокът на служба на носителите бяха намалени. Независимо от това, тенденцията не повлия на самите системи за съхранение, които благодарение на различни архитектурни хитрости стана и по-производителни, и по-надеждни.
Но защо бяха необходими системи за съхранение от клас All-Flash? Нима не беше достатъчно просто да замените старите HDD в експлоатираната система с нови SSD от същия форм-фактор? Това беше необходимо, за да се използват ефективно всички ресурси на новите твърдотелни носители, нещо, което в старите системи просто не беше възможно.
Компанията Huawei, например, разработи цял набор от технологии за решаване на тази задача, една от които стана , позволяваща максимална оптимизация на взаимодействията „диск — контролер“.
Интелигентната идентификация даде възможност за разпределяне на данните на няколко потока и справяне с редица нежелани явления, като (управление на записите). В същото време новите алгоритми за възстановяване, в частност , увеличиха скоростта на ребилда, съкращавайки времето му до напълно незначителни величини.
Повреди, претоварване, „събиране на боклук“ — тези фактори вече не влияят на производителността на системата за съхранение благодарение на специално усъвършенстване на контролерите.
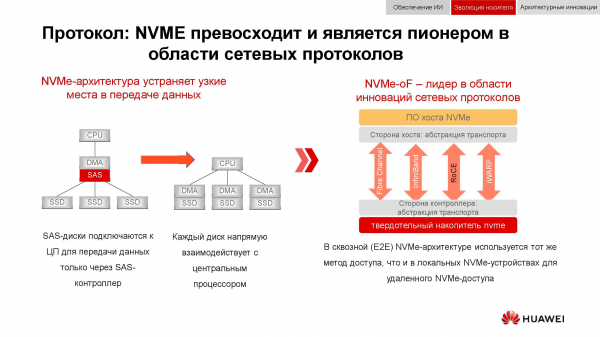
А също така блоковите хранилища за данни се подготвят да посрещнат . Да припомним, че класическата схема за организация на достъпа до данни е работела така: процесорът е взаимодействал с RAID контролера през шина PCI Express. Той, от своя страна, комуникира с механичните дискове чрез SCSI или SAS. Използването на NVMe на бекенда значително ускори целия процес, но имаше един недостатък: устройствата трябваше да имат непосредствено свързване с процесора, за да му осигурят директен достъп до паметта.
Следващата фаза в развитието на технологията, която наблюдаваме сега, е приложението на NVMe-oF (NVMe over Fabrics). Относно блоковите технологии на Huawei, те вече поддържат FC-NVMe (NVMe over Fibre Channel), а на път е NVMe over RoCE (RDMA over Converged Ethernet). Тестовите модели са напълно функционални, остава само няколко месеца до официалната им презентация. Забележете, че всичко това ще се появи и в разпределените системи, където „Ethernet без загуби“ ще бъде изключително търсен.
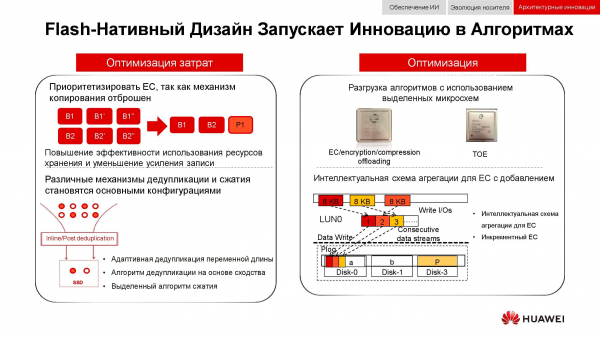
Допълнителен начин за оптимизиране на работата именно на разпределените хранилища е пълното отказване от дублиране на данните. Решенията на Huawei вече не използват n копия, както в познатия RAID 1, и изцяло преминават на механизъм (Erasure coding). Специален математически пакет с определена периодичност изчислява контролни блокове, които позволяват възстановяване на междинни данни в случай на загуба.
Механизмите за дедубликация и компресия стават задължителни. Ако в класическите СХД сме ограничени от броя на инсталираните в контролерите процесори, то в разпределените хоризонтално мащабируеми системи за съхранение всеки възел съдържа всичко необходимо: дискове, памет, процесори и интерконект. Тези ресурси са достатъчни, за да оказват дедубликацията и компресията минимално влияние върху производителността.
И за апаратните методи за оптимизация. Тук натоварването на централните процесори е намалено с помощта на допълнителни специфични микросхеми (или отделни блокове в самия процесор), играещи ролята на (TCP/IP Offload Engine) или поемат математическите задачи на EC, дедубликацията и компресията.
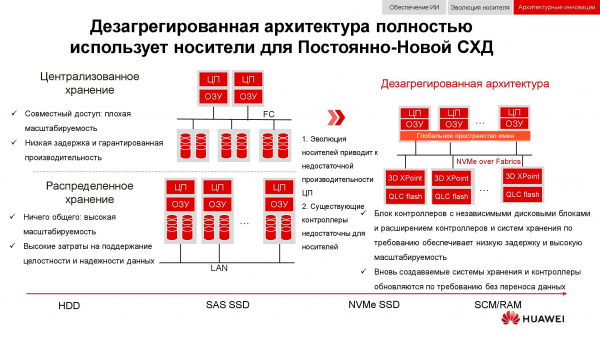
Новите подходи за съхранение на данни намират израз в дезагрегирана (разпределена) архитектура. В системите за централизирано съхранение има фабрика от сървъри, свързани чрез Fibre Channel с голям брой масиви. Недостатъците на този подход са трудностите при мащабирането и осигуряването на гарантирано ниво на услуга (по производителност или закъснения). Хиперконвергентните системи използват едни и същи хостове – както за съхранение, така и за обработка на информация. Това предоставя практически неограничено пространство за мащабиране, но води до високи разходи за поддържане на целостта на данните.
В отличие от двете посочени по-горе, дезагрегирана архитектура подразбира разделяне на системата на изчислителна фабрика и хоризонтална система за съхранение. Това осигурява предимствата на двете архитектури и позволява практически неограничено мащабиране само на елемента, на който му липсва производителност.
От интеграция към конвергенция
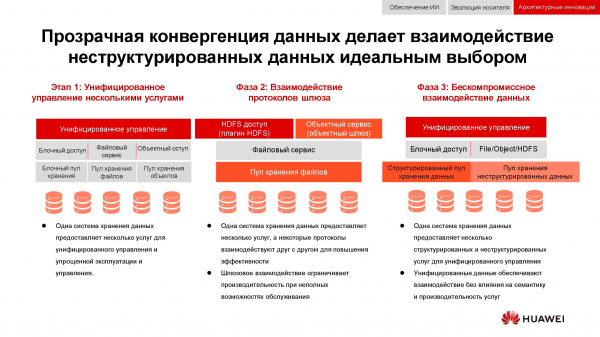
Класическа задача, чиято актуалност през последните 15 години само порасна, е необходимостта едновременно да се осигури блочно съхранение, файлов достъп, достъп до обекти, работа на ферма за големи данни и т.н. Вишенката на тортата може да бъде и система за резервно копиране на магнитна лента.
На първия етап успявахме да унифицираме само управлението на тези услуги. Разнородните системи за съхранение на данни бяха обвързани с някакъв специализиран софтуер, чрез който администраторът разпределяше ресурсите от наличните пулове. Но тъй като хардуерно тези пулове бяха различни, миграцията на натоварването между тях беше невъзможна. На по-високо ниво на интеграция, обединението се извършваше на ниво шлюз. При наличие на общ файлов достъп, той можеше да се предоставя през различни протоколи.
Най-съвършеният от наличните в момента методи за конвергенция подразбира създаването на универсална хибридна система. Именно такава, каквато трябва да стане нашата . Универсалният достъп използва същите апаратни ресурси, логически разделени на различни пули, но допускащи миграция на натоварването. Всичко това може да се извърши чрез единна управляваща конзола. По този начин успяхме да реализираме концепцията „един ЦОД — една СХД“.
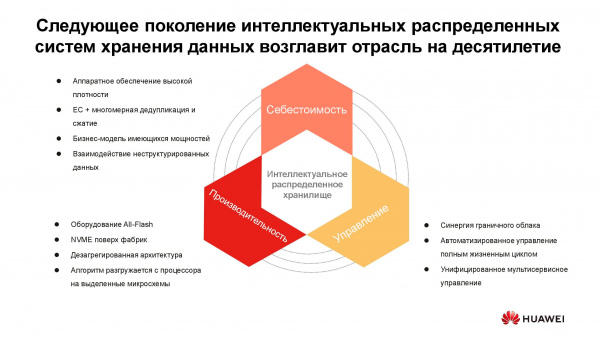
Цената на съхранение на информация в момента определя много архитектурни решения. И въпреки че може смело да се постави в центъра, днес обсъждаме „живото“ съхранение с активен достъп, така че производителността също трябва да се вземе предвид. Друго важно свойство на следващото поколение разпределени системи е унификацията. Никой не иска да има множество разпокъсани системи, управлявани от различни конзоли. Всички тези качества бяха реализирани в новата серия продукти на Huawei. .
Масивна СХД от ново поколение
OceanStor Pacific отговаря на изискванията за надеждност на ниво „шест деветки“ (99,9999%) и може да се използва за изграждане на ЦОД клас HyperMetro. При разстояние между два дата центъра до 100 км системите демонстрират допълнителна забавяне на ниво 2 мс, което позволява изграждане на всякакви решения за устойчивост при бедствия, включително и с quorum-сървъри.
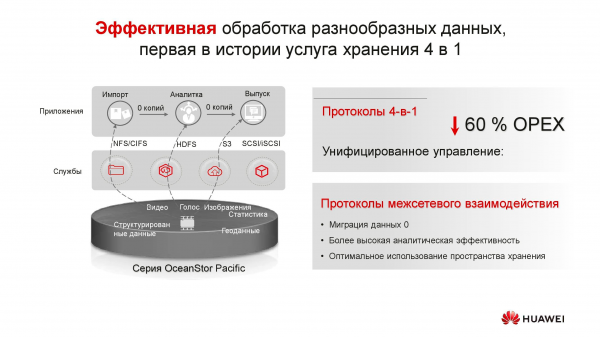
Продуктите от новата серия показват универсалност по протоколите. Вече сега OceanStor 100D поддържа блоков достъп, обектен достъп и достъп Hadoop. Скоро ще бъде реализиран и файлов достъп. Няма нужда да съхранявате множество копия на данни, ако могат да се предоставят чрез различни протоколи.
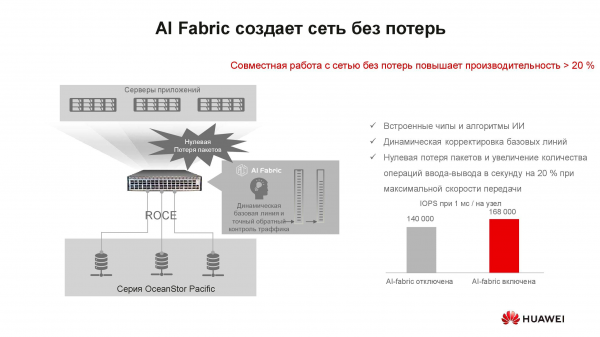
На пръв поглед, каква връзка има концепцията „мрежа без загуби“ със СХД? Факт е, че разпределените системи за съхранение на данни се изграждат на база бърза мрежа, поддържаща съответните алгоритми и механизъм RoCE. Допълнително увеличаване на скоростта на мрежата и намаляване на закъсненията помага на системата за изкуствен интелект, поддържана от нашите комутатори. . Увеличението на производителността на СХД при активиране на AI Fabric може да достигне 20%.
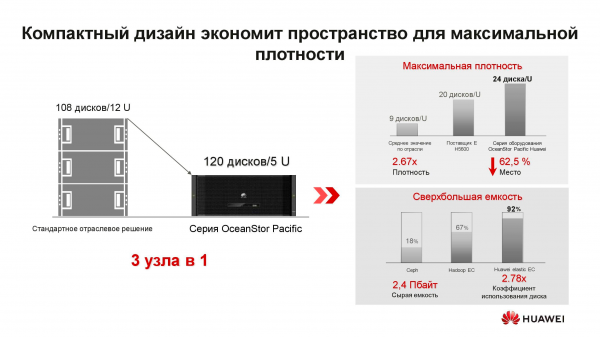
Какво представлява новият възел на разпределената СХД OceanStor Pacific? Решението с форм-фактор 5U включва 120 дискови устройства и може да замени три класически възела, което дава повече от двукратно спестяване на място в шкафа. Благодарение на отказа от съхранение на копия, ефективността на дисковите устройства се увеличава значително (до +92%).
Станахме свикнали, че софтуерно определените СХД е специализирано ПО, инсталирано на класически сървъри. Но сега, за да достигнем оптимални параметри, това архитектурно решение изисква и специализирани възли. В него влизат два сървъра, базирани на ARM процесори, които управляват масив от тридюймови носители.
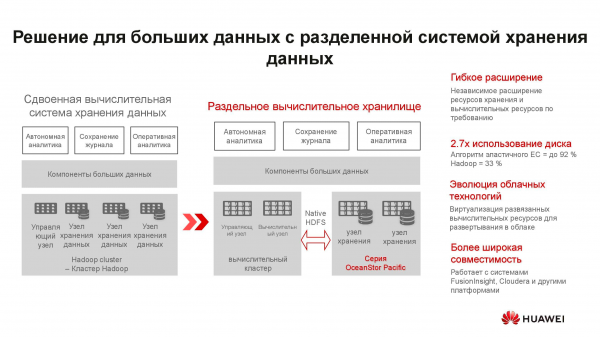
Тези сървъри не са подходящи за хиперконвергентни решения. Първо, приложенията за ARM са сравнително малко, а второ, трудно е да се постигне баланс на натоварването. Препоръчваме да преминете към разделено съхранение: изчислителен клъстер, представен от класически или ракови сървъри, функционира независимо, но се свързва с възлите за съхранение OceanStor Pacific, които също изпълняват свои директни задачи. И това се оправдава.
Например, да вземем класическо решение за съхранение на големи данни с хиперконвергентна система, заемаща 15 серийни стелажа. Ако разпределим натоварването между отделни изчислителни сървъри и възлите на СХД OceanStor Pacific, отделяйки ги един от друг, броят на необходимите стелажи ще намалее наполовина! Това намалява разходите за експлоатация на датацентъра и общата стойност на притежание. В свят, където обемът на съхраняваната информация нараства с 30% годишно, подобни предимства не се пренебрегват.
***
Повече информация за решенията на Huawei и сценарии за тяхното приложение можете да получите на нашия или като се свържете направо с представителите на компанията.
Източник: habr.com
