

Публикувах го в Github .
Това е проста хэш-таблица за GPU, способна да обработва стотици милиони вмъквания в секунда. На моя лаптоп с NVIDIA GTX 1060 кодът вмъква 64 милиона случайно генерирани двойки ключ-стойност за около 210 мс и изтрива 32 милиона двойки за около 64 мс.
Така че скоростта на лаптопа е около 300 милиона вмъквания/сек и 500 милиона изтривания/сек.
Таблицата е написана на CUDA, но същата методика може да се приложи и за HLSL или GLSL. Реализацията има няколко ограничения, осигуряващи висока производителност на видеокартата:
- Обработват се само 32-битови ключове и същите стойности.
- Хэш-таблицата има фиксиран размер.
- И този размер трябва да бъде равен на две на степен.
За ключове и стойности е необходимо да се резервира прост разделител (в предоставения код това е 0xffffffff).
Хэш-таблица без блокировки
В хэш-таблицата се използва отворена адресация с , тоест това е просто масив от двойки ключ-стойност, който се съхранява в паметта и има отлична производителност на кеша. Това не може да се каже за свързването в верига, което предполага търсене на указател в свързан списък. Хэш-таблицата е прост масив, който съхранява елементи KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Размерът на таблицата е степен на две, а не просто число, защото за прилагане на pow2/AND-маска е необходима само една бърза инструкция, а операторът модул работи много по-бавно. Това е важно при линейно зондирване, тъй като при линейно търсене в таблицата индексът на слота трябва да бъде обвит във всеки слот. В резултат на това се добавя разходът на операцията по модул за всеки слот.
Таблицата съхранява само ключ и стойност за всеки елемент, а не хэш на ключа. Тъй като таблицата съхранява само 32-битови ключове, хэшът се изчислява много бързо. В предоставения код се използва хэш Murmur3, който извършва само няколко смени, XOR-ове и умножения.
В хеш-таблицата се прилага метод за защита от блокировки, който не зависи от реда на разполагане в паметта. Дори ако някои операции на запис нарушават последователността на други подобни операции, хеш-таблицата все пак ще запази правилното си състояние. За това ще поговорим по-долу. Методиката работи отлично с графични карти, в които конкурентно се изпълняват хиляди потоци.
Ключовете и стойностите в хеш-таблицата се инициализират като празни.
Кодът може да бъде модифициран, за да обработва и 64-битови ключове и стойности. За ключовете са необходими атомни операции за четене, запис и сравнение с размяна (compare-and-swap). А за стойностите са нужни атомни операции за четене и запис. За щастие, в CUDA операциите за четене и запис за 32- и 64-битови стойности са атомни, стига да са естествено подравнени (вж. ), а съвременните графични карти поддържат 64-битови атомни операции за сравнение с размяна. Разбира се, при преминаване на 64 бита производителността леко ще намалее.
Състояние на хеш-таблицата
Всяка двойка ключ-стойност в хеш-таблицата може да има едно от четирите състояния:
- Ключът и стойността са празни. В такова състояние хеш-таблицата се инициализира.
- Ключът е записан, а стойността все още не е. Ако друг поток за изпълнение прочете данните в този момент, той ще върне празна стойност. Това е нормално, същото би се случило, ако друг поток за изпълнение е изтекъл малко по-рано, а ние говорим за конкурентна структура от данни.
- Записани са и ключът, и стойността.
- Стойността е достъпна за други потоци за изпълнение, а ключът все още не е. Такова нещо може да се случи, защото моделът на програмиране в CUDA предвижда слабо подреден паметен модел. Това е нормално, при всяко събитие ключът все още е празен, дори ако стойността вече не е.
Важно е да се отбележи, че веднъж когато ключът е записан в слота, той вече не се премества — дори ако ключът бъде изтрит, за което ще говорим по-долу.
Кодът на хеш-таблицата работи дори със слабо подредени паметни модели, в които не е известен редът на четене и запис в паметта. Когато разглеждаме вмъкването, търсенето и изтриването в хеш-таблицата, помнете, че всяка двойка ключ-стойност е в едно от четирите описани по-горе състояния.
Вмъкване в хеш-таблицата
CUDA функция, която вмъква двойки ключ-стойност в хеш таблица, изглежда така:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
За вмъкване на ключа, кодът итерира през масива на хеш таблицата, започвайки от хеша на вмъквания ключ. Във всеки слот на масива се извършва атомарна операция за сравнение с обмен, при която ключът в този слот се сравнява с празния. Ако се открие несъответствие, ключът в слота се обновява с вмъквания ключ, след което се връща оригиналният ключ на слота. Ако този оригинален ключ е бил празен или съвпадал с вмъквания ключ, значи кодът е намерил подходящия слот за вмъкване и внася в слота вмъкваната стойност.
Ако в един вызов на ядрото gpu_hashtable_insert() има няколко елемента с един и същ ключ, тогава всяка от техните стойности може да бъде записана в слота на ключа. Това се счита за нормално: една от операциите по запис на ключ-стойност в хода на извикването ще бъде успешна, но тъй като всичко това се случва паралелно в рамките на няколко изпълнителни потока, не можем да предвидим коя операция по запис в паметта ще бъде последна.
Търсене в хеш таблицата
Код за търсене на ключове:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
За да намерим стойността на ключа, съхраняваща се в таблицата, итерираме през масива, започвайки от хеша на искания ключ. Във всеки слот проверяваме дали ключът е този, който търсим, и ако да, връщаме неговата стойност. Също така проверяваме дали ключът е празен, и ако да, прекъсваме търсенето.
Ако не успеем да намерим ключа, кодът връща празна стойност.
Всички тези операции по търсене могат да се извършват конкурентно в хода на вмъквания и изтривания. Всяка двойка в таблицата ще има за потока едно от четирите описани по-горе състояния.
Изтриване в хеш таблицата
Код за изтриване на ключове:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Изтриването на ключа се извършва по необичайно: оставяме ключа в таблицата и маркираме стойността му (не самия ключ) като празна. Този код е много подобен на lookup(), с изключение на това, че при открито съвпадение по ключ той прави стойността му празна.
Както беше споменато по-горе, след като ключът бъде записан в слота, той вече не се премества. Дори и при изтриване на елемент от таблицата, ключът остава на място, просто стойността му става празна. Това означава, че не е необходимо да използваме атомарна операция за запис на стойността на слота, защото не е важно дали текущата стойност е празна или не – все пак ще стане празна.
Промяна на размера на хеш-таблицата
Размерът на хеш-таблицата може да бъде променен чрез създаване на по-голяма таблица и вмъкване на непразни елементи от старата таблица. Не реализирах тази функционалност, защото исках да запазя примера на кода прост. Освен това, в CUDA програми, разпределението на паметта често се извършва в хост кода, а не в CUDA ядрото.
В статията е описано как да се променя такава структура от данни, защитена от блокировки.
Конкурентност
В предоставените фрагменти от кодовите функции gpu_hashtable_insert(), _lookup() и _delete() обработват по една двойка ключ-стойност наведнъж. А по-долу gpu_hashtable_insert(), _lookup() и _delete() обработват масив от двойки паралелно, всяка двойка в отделен GPU поток на изпълнение:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Хеш-таблицата с защита от блокировки поддържа конкурентни вмъквания, търсения и изтривания. Тъй като двойките ключ-стойност винаги се намират в едно от четирите състояния, а ключовете не се преместят, таблицата гарантира правилност дори при едновременна употреба на операции от различен вид.
Все пак, ако паралелно обработваме пакет от вмъквания и изтривания, и ако входният масив от двойки съдържа дублирани ключове, тогава не можем да предсказваме кои двойки "побеждават" – ще бъдат записани в хеш-таблицата последни. Нека предположим, че извикахме кода за вмъкване с входен масив от двойки A/0 B/1 A/2 C/3 A/4. Когато кодът завърши, двойките B/1 и C/3 гарантирано ще присъстват в таблицата, но в нея ще бъде всяка от двойките A/0, A/2 или A/4Това може да бъде проблем, или не, в зависимост от приложението. Можете предварително да знаете, че във входния масив няма дублиращи се ключове, или да не ви е важно каква стойност е записана последно.
Ако това е проблем за вас, трябва да разделите дублиращите се двойки на различни системни CUDA повиквания. В CUDA всяка операция с повикване на ядро винаги завършва преди следващото повикване на ядро (поне в рамките на един поток. В различни потоци ядрата се изпълняват паралелно). Ако в примера по-горе се повика едно ядро с A/0 B/1 A/2 C/3, а друго с A/4, тогава ключът A ще получи стойност 4.
Сега да поговорим за това, дали функциите lookup() и delete() да използват прост (plain) или променлив (volatile) указател на масив от двойки в хеш таблица. твърди, че:
Компилаторът може по свое усмотрение да оптимизира операции по четене и запис в глобалната или общата памет… Тези оптимизации могат да бъдат деактивирани с помощта на ключовото слово
volatile: … всяко извикване на тази променлива се компилира в реална инструкция за четене или запис в паметта.
Съображенията за коректност не изискват прилагането на volatile. Ако потокът на изпълнение използва кеширана стойност от по-ранна операция по четене, това означава, че той ще използва малко остаряла информация. Но все пак, това е информация от коректно състояние на хеш таблицата в определен момент на повикването на ядрото. Ако трябва да използвате най-актуалната информация, можете да приложите указател volatile, но тогава малко ще намали производителността: по моите тестове, при изтриване на 32 млн. елементи, скоростта намаля от 500 млн. изтривания/сек до 450 млн. изтривания/сек.
Производителност
В теста за вмъкване на 64 млн. елементи и изтриване на 32 млн. от тях, конкуренцията между std::unordered_map и хеш таблицата за GPU фактически отсъства:
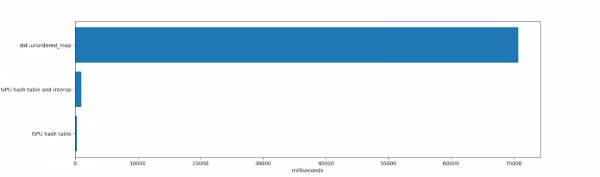
std::unordered_map поправи 70 691 мс за вмъкване и изтриване на елементи с последващо освобождаване на unordered_map (освобождаването от милиони елементи отнема доста време, тъй като в рамките на unordered_map се извършват многобройни операции за заделяне на памет). Честно казано, за std::unordered_map напълно различни ограничения. Това е единствен поток на изпълнение на CPU, който поддържа ключове-стойности с произволен размер, добре работи при високи коефициенти на употреба и показва стабилна производителност след многократни изтегляния.
Времето за работа на хеш таблицата за GPU и междупрограмното взаимодействие беше 984 мс. Това включва времето, необходимо за разполагане на таблицата в паметта и нейното изтриване (еднократно заделяне на 1 ГБ памет, което в CUDA отнема време), вмъкване и изтриване на елементи, както и тяхното итериране. Включени са също всички копия в паметта и извън паметта на видеокартата.
Работата на самата хеш таблица отне 271 мс. Това включва времето, което видеокартата е похарчила за вмъкване и изтриване на елементи, и не включва времето за копиране в паметта и итериране по получената таблица. Ако GPU таблицата живее дълго, или ако хеш таблицата е напълно в паметта на видеокартата (например за създаване на хеш таблица, която ще се използва от друг код на GPU, а не от централния процесор), тестовият резултат е уместен.
Хеш таблицата за видеокартата демонстрира висока производителност благодарение на голяма пропусквателна способност и активно разпаралеляване.
Недостатъци
Архитектурата на хеш таблицата има няколко проблема, които трябва да се имат предвид:
- Линейното зондирование е нарушено от клъстериране, в резултат на което ключовете в таблицата не се разполагат особено добре.
- Ключовете не се изтриват с функцията
deleteи с времето запълват таблицата.
В резултат на това производителността на хеш таблицата може постепенно да намалява, особено ако съществува дълго време и в нея се извършват многобройни вмъквания и изтривания. Един от начините за смекчаване на тези недостатъци е повторното хеширане в нова таблица с достатъчно нисък коефициент на запълване и филтриране на изтритите ключове при повторно хеширане.
За да илюстрирам описаните проблеми, използвам горепосочения код за създаване на таблица с 128 млн. елемента, циклично ще вмъквам 4 млн. елемента, докато не запълня 124 млн. слота (коефициент на запълване около 0,96). Ето таблица с резултати, всеки ред е извикване на CUDA ядро с вмъкване на 4 млн. нови елемента в една хеш таблица:
Коефициент на запълване
Продължителност на вмъкването на 4 194 304 елемента
0,00
11,608448 ms (361,314798 млн ключа/сек.)
0,03
11,751424 ms (356,918799 млн ключа/сек.)
0,06
11,942592 ms (351,205515 млн ключа/сек.)
0,09
12,081120 ms (347,178429 млн ключа/сек.)
0,12
12,242560 ms (342,600233 млн ключа/сек.)
0,16
12,396448 ms (338,347235 млн ключа/сек.)
0,19
12,533024 ms (334,660176 млн ключа/сек.)
0,22
12,703328 ms (330,173626 млн ключа/сек.)
0,25
12,884512 ms (325,530693 млн ключа/сек.)
0,28
13,033472 ms (321,810182 млн ключа/сек.)
0,31
13,239296 ms (316,807174 млн ключа/сек.)
0,34
13,392448 ms (313,184256 млн ключа/сек.)
0,37
13,624000 ms (307,861434 млн ключа/сек.)
0,41
13,875520 ms (302,280855 млн ключа/сек.)
0,44
14,126528 ms (296,909756 млн ключа/сек.)
0,47
14,399328 ms (291,284699 млн ключа/сек.)
0,50
14,690304 ms (285,515123 млн ключа/сек.)
0,53
15,039136 ms (278,892623 млн ключа/сек.)
0,56
15,478656 ms (270,973402 млн ключа/сек.)
0,59
15,985664 ms (262,379092 млн ключа/сек.)
0,62
16,668673 ms (251,627968 млн ключа/сек.)
0,66
17,587200 ms (238,486174 млн ключа/сек.)
0,69
18,690048 ms (224,413765 млн ключа/сек.)
0,72
20,278816 ms (206,831789 млн ключа/сек.)
0,75
22,545408 ms (186,038058 млн ключа/сек.)
0,78
26,053312 ms (160,989275 млн ключа/сек.)
0,81
31,895008 ms (131,503463 млн ключа/сек.)
0,84
42,103294 ms (99,619378 млн ключа/сек.)
0,87
61,849056 ms (67,815164 млн ключа/сек.)
0,90
105,695999 ms (39,682713 млн ключа/сек.)
0,94
240,204636 ms (17,461378 млн ключа/сек.)
С увеличаване на коефициента на използване производителността намалява. Това е нежелателно в повечето случаи. Ако приложението вмъква елементи в таблицата и след това ги отхвърля (например при преброяване на думите в книга), това не е проблем. Но ако приложението използва дълготрайна хеш-таблица (например в графичен редактор за съхранение на непразни части от изображения, когато потребителят често вмъква и изтрива информация), то такова поведение може да бъде неприятно.
И измерих дълбочината на зондирование на хеш-таблицата след 64 млн вмъквания (коефицент на използване 0,5). Средната дълбочина беше 0,4774, така че повечето ключове бяха разположени или в най-добрите възможни слотове, или в един слот от най-добрата позиция. Максималната дълбочина на зондированието беше 60.
След това измерих дълбочината на зондированието в таблицата с 124 млн вмъквания (коефицент на използване 0,97). Средната дълбочина вече беше 10,1757, а максималната — 6474 (!!). Производителността при линейно зондированието рязко спада при високи коефициенти на използване.
Най-добре е да се поддържа ниско натоварване на тази хеш-таблица. Но тогава повишаваме производителността за сметка на потреблението на памет. За щастие, в случай на 32-битови ключове и стойности, това може да бъде оправдано. Ако в горния пример хеш-таблицата с 128 милиона елемента поддържа натоварване 0,25, можем да поберем не повече от 32 милиона елемента, а останалите 96 милиона слота ще бъдат загубени — по 8 байта за всеки на двойка, общо 768 Мб загубена памет.
Обърнете внимание, че става въпрос за загуба на памет на видеокарта, която е по-ценен ресурс от системната памет. Въпреки че повечето съвременни настолни видеокарти, поддържащи CUDA, имат не по-малко от 4 Гб памет (по време на написването на статията NVIDIA 2080 Ti има 11 Гб), въпреки това загубата на толкова много памет не би била най-мъдрото решение.
По-късно ще напиша повече относно създаването на хеш-таблици за видеокарти, които нямат проблеми с дълбочината на зондирования, както и за методи за повторно използване на изтрити слотове.
Измерване на дълбочината на зондирования
За да определим дълбочината на зондирования на ключа, можем да извлечем хеша на ключа (неговия идеален индекс в таблицата) от действителния табличен индекс:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Заради магията на двете двоични числа в допълнителния код и факта, че капацитетът на хеш-таблицата е равен на двоично число на степен, този подход ще работи дори когато индексът на ключа се прехвърли в началото на таблицата. Нека вземем ключ, който се хешира в 1, но е поставен в слот 3. Тогава за таблица с капацитет 4 ще получим (3 — 1) & 3, което е равно на 2.
Заключение
Ако имате въпроси или коментари, напишете ми на или отворете нова тема в.
Този код е написан вдъхновен от прекрасни статии:
В бъдеще ще продължа да пиша за реализации на хеш-таблици за видеокарти и ще анализирам тяхната производителност. В плановете ми е свързването в верига, хеширане на Робин Худ и хеширане с кукувица с използване на атомарни операции в структури от данни, удобни за видеокарти.
Източник: habr.com
