

– О, никак не може да се предпази от удара на метеорит. Но вие имате, както всеки, резерв, така че можете да не се тревожите.
Станислав Лем, «Звездни дневници на Ион Тихи»
Резервното копиране се нарича запазване на копия на данни на място извън основното хранилище.
Основната цел на резервното копиране е възстановяване на данни след загуба. Поради това често може да се чуе, че при наличие на реплика на базата данни винаги може да се възстановят данни и резервното копиране не е необходимо. Всъщност резервното копиране решава поне три задачи, които не могат да бъдат решени само с помощта на реплика, а и реплика не може да бъде инициализирана без резервно копие.
На първо място, резервното копие позволява възстановяване на данни след логическа грешка. Например, счетоводителят е изтрил група проводки или администраторът на БД е унищожил пространство от таблици. И двата процеса са напълно легитимни от гледна точка на базата данни, а процесът на репликация ще ги възпроизведе в реплика на базата.
На второ място, съвременните СУБД са много надеждни софтуерни комплекси, но понякога все пак се случва повреждане на вътрешните структури на базата данни, след което достъпът до данните се губи. Особено неприятно е, че такова нарушение обикновено настъпва при високи натоварвания или при инсталиране на актуализации. Но както високото натоварване, така и регулярните актуализации показват, че базата данни не е тестова, и данните, съхранявани в нея, са ценни.
Накрая, третата задача, за решаването на която е необходимо наличието на резервно копие, е клонирането на базата, например, за тестови цели.
Резервното копиране на бази данни така или иначе се основава на един от двата принципа:
- Извличане на данни със запазване в произволен формат;
- Снимка на състоянието на файловете на БД и запазване на журналите.
Нека разгледаме тези принципи и инструментите, които ги реализират, по-подробно.
Извличане на данни
В комплекта от инструменти, предоставени с всяка СУБД, задължително има инструменти за извличане и зареждане на данни. Данните се запазват или в текстов формат, или в двоичен формат, специфичен за конкретна СУБД. В таблицата по-долу е предоставен списък на такива инструменти:
Двоичен формат
Текстов формат
Oracle
DataPump Export/DataPump Import
Експорт/Импорт
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
разтоварване/зареждане
разтоварване/зареждане
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Текстовият формат е добър, тъй като може да се редактира или дори да се създава с външни програми, а двоичният формат от своя страна е добър, защото позволява по-бързо износене и зареждане на данни благодарение на спестяване на ресурси за преобразуване на формати.
Въпреки простотата и очевидността на идеята за изнасяне на данни, този метод рядко се използва за резервиране на натоварени промишлени бази данни. Ето причините, поради които изнасянето не е подходящо за пълно резервно копиране:
- процесът на изнасяне генерира значителна натовареност на системата-източник;
- изнасянето отнема много време – в момента на завършване на изнасянето, данните вече ще са неактуални;
- постигането на консистентно изнасяне на цялата база данни при висока натовареност практически е невъзможно, тъй като СУБД е принудена да съхранява снимка на своето състояние в момента, в който е започнало изнасянето. Колкото повече транзакции са извършени от момента на започване на изнасянето, толкова по-голям е обемът на снимката (неактуални копия на данни в PostgreSQL, пространство undo в Oracle, tempdb в Microsoft SQL Server и т.н.);
- изнасянето запазва логичната структура на данните, но не запазва физическата им структура – параметрите на физическото съхранение на таблиците, индексите и др.
Въпреки това, изнасянето има и предимства:
- висока избирателност: може да се изнасят отделни таблици, отделни полета и дори отделни редове;
- изнесените данни могат да бъдат заредени в база данни с друга версия, а ако изнасянето е направено в текстов формат, дори в друга база данни.
Така изнасянето се използва основно за задачи като резервиране на малки таблици (например справочници) или разпространение на набори от данни с новия релиз на приложението.
Най-разпространеният метод за резервно копиране на бази данни обаче е копирането на файловете на базата.
„Студено“ съхраняване на файлове на БД
Очевидната идея е да се спре базата данни и да се копират всички нейни файлове. Това резервно копие се нарича „студено“. Методът е изключително надежден и прост, но има два очевидни недостатъка:
- от "студенческа" резервна копия може да бъде възстановено само състоянието на базата данни, което е било в момента на спирането; транзакции, направени след рестартиране на базата, няма да попаднат в "студената" резервна копия;
- далеч не всяка база данни разполага с технологичен прозорец, в който базата може да бъде спряна.
Ако обаче "студеното" резервно копие ви устройва, трябва да помните, че
- "студената" копия понякога трябва да включва и регистрите. Методите за определяне на регистрите, които трябва да попаднат в "студената" копия, са индивидуални за всяка СУБД. Например, в Oracle е необходимо да се копират така наречените online redo, тоест фиксирано количество журнали в специален каталог, дори и тогава, когато базата е спряна правилно. В PostgreSQL трябва да запазите всички регистри, започвайки от регистра, съдържащ последната контрольна точка, информация за която се съдържа в управляващия файл.
- каталогът на базата данни може да съдържа доста големи файлове на временни таблици, които не е необходимо да се включват в резервното копие. Между другото, това наблюдение е валидно и за "горещото" резервно копие.
"Горещото" запазване на файлове
Повечето резервни копия на съвременни бази данни се извършват чрез копиране на файловете на базата данни без спиране на базата. Тук се виждат няколко проблема:
- В момента на започване на копирането съдържанието на базата данни може да не съвпада със съдържанието на файловете, тъй като част от информацията е в кеша и все още не е записана на диска.
- По време на копирането съдържанието на базата може да се променя. Ако се използват изменяеми структури от данни, съдържанието на файловете се променя, а при използване на неизменяеми структури наборът от файлове: нови файлове се появяват, а стари се изтриват.
- Тъй като записването на данни в базата и четенето на файловете на БД не са никак синхронизирани, програмата за резервно копиране може да прочете некоректна страница, в която половината ще бъде от старата версия на страницата, а другата половина – от новата.
За да се получи консистентно резервно копие, за всяка СУБД съществува команда, която съобщава, че е започнал процесът на резервно копиране. Синтактически тази команда може да изглежда по различен начин:
- в Oracle това е отделна команда ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- в PostgreSQL – функция pg_start_backup();
- В Microsoft SQL Server и DB2, подготовката за резервно копие се извършва неявно по време на изпълнението на командата BACKUP DATABASE;
- в MySQL Enterprise, Cassandra и MongoDB, подготовката се извършва неявно от външна утилита – mysqlbackup, OpsCenter и Ops Manager съответно.
Въпреки синтактичните различия, процесът на подготовка за резервно копие изглежда еднакво.
Ето как изглежда подготовката за резервно копие в СУБД с променливи дискови структури, т.е. във всички традиционни дискови релационни системи:
- Запомня се моментът на започване на резервното копие; резервното копие трябва да съдържа журналите на базата данни, започвайки от този момент.
- Извършва се контролна точка, т.е. всички промени, които са настъпили в страниците с данни преди запомнения момент, се записват на диск. Това гарантира, че журналите преди момента на започване на резервното копие няма да бъдат необходими при възстановяване.
- Включва се специален режим на журнализиране: ако страницата с данни е променена за първи път след зареждането от диска, вместо да се запише в журнала промяната на страницата, базата ще запише цялата страница. При извършване на подготовителната процедура всички страници се изхвърлят на диск, така че при първата промяна блокът винаги ще бъде записан в журнала целиком. Но ако в процеса на резервното копие страницата отново бъде изхвърлена на диск, следващата й промяна също ще доведе до появата в журнала на пълна копия на страницата. Това гарантира, че ако при копирането на файла с данни страницата стане некоректна, приложението на журнала ще я възстанови.
- Блокира се промяната на заглавките на файловете с данни, т.е. на тази част, промяната на която не се отразява в журналите. Това гарантира, че заглавката ще бъде копирана коректно, а след това журналите ще се приложат коректно към файла с данни.
След като всички горепосочени процедури са изпълнени, можете да копирате файловете с данни чрез средства на операционната система – cp, rsync и други. Активирането на режим на резервно копиране намалява производителността на базата данни: първо, увеличава обема на логовете, а второ, ако по време на резервното копиране възникне сбой, възстановяването ще отнеме повече време, тъй като заглавията на файловете с данни не се актуализират. Колкото по-бързо приключи резервното копиране, толкова по-добре за базата данни, затова тук е удачно използването на средства като моментна снимка (snapshot) на файловата система или разкъсване на огледалото (BCV) в дисковия масив. Някои СУБД (Oracle, PostgreSQL) дават възможност на администратора самостоятелно да избира начина на копиране, докато други (Microsoft SQL Server) предоставят интерфейс за интеграция на собствени инструменти за резервно копиране с механизмите на файловите системи или СХД.
След завършване на резервното копиране базата данни трябва да бъде върната обратно в нормално състояние. В Oracle това става с командата ALTER DATABASE/TABLESPACE END BACKUP, в PostgreSQL – чрез извикването на функцията pg_stop_backup(), а в други бази – с вътрешни подпрограми на съответните команди или външни услуги.
Ето как изглежда времева диаграма на процеса на резервно копиране:
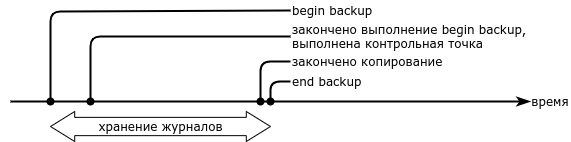
- Подготовката за резервно копиране (begin backup) отнема време, понякога значително. Дори когато се използват огледални томове или файлови системи с възможност за създаване на моментни снимки, процесът на резервно копиране няма да бъде мигновен.
- Заедно с файловете с данни е необходимо да се запазят логовете от момента на стартиране на подготовката за резервно копиране до момента на връщане на базата в нормално състояние.
- Можете да се възстановите от тази резервна копия в момента на връщането на базата в нормално състояние. Възстановяване в по-ранен момент не е възможно.
С бази данни, използващи неизменяеми структури от данни (моментни снимки в паметта, LSM-деревья) ситуацията е по-проста. Подготовката за резервно копиране се състои от следните стъпки:
- Данните от паметта се записват на диск.
- Фиксира се списък на файловете, включени в резервната копия. Докато процесът на резервно копиране не приключи, на базата данни е забранено да изтрива тези файлове, дори ако вече не са необходими.
При сигнал за приключване на архивирането базата с неизменяеми структури отново може да изтрива ненужни файлове.
Възстановяване до точка
Архивирането позволява да възстановите състоянието на базата данни в момента, в който завърши командата за връщане от режим на архивиране. Въпреки това, авария, при която може да се наложи възстановяване, може да се случи по всяко време. Задачата за възстановяване на състоянието на БД в произволен момент се нарича 'възстановяване до точка' (point-in-time recovery).
За да се осигури тази възможност, трябва да се запазват журналите на БД, започвайки от момента на приключване на архивирането, а при възстановяване да продължите да прилагате журналите към възстановената копия. След като БД бъде възстановена от архива в момента на приключването на архивирането, състоянието на базата (файлове и кеширани страници) е гарантирано коректно, така че специален режим на журнализиране не е нужен. Прилагайки журналите до необходимия момент, можете да получите състояние на базата данни в произволна точка във времето.
Ако скоростта на възстановяване на архива е ограничена само от пропускателната способност на диска, скоростта на прилагане на журнала обикновено е ограничена от производителността на процесора. Ако в основната база данни измененията се случват паралелно, то при възстановяване всички изменения се изпълняват последователно – в реда на четене от журнала. По този начин времето за възстановяване линейно зависи от това колко далеч точката на възстановяване е от точката на приключване на архивирането. Поради това се налага доста често да се правят пълни архиви – минимум веднъж седмично за бази с малко транзакционно натоварване и до ежедневно архивиране на силно натоварени бази.
Инкрементално архивиране
За да се ускори възстановяването до точка, би било добре да имате възможност да извършвате архивиране възможно най-често, но в същото време да не заемат излишно пространство на дисковете и да не натоварват базата с задачи по архивиране.
Решението на задачата е инкрементално архивиране, т.е. архивиране само на онези страници данни, които са се променили от момента на предишното архивиране.
Инкременталното резервно копие има смисъл само за СУБД, използващи изменяеми структури на данни.
Инкрементът може да бъде отчитан както от пълно резервно копие (кумулативна копия), така и от всяко предишно копие (диференциална копия).
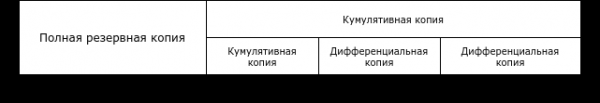
За съжаление, не съществува единна терминология и различните производители използват различни термини:
Диференциална
Кумулативна
Oracle
Differential
Cumulative
PostgresPro
Incremental
—
Microsoft SQL Server
—
Differential
IBM DB2
Delta
Incremental
При наличие на инкрементални копия, процесът на възстановяване на точка изглежда по следния начин:
- възстановява се последното пълно резервно копие, направено преди момента на възстановяване;
- отгоре на пълното копие се възстановяват инкременталните копия;
- накати се журналът от точката на начало на резервно копие до точката на възстановяване.
Наличието на кумулативна копия ускорява процеса на възстановяване. Например, за възстановяване на състоянието на базата на точка между T3 и T4 е необходимо да се възстановят две инкрементални копия, а за възстановяване на точка след T4 – само една.
Ясно е, че обемът на една кумулативна копия е по-малък от обема на няколко диференциални копия, защото някои страници са били променени няколко пъти, а всяка инкрементална копия съдържа своя версия на страницата.
Има три начина за създаване на инкрементално копие:
- създаване на пълно копие и изчисляване на разликата с предишната пълна копия;
- анализ на журналите, създаване на списък с променени страници и резервиране на страниците, включени в списъка;
- заявка за променени страници в базата данни.
Първият начин спестява дисково пространство, но не решава проблема с намаляване на натоварването на базата данни. Освен това, ако имаме пълно резервно копие, не е смислено да го преобразуваме в инкрементално, тъй като възстановяването на пълно копие е по-бързо от възстановяването на предишно пълно копие и инкремент. Проблемът с икономията на дисково пространство при такъв подход по-добре да бъде прехвърлен на специализирани компоненти с вградени механизми за дедупликация. Те могат да бъдат както специализирани СХД (EMC DataDomain, HPE StorageWorks VLS, цялата линия NetApp), така и софтуерни продукти (ZFS, Veritas NetBackup PureFile, Windows Server Data Deduplication).
Вторият и третият метод се различават според механизма за определяне на списъка на променените страници. Анализът на журналите е по-ресурсоемък и изисква познаване на структурата на файловете на журналите. Най-лесно е да се запита самата база какви точно страници са се променили, но за това ядрото на СУБД трябва да притежава функционалност за проследяване на променените блокове (block change tracking).
Функционалността за инкрементално архивиране за първи път е създадена в софтуера Oracle Recovery Manager (RMAN), който се появи с версия Oracle 8i. Oracle веднага реализира проследяване на променените блокове, затова няма нужда от анализ на журналите.
PostgreSQL не проследява променените блокове, затова утилитата pg_probackup, разработена от руската компания Postgres Professional, определя променените страници чрез анализ на журнала. Въпреки това компанията предлага и СУБД PostgresPro, която включва разширение ptrack, проследяващо промените на страниците. Когато се използва pg_probackup със СУБД PostgresPro, утилитата запитва променените страници от самата база – точно както RMAN.
Microsoft SQL Server, подобно на Oracle, проследява променените страници, но командата BACKUP позволява само извършването на пълни и кумулативни архивни копия.
В DB2 съществува възможност за проследяване на променените страници, но по подразбиране тя е деактивирана. След активиране, DB2 позволява извършването на пълни, диференциални и кумулативни архивни копия.
Важно отличие на описаните в тази секция средства (с изключение на pg_probackup) от файловите средства за архивиране е, че те запитват изображение на страниците от базата данни, а не четат данните от диска сами. Недостатък на този подход е лекото допълнително натоварване на базата. Въпреки това, той е компенсиран с това, че прочетената страница винаги е коректна, поради което няма нужда от активиране на специален режим на журнализиране по време на архивирането.
Още веднъж обърнете внимание, че наличието на инкрементални копия не отменя изискванията за наличието на журнал за възстановяване на произволна точка във времето. Затова в промишлените бази данни журналите постоянно се преписват на външно устройство, а архивните копия, пълни и/или инкрементални, се създават по график.
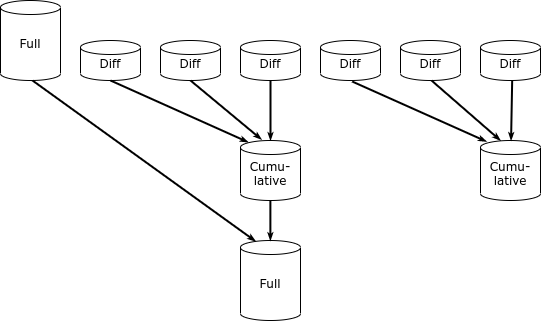
Най-доброто приложение на идеята за инкрементно архивиране днес е софтуерно-апаратният комплекс (в терминологията на Oracle – engineered system) Zero Data Loss Recovery Appliance – специализирано решение на Oracle за резервно копиране на собствената база данни. Комплексът представлява клъстер сървъри с голям обем дискове, на които е инсталирана модифицирана версия на софтуера Recovery Manager и може да работи както с други софтуерно-апаратни комплекси на Oracle (Database Appliance, Exadata, SPARC Supercluster), така и с бази данни на Oracle в традиционна инфраструктура. В отличие от „обикновения“ RMAN, в ZDLRA е реализирана концепцията за „вечен инкремент“ (incremental forever). Системата единствено веднъж създава пълна копия на базата данни, а след това прави само инкрементални копия. Допълнителните модули на RMAN позволяват обединяване на копия, създавайки нови пълни копия от инкременталните.
За чест на руските разработчици трябва да се отбележи, че и pg_probackup умее да обединява инкрементални копия.
В отличие от много подобни въпроси, въпросът „кой метод за архивиране е най-добър“ има еднозначен отговор – най-добре е родната за използваната СУБД утилита, която осигурява възможност за инкрементално архивиране.
За администратора на бази данни много по-важни са въпросите за избор на стратегия за архивиране и интеграция на средствата за архивиране на бази данни в корпоративната инфраструктура. Но тези въпроси излизат извън рамките на тази статия.
Източник: habr.com
