

Много хора смятат, че е достатъчно да пренесат приложението в Kubernetes (или с помощта на Helm, или ръчно) — и всичко ще бъде наред. Но не е толкова просто.
Екип преведе статия на DevOps инженера Джулиан Гинди. Той разказва за подводните камъни, с които е сблъскала компанията му по време на миграцията, за да не стъпвате на същите грешки.
Стъпка първа: настройка на запитванията на пода и лимитите
Нека започнем с настройката на чиста среда, в която ще работят нашите подове. Kubernetes прекрасно управлява планирането на подовете и обработката на откази. Но се оказа, че понякога планиращият не може да разположи под, ако има затруднения да оцени колко ресурси му трябват за успешна работа. Тук влизат запитванията за ресурси и лимитите. Провеждат се много спорове за най-добрия подход за настройка на запитванията и лимитите. Понякога изглежда, че това наистина е по-скоро изкуство, отколкото наука. Ето какъв е нашият подход.
Запитвания на пода (pod requests) — това е основното значение, използвано от планиращия за оптимално разполагане на пода.
От : на етапа на филтриране се определя набор от възли, където може да се планира под. Например, филтърът PodFitsResources проверява дали на възела има достатъчно ресурси за удовлетворяване на конкретните запитвания на пода за ресурси.
Запитванията на приложенията използваме така, че с тях да можем да оценим колко ресурси в действителност нуждае приложението, за да функционира нормално. Така планиращият ще може реалистично да разположи възлите. Първоначално искахме да зададем запитвания с резерв, за да гарантираме достатъчно количество ресурси за всеки под, но забелязахме, че времето за планиране значително се е увеличило, а някои подове дори не бяха напълно планирани, сякаш не получаваха никакви запитвания за ресурси.
В този случай планиращият често "изтласкваше" подовете и не можеше да ги планира отново, тъй като управляващата платформа нямаше представа колко ресурси ще е необходимо на приложението, а това е ключов компонент на алгоритъма за планиране.
Лимити на пода (pod limits) — това е по-ясно ограничение за пода. То представлява максималното количество ресурси, което клъстерът ще отпусне на контейнера.
Отново, от : ако за контейнера е зададен лимит на памет от 4 ГиБ, kubelet (и средата за изпълнение на контейнера) ще го принуди. Средата за изпълнение не позволява на контейнера да използва повече от зададения лимит на ресурсите. Например, когато процес в контейнера се опита да използва повече от допустимия обем памет, ядрото на системата завършва този процес с грешка „изчерпване на паметта“ (OOM).
Контейнерът винаги може да използва повече ресурси, отколкото са посочени в заявката за ресурси, но никога не може да използва повече, отколкото е посочено в ограниченията. Тази стойност е трудна за установяване, но е много важна.
В идеалния случай искаме изискванията за ресурси на пода да се променят през жизнения цикъл на процеса, без да намесват другите процеси в системата — това е целта на задаването на лимити.
За съжаление, не мога да дам конкретни указания какви стойности да зададете, но ние самите спазваме следните правила:
- Използвайки инструмента за натоварване, моделираме основното ниво на трафик и наблюдаваме използването на ресурси на пода (памет и процесор).
- Задаваме заявките на пода на произволно ниска стойност (с ограничение на ресурсите, което е около 5 пъти повече от стойността на заявките) и наблюдаваме. Когато заявките са на твърде ниско ниво, процесът не може да стартира, което често води до загадъчни грешки при изпълнение на Go.
Искам да подчертая, че по-високите ограничения на ресурсите усложняват планирането, тъй като на пода е необходим целеви възел с достатъчно налични ресурси.
Представете си ситуация, когато имате лек веб-сървър с много високи ограничения на ресурсите, например 4 ГБ памет. Вероятно този процес ще трябва да бъде мащабиран хоризонтално и всеки нов модул ще трябва да бъде планиран на узел с наличен обем памет не по-малко от 4 ГБ. Ако такъв узел не съществува, кластерът трябва да добави нов узел, за да обработи този под, което може да отнеме известно време. Важно е да постигнете минимална разлика между заявките за ресурси и лимитите, за да осигурите бързо и плавно мащабиране.
Стъпка втора: настройка на тестовете Liveness и Readiness
Това е още една тънка тема, която често се обсъжда в общността на Kubernetes. Важно е да разбирате добре тестовете за жизнеспособност (Liveness) и готовност (Readiness), тъй като те предоставят механизъм за устойчивата работа на софтуера и минимизират времето на простои. Въпреки това, ако не са настроени правилно, те могат да нанесат сериозен удар по ефективността на вашето приложение. По-долу е кратко изложение на това какво представляват и двете проби.
Liveness показва дали контейнерът работи. Ако той се провали, kubelet убива контейнера и за него се активира политиката за рестартиране. Ако контейнерът не е оборудван с Liveness проба, състоянието по подразбиране ще бъде успех — така е посочено в .
Пробите Liveness трябва да бъдат евтини, т.е. да не консумирват много ресурси, тъй като те се изпълняват често и трябва да информират Kubernetes, че приложението е стартирано.
Ако зададете параметър за изпълнение на всяка секунда, това ще добави 1 заявка на секунда, така че имайте предвид, че за обработката на този трафик ще са необходими допълнителни ресурси.
В нашата компания тестовете Liveness проверяват основните компоненти на приложението, дори когато данните (например от дистанционна база данни или кеш) не са напълно налични.
Настроихме в приложенията крайна точка за "работоспособност", която просто връща код на отговор 200. Това е индикация, че процесът е стартиран и способен да обработва заявки (но все още не и трафик).
Проба Readiness показва дали контейнерът е готов да обслужва заявки. Ако пробата за готовност се провали, контролерът на крайните точки премахва IP адреса на пода от крайните точки на всички услуги, свързани с него. Това също е посочено в документацията на Kubernetes.
Пробите Readiness консумират повече ресурси, тъй като те трябва да достигат до бекенда по такъв начин, че да покажат готовността на приложението да приема заявки.
В общността се водят много спорове относно това дали да се правят директни запитвания към базата данни. Взимайки предвид разходите (проверките се правят често, но могат да се регулират), решихме, че за някои приложения готовността да обслужва трафика се счита за валидна само след проверка дали базата данни връща записи. Добре проектираните тестове за готовност осигуряват по-висока наличност и премахват престои по време на разгръщането.
Ако решите да направите запитване към базата данни за проверка на готовността на приложението, уверете се, че то е възможно най-евтино. Нека вземем за пример следното запитване:
SELECT small_item FROM table LIMIT 1Ето как настройваме тези две стойности в Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Можете да добавите някои допълнителни конфигурационни параметри:
initialDelaySeconds— колко секунди ще изминат от стартирането на контейнера до началото на теста.periodSeconds— интервалът на изчакване между тестовете.timeoutSeconds— броят секунди, след които подът се счита за аварийен. Обычен таймаут.failureThreshold— брой неуспешни теста, преди да бъде изпратен сигнал за рестартиране на пода.successThreshold— брой успешни теста, преди подът да премине в състояние на готовност (след срив, когато подът се стартира или възстановява).
Стъпка три: настройка на подразбиращите се мрежови политики на пода
В Kubernetes мрежовата топология е "плоска" и по подразбиране всички подове взаимодействат помежду си директно. В някои случаи това не е желателно.
Потенциален проблем с безопасността е, че нападател може да използва уязвимо приложение, за да пренасочва трафик към всички подове в мрежата. Както в много области на сигурността, тук важи принципът на най-ниските привилегии. Идеалното е мрежовите политики да указват ясно кои връзки между подовете са разрешени, а кои не.
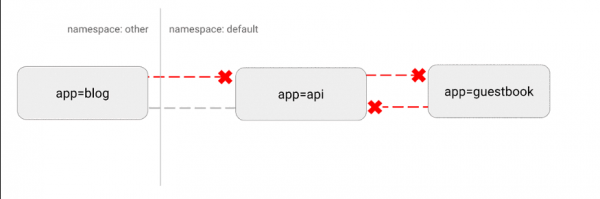
Например, по-долу е проста политика, която забранява целия входящ трафик за конкретното пространство от имена:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Визуализация на тази конфигурация:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Повече подробности .
Стъпка четири: нестандартно поведение с помощта на хукове и init-контейнери
Една от основните ни задачи беше осигуряването на разгръщания в Kubernetes без прекъсване за разработчиците. Това е трудно заради множеството опции за завършване на работата на приложенията и освобождаването на заеманите от тях ресурси.
Особени трудности възникнаха с . Забелязахме, че при последователно разгръщане на тези подове активните връзки прекъсваха до успешното им завършване.
След обширни изследвания в интернет стана ясно, че Kubernetes не чака, докато връзките на Nginx се изчерпат, преди да приключи работата на пода. С помощта на pre-stop хук внедрихме тази функционалност и напълно се избавихме от времето на неработоспособност:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
А ето nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
Още една изключително полезна парадигма е използването на init-контейнери за обработка на стартиране на конкретни приложения. Това е особено полезно в случай, че имате ресурсоемък процес за миграция на база данни, който трябва да бъде стартиран преди стартирането на приложението. За този процес можете да зададете по-висок лимит на ресурсите, без да определяте такъв лимит за основното приложение.
Други разпространена схема е достъпът до тайни в init-контейнера, който предоставя тези удостоверения на основния модул, което предотвратява неоторизиран достъп до тайните от самия основен модул на приложението.
Както обикновено, цитирайки документацията: init-контейнерите безопасно стартират потребителски код или утилити, които в противен случай биха намалили сигурността на образа на контейнера на приложението. Чрез съхранение на ненужните инструменти отделно, ограничавате повърхността на атака на образа на контейнера на приложението.
Стъпка пет: настройка на ядрото
Накрая ще споделим по-напреднали техники.
Kubernetes е изключително гъвкава платформа, която позволява стартиране на работни натоварвания по начин, който смятате за необходим. Имаме редица високо ефективни приложения, изискващи значителни ресурси. След обширно натоварващо тестване, установихме, че едно от приложенията трудно се справя с очакваното натоварване на трафика, ако действат настройките на Kubernetes по подразбиране.
Въпреки това Kubernetes позволява стартирането на привилегирован контейнер, който променя параметрите на ядрото само за конкретна под. Ето какво използвахме, за да променим максималния брой отворени съединения:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Това е по-напреднала техника, която често не е нужна. Но ако вашето приложение едва се справя с голямо натоварване, можете да опитате да настроите някои от тези параметри. По-подробна информация за този процес и настройването на различни стойности – както винаги .
В заключение
Въпреки че Kubernetes може да изглежда като готово решение "от кутията", за безпроблемната работа на приложенията е необходимо да се предприемат няколко ключови стъпки.
През цялата миграция на Kubernetes е важно да следвате "цикъла на натоварващото тестване": стартирате приложението, тествате го при натоварване, наблюдавате метриките и поведението при мащабиране, настройвате конфигурацията на базата на тези данни и след това отново повтаряте този цикъл.
Реалистично оценете очаквания трафик и опитайте да надхвърлите тези стойности, за да видите кои компоненти ще се провалят първи. С такъв итеративен подход за постигане на успех могат да бъдат достатъчни само няколко от изброените препоръки. Или може да е необходима по-дълбока настройка.
Винаги си задавайте такива въпроси:
- Колко ресурси консумират приложенията и как ще се промени този обем?
- Какви са реалните изисквания за мащабиране? Колко трафик в средно приложение ще обрабатыва приложението? А какво ще кажете за пиковия трафик?
- Колко често на услугата ще ѝ е необходимо хоризонтално мащабиране? Колко бързо е нужно да внедрявате нови подове, за да приемате трафик?
- Насколько коректно завършва работата на подовете? Нужно ли е това изобщо? Може ли да се постигне разгръщане без престой?
- Как да минимизираме рисковете за безопасност и да ограничим щетите от всякакви компрометирани подове? Има ли услуги с разрешения или достъпи, които не им трябват?
Kubernetes предоставя невероятна платформа, която позволява да се използват най-добрите практики за разгръщане на хиляди услуги в клъстера. Въпреки това, всички приложения са различни. Понякога внедряването изисква малко повече усилия.
За щастие, Kubernetes предоставя необходимите настройки за постигане на всички технически цели. Използвайки комбинация от искания за ресурси и лимити, проби Liveness и Readiness, init-контейнери, мрежови политики и нестандартна настройка на ядрото, можете да постигнете висока производителност, наред с отказоустойчивост и бърза скалируемост.
Какво друго да прочетете:
- .
- .
- .
Източник: habr.com
