

В разгледахме кластеризацията на RabbitMQ за осигуряване на отказоустойчивост и висока наличност. Сега ще навлезем по-дълбоко в Apache Kafka.
Тук единицата за репликация е партиция (partition). Всеки топик има една или няколко партиции. Всяка партиция има лидер с фолловери или без тях. При създаване на топик се задава броят на партициите и коефициентът на репликация. Обичайната стойност е 3, което означава три реплики: един лидер и два фолловера.
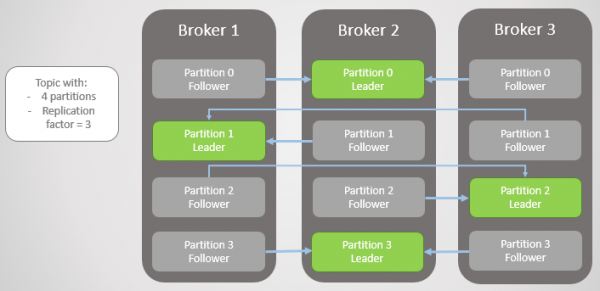
Рис. 1. Четири партиции са разпределени между три брокера
Всички заявки за четене и запис отиват при лидера. Фолловерите периодично изпращат на лидера заявки за получаване на последните съобщения. Потребителите никога не се обръщат към фолловерите, те съществуват само за излишност и отказоустойчивост.
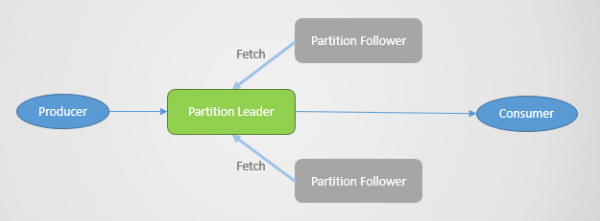
Срив на партицията
Когато брокер излиза от мрежата, често се повредят лидерите на няколко партиции. Във всяка от тях лидерът става фолловер от другия възел. Всъщност не винаги е така, тъй като влияние оказва и факторът на синхронизация: имат ли синхронизирани фолловери и, ако не, разрешен ли е преходът към несинхронизирана реплика. Но за сега няма да усложняваме.
Изхвърля се брокер 3 — и за партиция 2 се избира нов лидер на брокер 2.
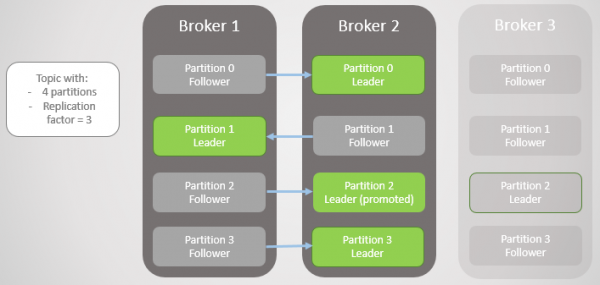
Рис. 2. Брокер 3 умира, и неговият фолловер на брокер 2 става нов лидер на партиция 2
След това излиза брокер 1 и партиция 1 също остава без лидер, роля, която преминава към брокер 2.
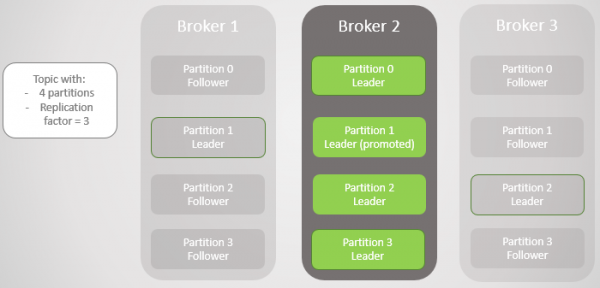
Рис. 3. Остава само един брокер. Всички лидери са на един брокер с нулева излишност
Когато брокер 1 се връща в мрежата, той добавя четирима фолловери, осигурявайки известна излишност на всяка партиция. Но всички лидери все още остават на брокер 2.
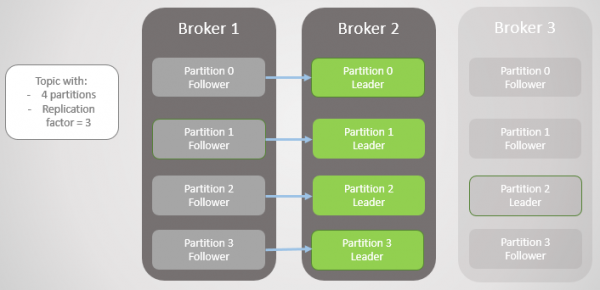
Рис. 4. Лидерите остават на брокер 2
Когато брокер 3 се възстанови, ние се връщаме към три реплики на партицията. Но всички лидери все още са на брокер 2.
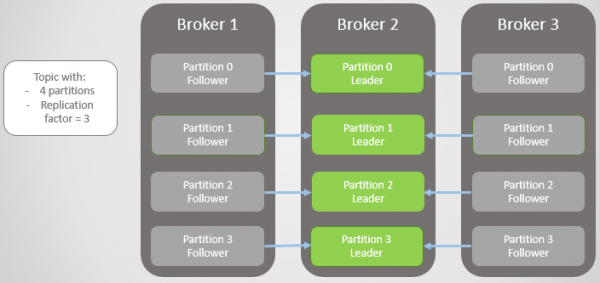
Рис. 5. Несбалансирано разпределение на лидерите след възстановяването на брокери 1 и 3
Kafka предлага по-добър инструмент за по-ефективно преразпределение на лидери в сравнение с RabbitMQ. Там беше необходимо да се използва външен плъгин или скрипт, който променяше политиките за миграция на главния възел, за сметка на намаляване на излишъка по време на миграцията. Освен това, за големи опашки се налагаше да се угодим на недостъпност по време на синхронизацията.
Kafka има концепция за „предпочитани реплики“ на ролята на лидер. Когато се създават раздели на темата, Kafka се опитва равномерно да разпределя лидерите по възлите и отбелязва първоначалните лидери като предпочитани. С времето, поради рестартиране на сървърите, повреди и проблеми със свързаността, лидерите могат да се окажат на други възли, както бе споменато в горния крайния случай.
За да се поправи това, Kafka предлага два варианта:
- Опция auto.leader.rebalance.enable=true позволява на контролния възел автоматично да преназначи лидерите обратно на предпочитаните реплики, възстановявайки по този начин равномерното разпределение.
- Администраторът може да стартира скрипт kafka-preferred-replica-election.sh за ръчно преназначаване.
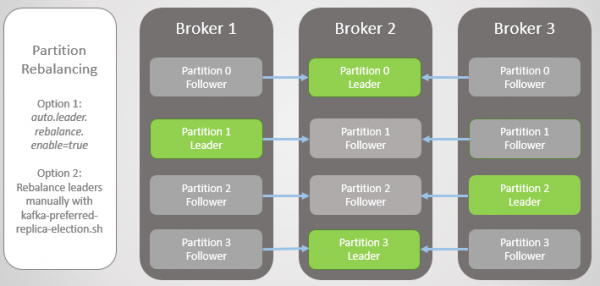
Рис. 6. Реплики след преразпределение
Това беше опростена версия на сбоя, но реалността е по-сложна, въпреки че тук няма нищо твърде сложно. Всичко опира до синхронизираните реплики (In-Sync Replicas, ISR).
Синхронизирани реплики (ISR)
ISR е набор от реплики на раздел, който се счита за „синхронизиран“. Има лидер, а следователи може и да няма. Следователят се счита за синхронизиран, ако е направил точни копия на всички съобщения на лидера в рамките на времевия интервал replica.lag.time.max.ms.
Следователят се премахва от набора ISR, ако:
- не е направил заявка за извличане в интервала replica.lag.time.max.ms (се счита за мъртъв)
- не е успял да се обнови в интервала replica.lag.time.max.ms (се счита за бавен)
Следователите правят заявки за извличане в интервала replica.fetch.wait.max.ms, който по подразбиране е 500 мс.
За да се обясни ясно целта на ISR, е необходимо да се разгледат потвържденията от производителя и някои сценарии на повреда. Производителите могат да изберат, когато брокерът изпраща потвърдение:
- acks=0, потвърждението не се изпраща
- acks=1, потвърждението се изпраща след като лидерът запише съобщението в своя локален лог
- acks=all, потвърждението се изпраща след като всички реплики в ISR запишат съобщението в локалните логове
В терминологията на Kafka, ако ISR е запазил съобщението, се извършва неговото 'комит'. Acks=all е най-сигурният вариант, но и с допълнителна закъснение. Нека разгледаме два примера за отказ и как различните опции 'acks' взаимодействат с концепцията ISR.
Acks=1 и ISR
В този пример ще видим, че ако лидерът не чака запазването на всяко съобщение от всички последователи, то при отказ на лидера може да настъпи загуба на данни. Преминаването към несинхронизиран последовател може да бъде разрешено или забранено с настройката unclean.leader.election.enable.
В този пример производителят е настроен с acks=1. Разделът е разпределен между трите брокера. Брокер 3 изостава, той е синхронизиран с лидера преди осем секунди и сега изостава с 7456 съобщения. Брокер 1 е изоставил само с една секунда. Нашият производител изпраща съобщение и бързо получава обратно ack, без излишен натоварване от бавни или мъртви последователи, които лидерът не чака.
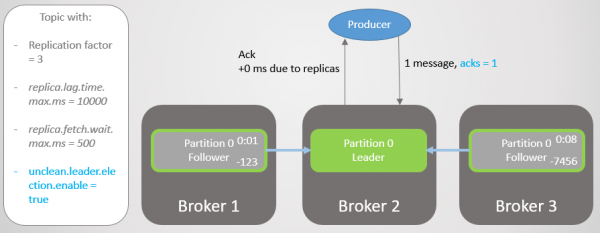
Рис. 7. ISR с три реплики
Брокер 2 се проваля, и производителят получава грешка при свързване. След превключването на лидерството към брокер 1, ние губим 123 съобщения. Последователят на брокер 1 е бил в ISR, но не е бил напълно синхронизиран с лидера, когато той е паднал.
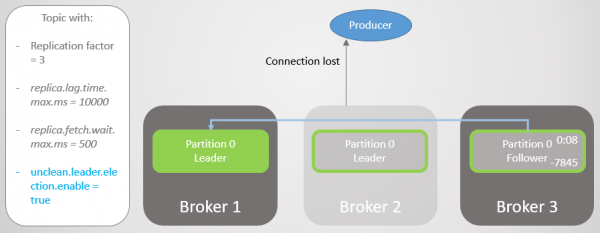
Рис. 8. При отказ се губят съобщения
В конфигурацията bootstrap.servers производителят изброява няколко брокера и може да запита друг брокер, кой е новият лидер на раздела. След това той установява свързване с брокер 1 и продължава да изпраща съобщения.
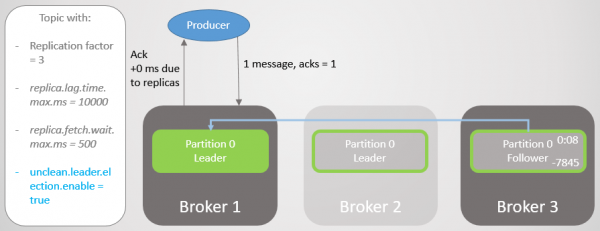
Рис. 9. Изпращането на съобщения се възобновява след кратка пауза
Брокер 3 изостава още повече. Той прави заявки за извличане, но не може да се синхронизира. Това може да е свързано с бавна мрежова връзка между брокерите, проблем с хранилището и т.н. Той е премахнат от ISR. Сега ISR се състои от единствена реплика — лидера! Производителят продължава да изпраща съобщения и получава потвърждения.
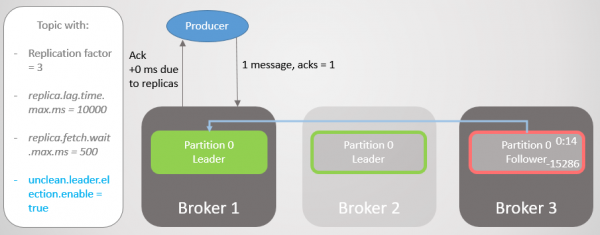
Рис. 10. Последователят на брокер 3 е премахнат от ISR
Брокер 1 пада, и ролята на лидер преминава към брокер 3 с загуба на 15286 съобщения! Производителят получава грешка при свързване. Превключването към лидер извън ISR е било възможно само поради настройката unclean.leader.election.enable=true. Ако тя е настроена на неверно, то преминаването няма да се случи, а всички заявки за четене и запис ще бъдат отхвърлени. В този случай очакваме връщането на брокера 1 с неговите непокътнати данни в репликата, която отново ще поеме лидерството.
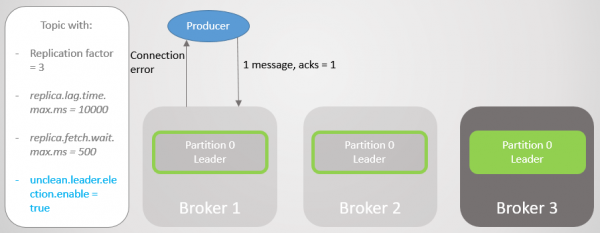
Фиг. 11. Брокер 1 пада. При повреда се губи голямо количество съобщения
Производителят установява връзка с последния брокер и вижда, че той вече е лидер на частта. Той започва да изпраща съобщения на брокер 3.
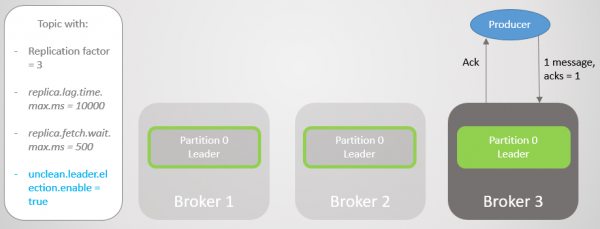
Фиг. 12. След кратка пауза съобщенията отново се изпращат в част 0
Видяхме, че освен кратките прекъсвания за установяване на нови връзки и търсене на нов лидер, производителят постоянно изпращаше съобщения. Тази конфигурация осигурява наличност за сметка на съгласуваност (сигурност на данните). Kafka загуби хиляди съобщения, но продължи да приема нови записи.
Acks=all и ISR
Нека повторим този сценарий още веднъж, но с acks=all. Закъснението на брокер 3 е средно четири секунди. Производителят изпраща съобщение с acks=all, и сега не получава бърз отговор. Лидерът чака, докато съобщението бъде запазено от всички реплики в ISR.
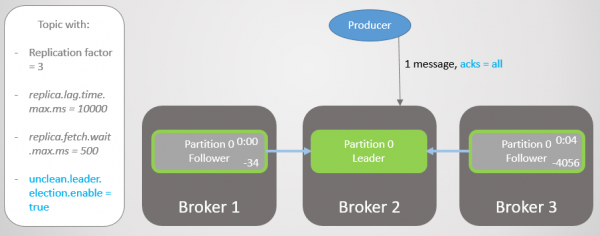
Фиг. 13. ISR с три реплики. Една работи бавно, което води до забавяне на записа
След четири секунди допълнително закъснение брокер 2 изпраща ack. Всички реплики сега са напълно актуализирани.
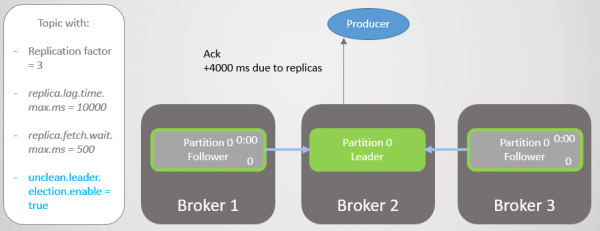
Фиг. 14. Всички реплики запазват съобщения и изпраща ack
Брокер 3 сега изостава още повече и е премахнат от ISR. Закъснението значително намалява, тъй като в ISR не останаха бавни реплики. Брокер 2 сега чака само брокер 1, а средното му забавяне е 500 мс.
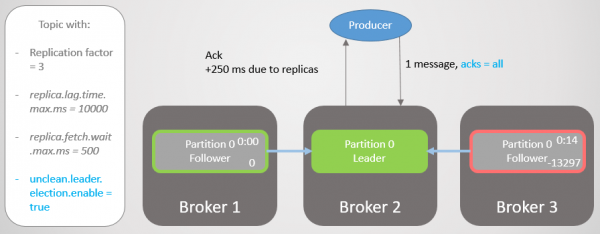
Фиг. 15. Реплика на брокер 3 е премахната от ISR
След това брокер 2 пада и лидерството преминава към брокер 1 без загуба на съобщения.
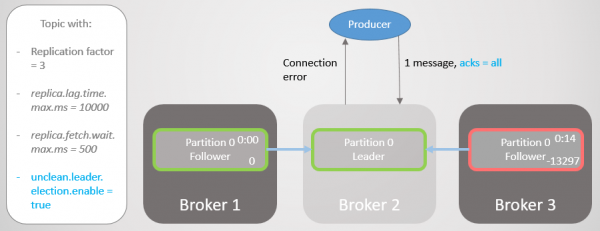
Фиг. 16. Брокер 2 пада
Производителят намира нов лидер и започва да му изпраща съобщения. Закъснението отново намалява, тъй като сега ISR се състои от една реплика! Затова опцията acks=all не добавя излишъци.
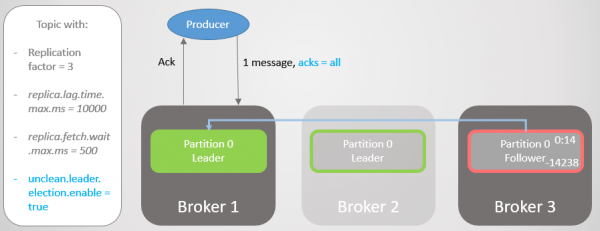
Фиг. 17. Реплика на брокер 1 поема лидерството без загуба на съобщения
След това брокер 1 пада и лидерството преминава към брокер 3 с загуба на 14238 съобщения!
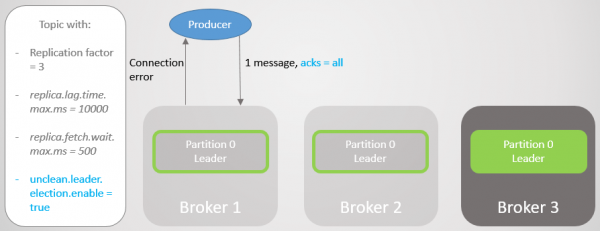
Фиг. 18. Брокер 1 умира, а преходът на лидерството с настройката unclean води до обширна загуба на данни
Можехме да не задаваме опцията unclean.leader.election.enable на стойността истинно. По подразбиране тя е неверно. Настройката acks=all с unclean.leader.election.enable=true осигурява достъпност с известна допълнителна сигурност на данните. Но, както виждате, все още можем да загубим съобщения.
Но какво, ако искаме да увеличим сигурността на данните? Можем да настроим unclean.leader.election.enable = false, но това не е задължително да ни предпази от загуба на данни. Ако лидерът падне рязко и отнесе данните със себе си, то съобщенията все още са загубени, плюс се губи достъпността, докато администраторът не възстанови ситуацията.
По-добре е да гарантираме излишък на всички съобщения, а в противен случай да се откажем от записването. Тогава поне от гледна точка на брокера, загубата на данни е възможна само при два или повече едновременни провала.
Acks=all, min.insync.replicas и ISR
С конфигурацията на темата min.insync.replicas повишаваме нивото на сигурност на данните. Нека отново да преминем през последната част от миналия сценарий, но този път с min.insync.replicas=2.
Така че, брокер 2 има лидер на репликата, а последователят на брокер 3 е премахнат от ISR.
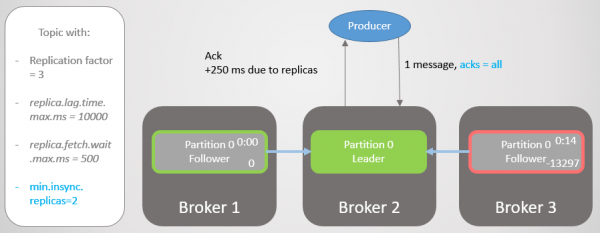
Рис. 19. ISR от две реплики
Брокер 2 пада и лидерството преминава към брокер 1 без загуба на съобщения. Но сега ISR съдържа само една реплика. Това не отговаря на минималния брой за получаване на записи, и следователно брокерът отговаря на опитите за запис с грешка NotEnoughReplicas.
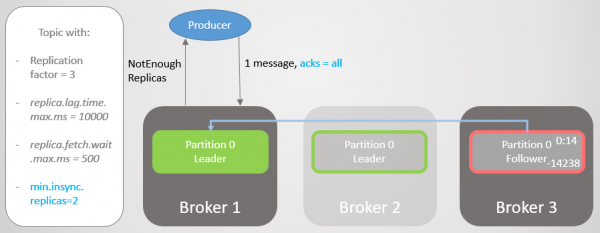
Рис. 20. Броят на ISR е с едно по-малко от посоченото в min.insync.replicas
Тази конфигурация жертва достъпността за сметка на последователността. Преди да потвърдим съобщение, гарантираме, че то се записва на поне две реплики. Това дава на производителя много по-голяма увереност. Тук загубата на съобщения е възможна само в случай на едновременен провал на две реплики в краткия интервал, докато съобщението не бъде репликирано на допълнителен последовател, което е малко вероятно. Но ако сте суперпараноик, можете да зададете коефициент на репликация 5, а min.insync.replicas на 3. Тук три брокера трябва да паднат едновременно, за да загубят записа! Разбира се, за такава надеждност ще платите с допълнителна закъснение.
Когато достъпността е необходима за сигурността на данните
Както и в , понякога достъпността е необходима за сигурността на данните. Трябва да помислите следното:
- Може ли публикуващият просто да върне грешка, а по-горната услуга или потребителят да опита отново по-късно?
- Може ли издателят да запази съобщение локално или в база данни, за да опита отново по-късно?
Ако отговорът е отрицателен, оптимизацията на наличността повишава сигурността на данните. Ще загубите по-малко данни, ако изберете наличност вместо отказ от запис. Така че всичко опира до намиране на баланс, а решението зависи от конкретната ситуация.
Смисъл на ISR
Наборът ISR позволява да изберете оптимален баланс между сигурността на данните и забавянето. Например, осигуряване на наличност при неуспех на повечето реплики, минимизирайки влиянието на мъртви или бавни реплики по отношение на забавянето.
Ние сами избираме значението replica.lag.time.max.ms в съответствие с нашите нужди. По същество този параметър означава какво забавяне сме готови да приемем при acks=all. По подразбиране стойността е десет секунди. Ако това е твърде дълго за вас, можете да я намалите. Тогава честотата на промените в ISR ще нарасне, тъй като фолоуърите ще се премахват и добавят по-често.
В RabbitMQ просто набор от огледала, които трябва да се репликират. Бавните огледала въвеждат допълнително забавяне, а отговорът на мъртвите огледала може да се изчака до изтичането на времето на живот на пакетите, които проверяват наличността на всеки възел (net tick). ISR е интересен начин да се избегнат тези проблеми с увеличеното забавяне. Но рискуваме да загубим излишък, тъй като ISR може да се намали само до лидера. За да избегнете този риск, използвайте настройката min.insync.replicas.
Гарантирано свързване на клиенти
В настройките bootstrap.servers на производителите и потребителите можете да зададете няколко брокера за свързване на клиентите. Идеята е, че при отключване на един възел остават няколко резервни, с които клиентът може да отвори връзка. Те не задължително са лидерите на разделите, а просто плацдарм за начално зареждане. Клиентът може да попита тях, на кой възел се намира лидерът на раздела за четене/писане.
В RabbitMQ клиентите могат да се свързват с всеки възел, а вътрешното маршрутизиране изпраща заявките където трябва. Това означава, че можете да поставите балансировчик на натоварването пред RabbitMQ. Kafka изисква клиентите да се свързват с възел, на който се намира лидерът на съответния раздел. В такава ситуация не можете да поставите балансировчик на натоварването. Списък bootstrap.servers критично важно, за да могат клиентите да получат достъп до необходимите възли и да ги намерят след срив.
Архитектура на консенсуса на Kafka
Все още не сме разгледали как клъстерът научава за падането на брокер и как се избира нов лидер. За да разберем как Kafka работи със мрежови раздели, първо трябва да разберем архитектурата на консенсуса.
Всеки клъстер на Kafka се разгръща заедно с клъстера Zookeeper - това е услуга за разпределен консенсус, която позволява на системата да постигне консенсус за състоянието с приоритет на последователността пред достъпността. За одобряване на операции по четене и запис е необходимо съгласието на мнозинството възли на Zookeeper.
Zookeeper съхранява състоянието на клъстера:
- Списък на темите, разделите, конфигурацията, текущите водещи реплики, предпочитаните реплики.
- Членове на клъстера. Всеки брокер пингва клъстера Zookeeper. Ако не получи пинг в определения период от време, Zookeeper маркира брокера като недостъпен.
- Избор на основни и резервни възли за контролера.
Контролният възел е един от брокерите на Kafka, който отговаря за избора на лидери на реплики. Zookeeper изпраща известия на контролера относно членството в клъстера и промените в темата, а контролерът трябва да реагира на тези промени.
Например, да вземем нова тема с десет раздела и коефициент на репликация 3. Контролерът трябва да избере лидер за всеки раздел, опитвайки се да разпредели лидерите оптимално между брокерите.
За всеки раздел контролерът:
- актуализира информацията в Zookeeper за ISR и лидера;
- изпраща команда LeaderAndISRCommand на всеки брокер, който съхранява реплика на този раздел, информирайки брокерите за ISR и лидера.
Когато падне брокер с лидер, Zookeeper изпраща известие на контролера, който избира нов лидер. Отново, контролерът първо актуализира Zookeeper, след което изпраща команда на всеки брокер, уведомявайки ги за промяната на лидерството.
Всеки лидер носи отговорност за набор от ISR. Конфигурацията replica.lag.time.max.ms определя кой ще влезе. При промяна на ISR лидерът предава новата информация на Zookeeper.
Zookeeper винаги е информиран за всякакви промени, за да може при срив управлението плавно да премине към новия лидер.
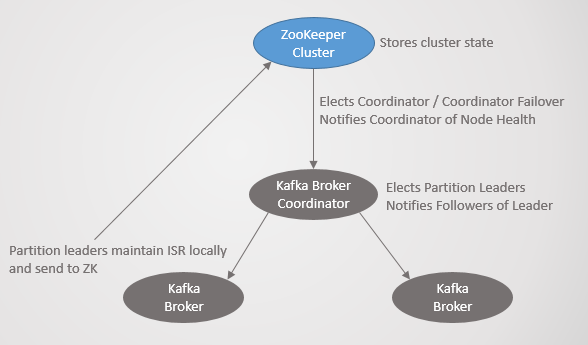
Рис. 21. Консенсус на Kafka
Протокол за репликация
Разбирането на детайлите на репликацията помага да разберете по-добре потенциалните сценарии за загуба на данни.
Запитвания за извличане, Log End Offset (LEO) и Highwater Mark (HW)
Разгледахме как последователите периодично изпращат запитвания за извличане (fetch) на лидера. Интервалът по подразбиране е 500 мс. Това се различава от RabbitMQ, където репликацията се инициира не от огледалото на опашката, а от мастера. Мастера изпраща промени на огледалата.
Лидерът и всички последователи запазват офсета на края на лог файла (Log End Offset, LEO) и метката Highwater (HW). Отметката LEO съхранява офсета на последното съобщение в локалната реплика, а HW — офсета на последния комит. Имайте предвид, че за статус „комит“ съобщението трябва да е запазено във всички реплики ISR. Това означава, че LEO обикновено леко изпреварва HW.
Когато лидерът получи съобщение, той го запазва локално. Последователят прави запитване за извличане, предавайки своя LEO. След това лидерът изпраща пакет от съобщения, започвайки от този LEO, и предава текущия HW. Когато лидерът получи информация, че всички реплики са запазили съобщението със зададения офсет, той премества отметката HW. Само лидерът може да премества HW, и така всички последователи узнават текущото значение в отговорите на своето запитване. Това означава, че последователите могат да изостават от лидера и по съобщение, и относно знанието за HW. Потребителите получават съобщения само до текущия HW.
Обърнете внимание, че „запазен“ (persisted) означава записан в паметта, а не на диск. За производителността, Kafka извършва синхронизация на диска с определен интервал. RabbitMQ също има такъв интервал, но той ще изпрати потвърждение на публикувача само след като мастера и всички огледала запишат съобщението на диск. Разработчиците на Kafka по съображения за производителност решиха да изпращат ack веднага след като съобщението е записано в паметта. Kafka разчита, че излишъкът компенсира риска от краткосрочно съхранение на потвърдените съобщения само в паметта.
Провал на лидера
Когато лидерът падне, Zookeeper уведомява контролера и той избира нова реплика на лидера. Новият лидер установява нова отметка HW в съответствие със своя LEO. След това информацията за новия лидер получават последователите. В зависимост от версията на Kafka, последователят ще избере един от двата сценария:
- Логът ще бъде скъсен до известната HW и ще изпрати на новия лидер заявка за съобщения след тази отметка.
- Ще изпрати на лидера заявка, за да узнае HW в момента на избора му за лидер, а след това ще скъси логът до това преместване. След това ще започне да прави периодични заявки за изтегляне, започвайки от това преместване.
Фолловерът може да се наложи да скъси лога по следните причини:
- Когато се случи срив на лидера, първият фолловер от набора ISR, регистриран в Zookeeper, печели изборите и става лидер. Всички фолловери в ISR, макар и считани за 'синхронизирани', може и да не са получили от бившия лидер копия на всички съобщения. Възможно е избраният фолловер да няма най-актуалната копия. Kafka гарантира, че между репликите няма разминаване. Следователно, за да се избегне разминаването, всеки фолловер трябва да скъси своя лог до стойността на HW на новия лидер в момента на избора му. Това е още една причина, защо конфигурацията acks=all е толкова важна за консистентността.
- Съобщенията периодично се записват на диск. Ако всички узли на клъстера се провалят едновременно, на дисковете ще се запазят реплики с различно преместване. Възможно е, когато брокерите отново се върнат в мрежата, новият лидер, който ще бъде избран, да е зад своите фолловери, тъй като е запазил на диск преди другите.
Възстановяване на свързаността с клъстера
При възстановяване на свързаността с клъстера, репликите пристигат както при срив на лидера: проверяват репликата на лидера и скъсяват своя лог до неговия HW (в момента на избора). За сравнение, RabbitMQ оценява отново свързаните узли като напълно нови. В двете ситуации брокерът отхвърля всякакво съществуващо състояние. Ако се използва автоматична синхронизация, майсторът трябва да репликира абсолютно всичкото текущо съдържание в новото огледало, по начин 'и нека целият свят да почака'. По време на тази операция майсторът не приема никакви операции за четене или писане. Този подход създава проблеми в големи опашки.
Kafka е разпределен лог и по принцип той съхранява повече съобщения, отколкото опашката RabbitMQ, където данните се изтриват от опашката след прочитането им. Активните опашки трябва да остават относително малки. Но Kafka е лог със собствена политика на съхранение, която може да задава срок от дни или седмици. Подходът с заключване на опашката и пълна синхронизация е абсолютно неприемлив за разпределен лог. Вместо това, последователите на Kafka просто отрязват своя лог до HW лидера (в момента на неговото избиране), в случай че тяхната копия изпреварва лидера. В по-вероятния случай, когато последователят е отзад, той просто започва да прави запитвания за извличане, започвайки от текущия си LEO.
Новите или повторно свързани последователи започват извън ISR и не участват в комитите. Те просто работят до групата, получавайки съобщения толкова бързо, колкото могат, докато не настигнат лидера и не влязат в ISR. Няма заключване и не е необходимо да изхвърлят всичките си данни.
Нарушение на свързаността
Kafka има повече компоненти от RabbitMQ, така че тук има по-сложен набор от поведения, когато в клъстера се нарушава свързаността. Но Kafka е проектирана първоначално за клъстери, така че решенията са много добре обмислени.
По-долу са представени няколко сценария на нарушаване на свързаността:
- Сценарий 1. Последователят не вижда лидера, но все още вижда Zookeeper.
- Сценарий 2. Лидерът не вижда нито един последовател, но все още вижда Zookeeper.
- Сценарий 3. Последователят вижда лидера, но не вижда Zookeeper.
- Сценарий 4. Лидерът вижда последователите, но не вижда Zookeeper.
- Сценарий 5. Последователят е напълно отделен и от другите узли Kafka, и от Zookeeper.
- Сценарий 6. Лидерът е напълно отделен и от другите узли Kafka, и от Zookeeper.
- Сценарий 7. Узелът контролер на Kafka не вижда друг узел Kafka.
- Сценарий 8. Контролерът на Kafka не вижда Zookeeper.
За всеки сценарий е предвидено свое поведение.
Сценарий 1. Последователят не вижда лидера, но все още вижда Zookeeper
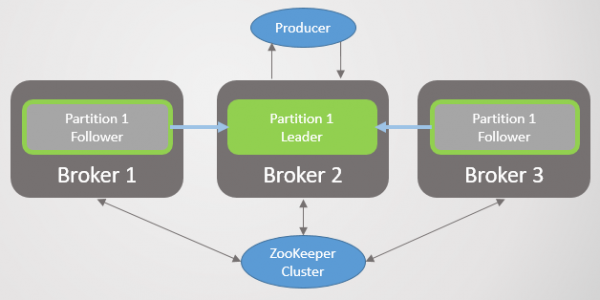
Рис. 22. Сценарий 1. ISR от три реплики
Нарушение на свързаността отделя брокер 3 от брокерите 1 и 2, но не и от Zookeeper. Брокер 3 вече не може да изпраща запитвания за извличане. След изтичане на времето replica.lag.time.max.ms Той се премахва от ISR и не участва в комитите на съобщения. Щом свързаността бъде възстановена, той ще възобнови заявките за извличане и ще се присъедини към ISR, когато настигне водача. Zookeeper ще продължи да получава пинг и да смята, че брокерът е жив и здрав.
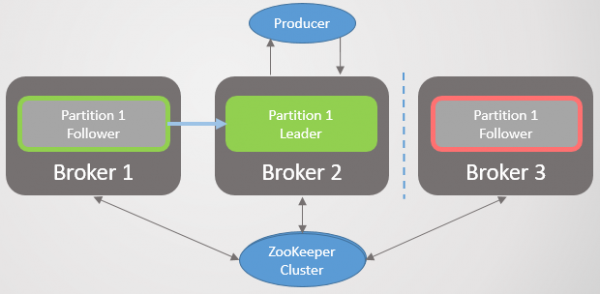
Рис. 23. Сценарий 1. Брокерът се премахва от ISR, ако не е получена заявка за извличане в рамките на интервала replica.lag.time.max.ms
Няма логично разделение (split-brain) или спиране на възела, както в RabbitMQ. Вместо това се намалява излишността.
Сценарий 2. Водачът не вижда нито един последовател, но все още вижда Zookeeper
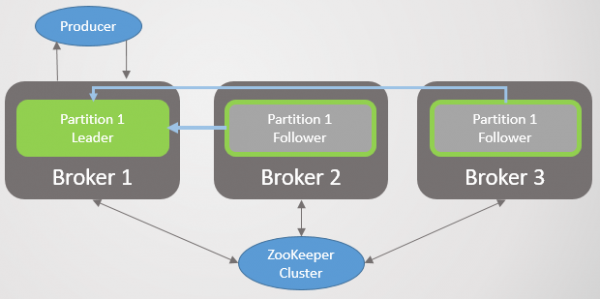
Рис. 24. Сценарий 2. Водачът и двама последователи
Нарушение на мрежовата свързаност отделя водача от последователите, но брокерът все още вижда Zookeeper. Както в първия сценарий, ISR се свива, но този път само до водача, тъй като всички последователи спират да изпращат заявки за извличане. Отново няма логично разделение. Вместо това става загуба на излишност за новите съобщения, докато свързаността не бъде възстановена. Zookeeper продължава да получава пинг и смята, че брокерът е жив и здрав.
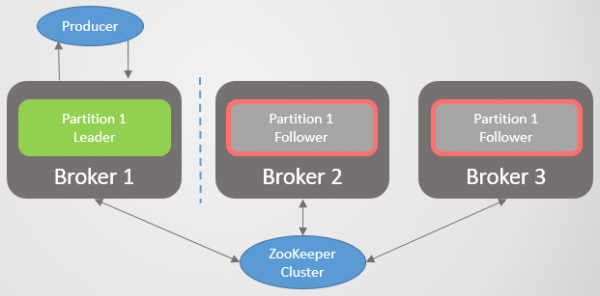
Рис. 25. Сценарий 2. ISR се е свил само до водача
Сценарий 3. Последователят вижда водача, но не вижда Zookeeper
Последователят се отделя от Zookeeper, но не и от брокера с водача. В резултат на това последователят продължава да изпраща заявки за извличане и да бъде член на ISR. Zookeeper вече не получава пинг и регистрира падането на брокера, но тъй като това е само последовател, няма последици след възстановяването.
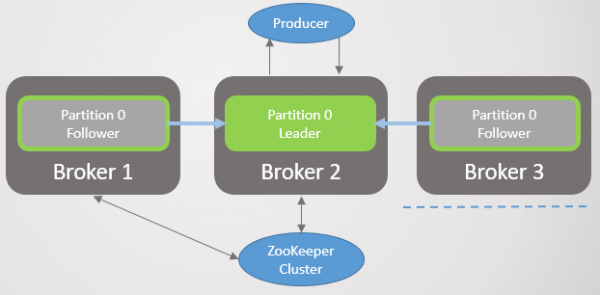
Рис. 26. Сценарий 3. Последователят продължава да изпраща заявки за извличане на водача
Сценарий 4. Водачът вижда последователите, но не вижда Zookeeper
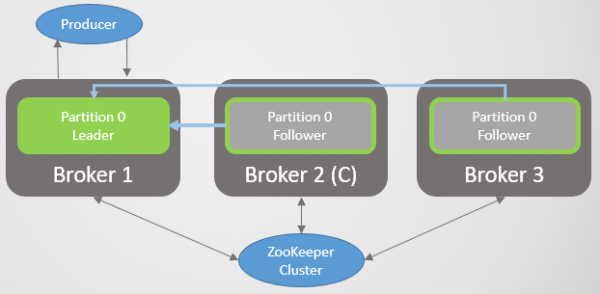
Рис. 27. Сценарий 4. Водачът и двама последователи
Водачът е отделен от Zookeeper, но не и от брокерите с последователите.
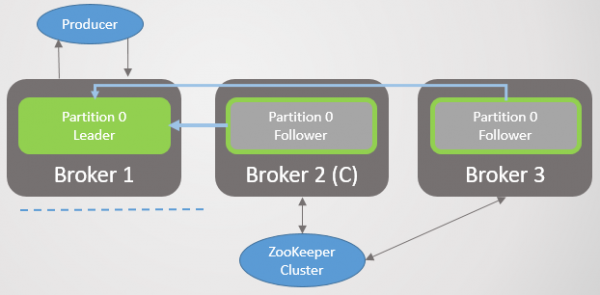
Рис. 28. Сценарий 4. Водачът е изолиран от Zookeeper
След известно време Zookeeper ще регистрира падането на брокера и ще уведоми контролера. Той ще избере нов водач сред последователите. Въпреки това, оригиналният водач ще продължи да смята, че е водач и ще продължи да приема записи с acks=1. Последователите вече не му изпращат заявки за извличане, така че той ще ги смята за мъртви и ще се опита да свие ISR до самия себе си. Но тъй като няма връзка с Zookeeper, няма да може да го направи и в този момент ще откаже по-нататъшното приемане на записи.
Съобщения acks=all няма да получат потвърждение, защото първоначално ISR включва всички реплики, а до тях съобщенията не достигат. Когато първоначалният лидер се опита да ги изтрие от ISR, той няма да може да го направи и изобщо ще спре да приема каквито и да било съобщения.
Клиентите скоро забелязват смяната на лидера и започват да изпращат записи на новия сървър. Щом мрежата се възстанови, първоначалният лидер вижда, че вече не е лидер, и скъсява своя лог до стойността на HW, която е имал новият лидер по време на срив, за да избегне разминаване на логовете. След това ще започне да изпраща заявки за извличане на новия лидер. Всички записи на първоначалния лидер, които не са реплицирани на новия лидер, ще бъдат загубени. Тоест, ще бъдат загубени съобщения, които не са потвърдени от първоначалния лидер в онези няколко секунди, когато е работило двама лидери.
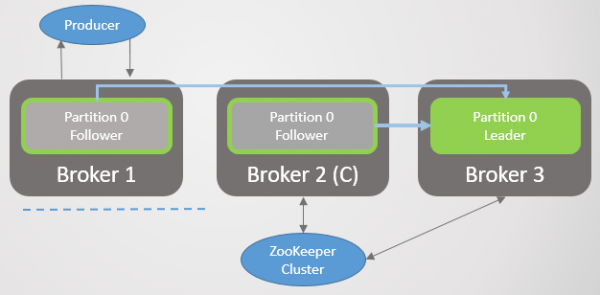
Рис. 29. Сценарий 4. Лидерът на брокер 1 става последовател след възстановяването на мрежата
Сценарий 5. Последователят е напълно изолиран както от другите възли на Kafka, така и от Zookeeper
Последователят е напълно изолиран както от другите възли на Kafka, така и от Zookeeper. Той просто се изтрива от ISR, докато мрежата не се възстанови, а след това наваксва останалите.

Рис. 30. Сценарий 5. Изолираният последовател се изтрива от ISR
Сценарий 6. Лидерът е напълно изолиран както от другите възли на Kafka, така и от Zookeeper
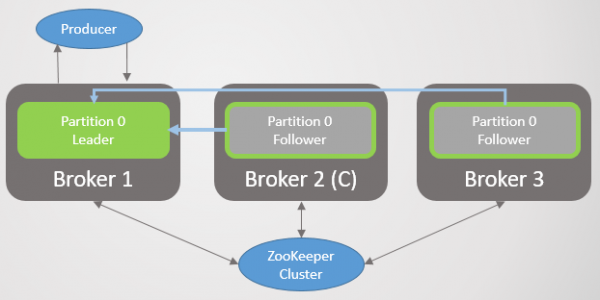
Рис. 31. Сценарий 6. Лидерът и двама последователи
Лидерът е напълно изолиран от своите последователи, контролера и Zookeeper. За кратък период от време той ще продължи да приема записи от acks=1.
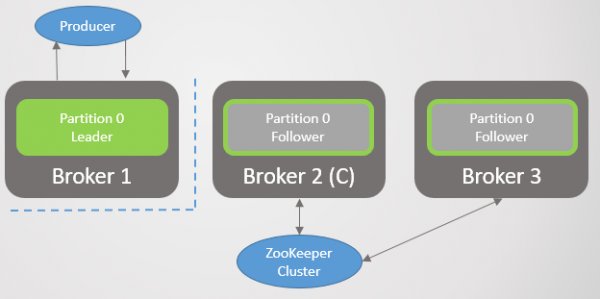
Рис. 32. Сценарий 6. Изолация на лидера от другите възли на Kafka и Zookeeper
Не получавайки заявки след изтичането на replica.lag.time.max.ms, той ще се опита да компресира ISR до себе си, но няма да може да го направи, тъй като няма свързаност с Zookeeper, след което ще спре да приема записи.
Междувременно, Zookeeper ще отбележи изолирания брокер като мъртъв, а контролерът ще избере нов лидер.
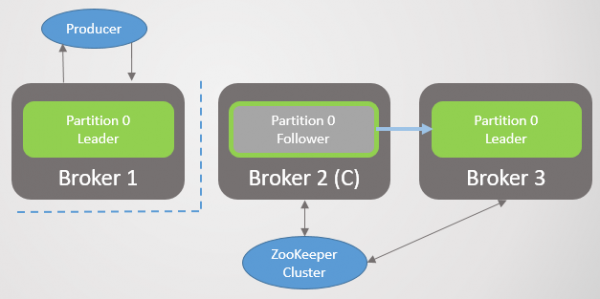
Рис. 33. Сценарий 6. Двама лидери
Първоначалният лидер може да приема записи в продължение на няколко секунди, но след това спира да приема каквито и да било съобщения. Клиентите се актуализират на всеки 60 секунди с последните метаданни. Те ще бъдат информирани за смяната на лидера и ще започнат да изпращат записи на новия лидер.
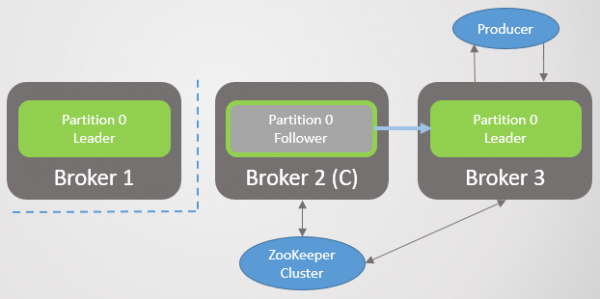
Рис. 34. Сценарий 6. Производителите преминават към новия лидер
Ще бъдат загубени всички потвърдени записи, направени от първоначалния лидер от момента на загубата на свързаност. Когато мрежата бъде възстановена, първоначалният лидер чрез Zookeeper ще установи, че вече не е лидер. След това той ще отреже своя лог до HW на новия лидер по време на избора и ще започне да изпраща заявки като последовател.
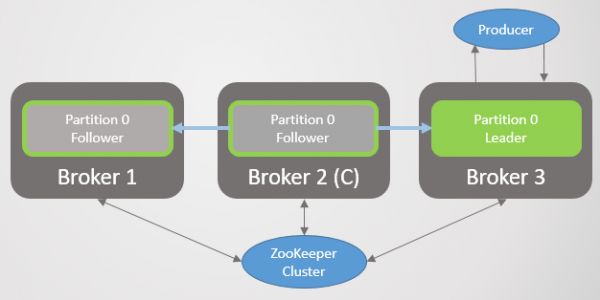
Рис. 35. Сценарий 6. Първоначалният лидер става последовател след възстановяване на свързаността на мрежата
В тази ситуация за кратък период може да се наблюдава логическо разделение, но само ако acks=1 и min.insync.replicas също така 1. Логическото разделение автоматично приключва или след възстановяване на мрежата, когато първоначалният лидер разбере, че вече не е лидер, или когато всички клиенти осъзнаят, че лидерът се е променил и започнат да пишат на новия лидер — в зависимост от това кое ще се случи първо. Във всеки случай ще се загубят някои съобщения, но само с acks=1.
Съществува друг вариант на този сценарий, когато непосредствено преди разделението на мрежата последователите са изостанали, а лидерът е съкратил ISR до един себе си. След това той се изолира заради загубата на свързаност. Избира се нов лидер, но първоначалният лидер продължава да приема записи, дори acks=all, защото в ISR няма никой освен него. Тези записи ще бъдат загубени след възстановяване на мрежата. Единственият начин да се избегне такъв вариант е min.insync.replicas = 2.
Сценарий 7. Узелът на контролера Kafka не вижда друг узел Kafka
Като цяло, след загуба на свързаност с узела Kafka, контролерът няма да може да предаде никаква информация за промяната на лидера. В най-лошия случай това ще доведе до краткосрочно логическо разделение, какъвто е случаят и в сценарий 6. Най-често брокерът просто няма да стане кандидат за лидерство в случай на отказ на последния.
Сценарий 8. Контролерът Kafka не вижда Zookeeper
От откъснатия контролер Zookeeper няма да получи пинг и ще избере нов узел Kafka за контролер. Първоначалният контролер може да продължи да се представя за такъв, но не получава уведомления от Zookeeper и следователно няма да има задачи за изпълнение. След възстановяване на мрежата, той ще разбере, че вече не е контролер, а е станал обикновен узел Kafka.
Изводи от сценарии
Ние виждаме, че загубата на свързаност на последователите не води до загуба на съобщения, а просто временно намалява излишъка, докато мрежата не бъде възстановена. Това, разбира се, може да доведе до загуба на данни, ако бъдат загубени един или повече възли.
Ако поради загуба на свързаност лидерът се отдели от Zookeeper, това може да доведе до загуба на съобщения с acks=1. Липсата на свързаност с Zookeeper предизвиква краткосрочно логическо разделение с двама лидери. Този проблем се решава с параметъра acks=all.
Параметър min.insync.replicas в две или повече реплики дава допълнителни гаранции, че такива краткосрочни сценарии няма да доведат до загуба на съобщения, както в сценарий 6.
Резюме за загуба на съобщения
Нека изброим всички начини, по които могат да се загубят данни в Kafka:
- Всеки срив на лидера, ако съобщенията са били потвърдени с acks=1
- Всеки нечист (unclean) преход на лидерството, т.е. на последовател извън ISR, дори с acks=all
- Изолация на лидера от Zookeeper, ако съобщенията са били потвърдени с acks=1
- Пълна изолация на лидера, който вече е свил групата ISR до себе си. Ще бъдат загубени всички съобщения, дори acks=all. Това е вярно само в случай, че min.insync.replicas=1.
- Същевременно сривове на всички възли на раздела. Тъй като съобщенията се потвърдят от паметта, някои може още да не са записани на диск. След перезареждане на сървърите, може да липсват някои съобщения.
Нечистите преходи на лидерството могат да се избегнат, или като се забранят, или като се осигури излишък от поне две. Най-устойчива конфигурация е комбинацията от acks=all и min.insync.replicas повече от 1.
Пряко сравнение на надеждността на RabbitMQ и Kafka
За осигуряване на надеждност и висока достъпност и двете платформи реализират система за първична и вторична репликация. Въпреки това, RabbitMQ има ахилесова пета. При повторно свързване след срив, възлите отхвърлят своите данни, а синхронизацията е блокирана. Този двойно удар поставя под въпрос дълготрайността на големите опашки в RabbitMQ. Ще трябва да се примирите или със съкращаване на излишъка, или с дълги блокировки. Намаляването на излишъка увеличава риска от масова загуба на данни. Но ако опашките са малки, то за осигуряване на излишъка с кратки периоди на недостъпност (няколко секунди) може да се справите с повторни опити за свързване.
В Kafka няма такъв проблем. Тя отхвърля данни само от точката на несъответствие между лидера и последователя. Всички общи данни се запазват. Освен това, репликацията не блокира системата. Лидерът продължава да приема записи, докато новият последовател го догонва, така че за девопсите свързването или повторното свързване на клъстера става тривиална задача. Разбира се, остават все още проблеми, като например пропускателната способност на мрежата при репликация. Ако едновременно се добавят няколко последователя, може да се сблъскате с лимита на пропускателната способност.
RabbitMQ превъзхожда Kafka в надеждността при едновременен срив на няколко сървъра в клъстера. Както вече казахме, RabbitMQ изпраща потвърждение на публикувача само след записване на съобщението на диск при мастера и всички огледала. Но това добавя допълнителна забавяне по две причини:
- fsync на всеки няколко стотин милисекунди
- Сривът на огледалото може да бъде забелязан само след изтичането на времето на живот на пакетите, които проверяват наличността на всеки възел (net tick). Ако огледалото забавя или е паднало, това добавя забавяне.
Kafka залага на това, че ако съобщението се съхранява на няколко възела, може да се потвърдят съобщения, веднага след като стигнат до паметта. Поради това съществува риск от загуба на съобщения от всякакъв тип (дори acks=all, min.insync.реплики=2) в случай на едновременен отказ.
Като цяло Kafka демонстрира по-висока производителност и е проектирана първоначално за клъстери. Броят на последователите може да бъде увеличен до 11, ако това е необходимо за надеждност. Коефициентът на репликация 5 и минималното число на репликите в синхронизирано състояние min.insync.replicas=3 ще направят загубата на съобщения много рядко събитие. Ако вашата инфраструктура може да осигури такъв коефициент на репликация и ниво на излишност, можете да изберете тази опция.
Клъстеризацията на RabbitMQ е добра за малки опашки. Но дори малки опашки могат бързо да нараснат при голям трафик. След като опашките станат големи, ще трябва да направите трудно решение между достъпността и надеждността. Клъстеризацията на RabbitMQ е най-подходяща за не толкова типични ситуации, при които предимствата на гъвкавостта на RabbitMQ надвишават недостатъците на неговата клъстеризация.
Едно от противодействия на уязвимостите на RabbitMQ относно големи опашки е да ги разделите на множество по-малки. Ако не се изисква пълно подредба на цялата опашка, а само на конкретни съобщения (например, съобщения от конкретен клиент) или изобщо нищо да не се подрежда, то този вариант е приемлив: погледнете моя проект. за разделяне на опашката (проектът е все още в ранна фаза).
Накрая, не забравяйте за редица грешки в механизмите за клъстеризация и репликация както при RabbitMQ, така и при Kafka. С времето системите станаха по-зрели и стабилни, но никое съобщение никога няма да бъде на 100% защитено от загуба! Освен това, в дата центровете се случват мащабни аварии!
Ако съм пропуснал нещо, направил съм грешка или ако не сте съгласни с някоя от тези тези, не се колебайте да напишете коментар или да се свържете с мен.
Често ме питат: "Какво да изберем, Kafka или RabbitMQ?", "Коя платформа е по-добра?". Истината е, че това наистина зависи от вашата ситуация, текущия опит и т.н. Не се осмелявам да изразя мнение, тъй като би било твърде голямо опрощаване да се препоръча една единствена платформа за всички случаи на употреба и възможни ограничения. Написах този цикъл от статии, за да можете да формирате собствено мнение.
Искам да кажа, че и двете системи са лидери в тази област. Може би съм малко пристрастен, защото от опита на проектите си повече ценя неща като гарантирано подреждане на съобщения и надеждност.
Виждам други технологии, на които им липсва тази надеждност и гарантирано подреждане, след което поглеждам към RabbitMQ и Kafka — и разбирам невероятната стойност на двете системи.
Източник: habr.com
