

Преводът на статията е подготвен в очакване на старта на курса
Разпределеното обучение на множество високо производителни изчислителни инстанции може да съкрати времето за обучение на съвременни дълбоки невронни мрежи с голямо количество данни от седмици до часове или дори минути, което прави тази техника на обучение доминираща в практическото използване на дълбокото обучение. Потребителите трябва да разбират как да споделят и синхронизират данни на множество инстанции, което от своя страна оказва голямо влияние върху ефективността на мащабиране. Освен това, потребителите трябва да знаят как да разгръщат обучителен скрипт на множество инстанции, който работи на една инстанция.
В тази статия ще разгледаме бърз и прост начин за разпределено обучение с помощта на отворената библиотека за дълбоко обучение Apache MXNet и фреймворка за разпределено обучение Horovod. Нагледно ще покажем предимствата на фреймворка Horovod по отношение на производителността и ще демонстрираме как да напишем обучителен скрипт MXNet, така че той да работи разпределено с Horovod.
Какво е Apache MXNet
– отворен фреймворк за дълбоко обучение, който се използва за създаване, обучение и разгръщане на дълбоки невронни мрежи. MXNet абстрахира сложността, свързана с реализирането на невронни мрежи, предлага висока производителност и скалируемост, а също така предлага API за популярни програмни езици като , , , , , , и други.
Разпределено обучение в MXNet с параметричен сървър
използва подхода на параметричен сървър (parameter server). Той използва набор от параметрични сървъри за събиране на градиенти от всеки работник, извършване на агрегиране и изпращане на обновените градиенти обратно на работниците за следващата итерация на оптимизация. Определянето на правилното съотношение между сървъри и работници е ключът към ефективното мащабиране. Ако има само един параметричен сървър, той може да се окаже тесен бутон в провеждането на изчисления. И обратно, ако се използват твърде много сървъри, свързаността „много-до-много“ може да запълни всички мрежови връзки.
Какво е Horovod
– отворен фреймворк за разпределено дълбочинно обучение, разработен от Uber. Той използва ефективни технологии за взаимодействие между няколко GPU и възли, като NVIDIA Collective Communications Library (NCCL) и Message Passing Interface (MPI) за разпределение и агрегиране на параметрите на модела между работещите рамки. Оптимизира използването на мрежовата пропускателна способност и се мащабира добре при работа с модели на дълбоки невронни мрежи. В момента поддържа няколко популярни фреймворка за машинно обучение, а именно , Tensorflow, Keras и PyTorch.
Интеграция на MXNet и Horovod
MXNet се интегрира с Horovod чрез API за разпределено обучение, дефинирани в Horovod. В Horovod комуникационните API horovod.broadcast(), horovod.allgather() и horovod.allreduce() са реализирани с помощта на асинхронни колбекове на MXNet, като част от графа му на задачи. Така зависимостите на данните между комуникацията и изчисленията лесно се управляват от MXNet, за да се избегне загуба на производителност поради синхронизация. Обектът distributed optimizer, дефиниран в Horovod horovod.DistributedOptimizer разширява Optimizer в MXNet така, че той да извиква съответните API на Horovod за разпределено обновление на параметрите. Всички тези детайли на изпълнение са прозрачни за крайните потребители.
Бързо начало
Можете бързо да започнете обучението на малка свързана невронна мрежа с помощта на MXNet и Horovod на вашия MacBook, като използвате набора от данни MNIST.
За начало инсталирайте mxnet и horovod от PyPI:
pip install mxnet
pip install horovod
Забележка: Ако получите грешка по време на pip install horovod, може да се наложи да добавите променлива MACOSX_DEPLOYMENT_TARGET=10.vv, където vv – това е версията на вашето MacOS, например, за MacOSX Sierra трябва да напишете MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
След това инсталирайте OpenMPI .
Накрая изтеглете тестовия скрипт mxnet_mnist.py и изпълнете следните команди в терминала на вашия MacBook в работната директория:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyТака ще стартирате обучението на два ядра на вашия процесор. На изхода ще получите следното:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Демонстрация на производителността
При обучението на модела ResNet50-v1 на набора от данни ImageNet на 64 GPU с осем инстанции p3.16xlarge EC2, все от които съдържат 8 GPU NVIDIA Tesla V100 в AWS облака, достигнахме капацитет на обучение от 45000 изображения/сек (т.е. брой обучени примери в секунда). Обучението завърши за 44 минути след 90 епохи с най-добра точност от 75.7%.
Сравнихме това с разпределеното обучение в MXNet, използвайки подхода с параметрични сървъри на 8, 16, 32 и 64 GPU с един параметричен сървър и съотношение на сървъри към работници 1 към 1 и 2 към 1 съответно. Резултатът можете да видите на Фигура 1 по-долу. На оста y отляво колоните отразяват броя на изображенията, които се обучават в секунда, а линиите отразяват ефективността на мащабиране (т.е. съотношението на действителния капацитет към идеалния) на оста y отдясно. Както виждате, изборът на брой сървъри влияе на ефективността на мащабирането. Ако параметричният сървър е един, ефективността на мащабиране спада до 38% при 64 GPU. За да постигнете същата ефективност на мащабиране като с Horovod, трябва да увеличите броя на сървърите два пъти по отношение на броя на работниците.
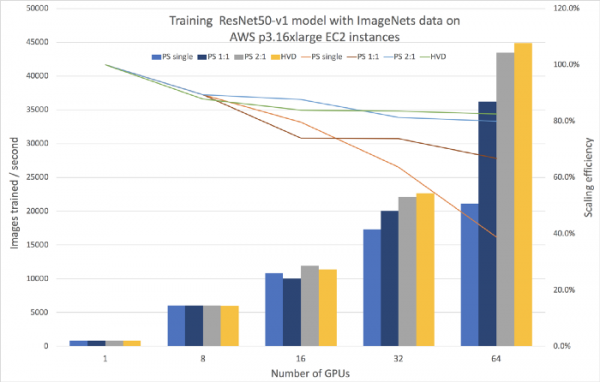
Фигура 1. Сравнение на разпределеното обучение, използвайки MXNet с Horovod и с параметричен сървър.
В Таблица 1 по-долу сравнихме крайната стойност на инстанцията при провеждане на експерименти на 64 GPU. Използването на MXNet заедно с Horovod осигурява най-добър капацитет при най-ниски разходи.
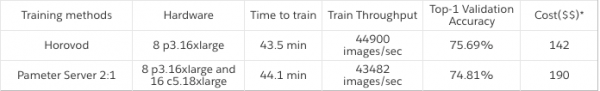
Таблица 1. Сравнение на разходите между Horovod и параметричния сървър с отношение сървъри към работници 2 към 1.
Стъпки за възпроизвеждане.
В следващите стъпки ще ви разкажем как да възпроизведете резултата от разпределеното обучение с помощта на MXNet и Horovod. За повече информация относно разпределеното обучение с MXNet, прочетете .
Стъпка 1
Създайте клъстер от хомогенни инстанции с MXNet версия 1.4.0 или по-нова и Horovod версия 0.16.0 или по-нова, за да използвате разпределеното обучение. Също така ще трябва да инсталирате библиотеки за обучение на GPU. За нашите инстанции избрахме Ubuntu 16.04 Linux, с GPU драйвер 396.44, CUDA 9.2, библиотека cuDNN 7.2.1, комуникатор NCCL 2.2.13 и OpenMPI 3.1.1. Можете също така да използвате , където тези библиотеки вече са инсталирани.
Стъпка 2
Добавете в обучителния си скрипт MXNet възможностите за работа с API Horovod. Посоченият по-долу скрипт, основан на MXNet Gluon API, може да се използва като прост шаблон. Строфите, изписани с удебелен шрифт, са необходими, ако вече разполагате с подходящ обучителен скрипт. Ето няколко критични промени, които трябва да направите за обучение с Horovod:
- Настройте контекста в съответствие с локалния ранг на Horovod (ред 8), така че да разберете, че обучението се извършва на правилното графично ядро.
- Предайте началните параметри от един работник на всички (ред 18), за да се уверите, че всички работници започват работа с еднакви начални параметри.
- Създайте Horovod DistributedOptimizer (ред 25), за да актуализирате параметрите разпределено.
За да получите пълния скрипт, обърнете се към примери за Horovod-MXNet. и .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: инициализиране на Horovod
5  hvd.init()
6
7  # Horovod: заковавайте GPU, който да се използва по локален ранг
8  context = mx.gpu(hvd.local_rank())
9
10 # Създайте модел
11 model = ...
12
13 # Инициализиране на параметри
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: разпространение на параметри
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Създайте оптимизатор
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: обвийте оптимизатора с DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Създайте треньор и функция за загуба
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Обучете модела
32 for epoch in range(num_epoch):
33    ...
Стъпка 3
Влезте в един от работниците, за да стартирате разпределено обучение с помощта на директивата MPI. В този пример разпределеното обучение се стартира на четири инстанции с по 4 GPU всяка, и с 16 GPU в кластера в крайна сметка. Ще се използва оптимизатор на стохастичен градиентен спуск (SGD) със следните гиперпараметри:
- размер на мини-пакета: 256
- степен на учене: 0.1
- моменто: 0.9
- намаление на теглото: 0.0001
При скалиране от един GPU до 64 GPU, ние линейно увеличавахме скоростта на учене в съответствие с броя на GPU (от 0,1 за 1 GPU до 6,4 за 64 GPU), като същевременно запазвахме броя на изображенията, които падат на един GPU, равен на 256 (от пакет от 256 изображения за 1 GPU до 16 384 за 64 GPU). Параметрите за намаление на теглото и момента се променяха с увеличаване на броя на GPU. Използвахме смесена прецизност на обучението с тип данни float16 при директния проход и float32 за градиентите, за да ускорим изчисленията float16, поддържани от GPU NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Заключение
В тази статия разгледахме мащабируем подход за разпределено обучение на модел с използване на Apache MXNet и Horovod. Показахме ефективността на мащабирането и икономическата ефективност в сравнение с подхода с използване на параметричен сървър на набора от данни ImageNet, на който се обучаваше моделът ResNet50-v1. Също така отбелязахме стъпките, с помощта на които можете да промените вече съществуващ скрипт, за да стартирате обучението на няколко екземпляра с помощта на Horovod.
Ако току-що започвате работа с MXNet и дълбоко обучение, преминете на страницата за инсталация , за да съберете MXNet първо. Също така настоятелно препоръчваме да прочетете статията , за да започнете работа.
Ако вече сте работили с MXNet и искате да опитате разпределено обучение с Horovod, тогава погледнете на , съберете го с MXNet и следвайте примера или .
*цената се изчислява на база AWS за EC2 екземпляри
Научете повече за курса
Източник: habr.com
