

Прим. прев.: Авторът на този материал е Cindy Sridharan, инженер в компанията imgix, която се занимава с разработка на API, и по-специално с тестване на микросервизи. В този материал тя споделя своето задълбочено виждане за актуалните проблеми в сферата на разпределеното проследяване, където, по нейно мнение, наблюдава липса на наистина ефективни инструменти за решаване на спешните задачи.
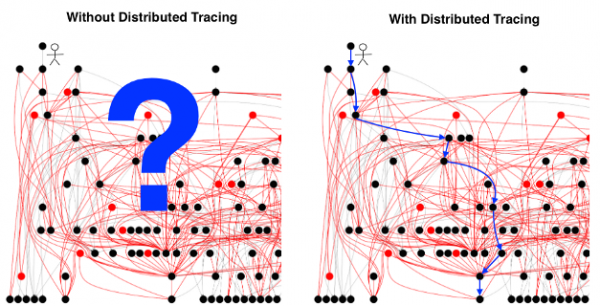
[Илюстрация заета от за разпределеното проследяване.]
Счита се, че е трудно за внедряване, а и ползата от него . „Проблемът“ по проследяването се обяснява с множество причини, като често се споменава трудоемкостта на настройката на всеки компонент от системата за предаване на съответните заглавия заедно с всяка заявка. Въпреки че този проблем действително съществува, не може да се нарече непреодолен. Между другото, той не обяснява защо разработчиците не обичат проследяването (дори вече функциониращото).
Основната трудност с разпределеното проследяване не е събирането на данни, не е стандартизацията на формати за разпространение и представяне на резултатите, нито определянето на това кога, къде и как да се извърши проба. Аз не се опитвам да представя тривиални тези „проблеми с усвояемостта“ — всъщност, съществуват доста значими технически и (ако разгледаме наистина Open Source ) политически предизвикателства, които трябва да се преодолеят, за да могат тези проблеми да се считат за решени.
Въпреки това, ако предположим, че всички тези проблеми са решени, има голяма вероятност, че нищо съществено няма да се промени от гледна точка на опита на крайния потребител. Проследяването все пак може да не носи практическа полза в най-разпространените сценарии за отстраняване на грешки — дори след като е внедрено.
Такова неприлично проследяване
Разпределеното проследяване включва няколко разпокъсани компонента:
- оснащаване на приложения и middleware с инструменти за контрол;
- преди предаване на разпределен контекст;
- събиране на проследявания;
- съхранение на проследявания;
- извличането им и визуализация.
Много разговори за разпределеното проследяване се събират в това да я разглеждат като някаква операционна функция, чиято единствена цел е да помогне за пълната диагностика на системата. Това е свързано с начина, по който исторически са се формирали представите за разпределеното проследяване. В , направено, когато бяха отворени изходните кодове на Zipkin, се споменава, че той [Zipkin] прави Twitter по-бърз.Първите търговски предложения за проследяване също бяха насърчавани като .
Прим. прев.За да се воспримет по-добре следващият текст, да определим два основни термина според :
- Span — основен елемент на разпределеното проследяване. Представлява описание на даден работен процес (например, заявка към база данни) с име, време на начало и край, тагове, логове и контекст.
- Span-овете обикновено съдържат връзки към други span-ове, което позволява да се комбинират множество span-ове в Проследяване — визуализация на живота на заявката по време на нейното преминаване през разпределената система.
Trace-овете съдържат невероятно ценни данни, които могат да помогнат в задачи като: тестване в продукция, провеждане на тестове за възстановяване след авария, тестване с внедряване на грешки и т.н. Всъщност някои компании вече използват проследяване с подобна цел. Нека започнем с това, че има и други приложения освен просто пренасяне на span-ове в система за съхранение:
- Например, Uber резултатите от проследяването за разграничаване на тестовия трафик от производствения трафик.
- Facebook данни от trace-ове за анализ на критичния път и за превключване на трафика по време на редовни тестове за възстановяване след авария.
- Също така социалната мрежа блокноти Jupyter, които позволяват на разработчиците да извършват произволни заявки за резултатите от проследяването.
- Поддръжниците на (Внедряване на грешки, управлявано от произхода) разпределени trace-ове за тестване с внедряване на грешки.
Нито един от изброените по-горе варианти не се отнася изцяло до сценария за отстраняване на неизправности, в който инженерът се опитва да реши проблема, гледайки на trace.
Когато става все пак въпрос за сценария за отстраняване на неизправности, основният интерфейс остава диаграмата traceview (въпреки че някои я наричат «диаграма на Гант» или «каскадна диаграма»). Под traceview аз всички span'и и свързаните метаданни, които заедно образуват trace. Всяка система за трасировка с отворен код, както и всяко комерсиално решение за трасировка предлага основан на traceview потребителски интерфейс за визуализиране, детайлизиране и филтриране на trace-ове.
Проблемът с всички системи за трасировка, с които имам досега опит, е, че крайният визуализация (traceview) практически напълно отразява характеристиките на процеса на генериране на trace. Дори когато се предлагат алтернативни визуализации: карти на интензивност (heatmap), топологии на услуги, хистограми на забавяне (latency), — в крайна сметка всичките те пак водят до traceview.
В миналото аз на това, че повечето «иновации» в областта на трасировката по отношение на UI/UX, изглежда, се ограничават до на допълнителни метаданни в trace, вграждане в тях на информация с висока кардиналност (high-cardinality) или предоставяне на възможност за детайлизиране на конкретни span'и или изпълняване на заявки между и вътре в trace. В същото време traceview остава основното средство за визуализация. Докато подобно положение се запазва, разпределената трасировка ще заема (в най-добрия случай) 4-то място като инструмент за отстраняване на грешки, след метрики, лога и stack trace-ове, а в най-лошия случай — ще се окаже безполезна загуба на пари и време.
Проблемът с traceview
Предназначение traceview е да предоставя пълна картина на движението на определена заявка през всички компоненти на разпределената система, към които тя принадлежи. Някои по-напреднали системи за трасировка позволяват детайлизиране на отделни span'и и преглеждане на разбивка по време вътре на един процес (когато span'ите имат функционални граници).
Основният принцип на архитектурата на микросервисите е, че организационната структура расте заедно с нуждите на компанията. Поддръжниците на микросервисите твърдят, че разпределението на различни бизнес задачи в отделни услуги позволява на малки, независими екипи от разработчици да контролират целия жизнен цикъл на тези услуги, давайки им възможността самостоятелно да създават, тестват и разгръщат тези услуги. Въпреки това, недостатък на подобно разпределение е загубата на информация за това как всяка услуга взаимодейства с другите. В тези условия разпределеното трасируване се явява незаменим инструмент за за отстраняване на неизправности сложни взаимодействия между услугите.
Ако наистина , то никой човек не може да държи в главата си нейния пълен обзор. Всъщност разработването на инструмент с предположението, че това изобщо е възможно, е нещо като антипатерн (неефективен и непродуктивен подход). В идеалния случай за отстраняване на проблеми е необходим инструмент, който да помогне да се стесни зоната на търсене, за да могат инженерите да се фокусират върху подмножество от измервания (услуги/потребители/хостове и т.н.), които са свързани със разглеждания сценарий на проблема. При установяване на причината за провала инженерите не са длъжни да разбират какво се е случвало във всички услуги едновременно, тъй като такова изискване би противоречало именно на концепцията за микросервисна архитектура.
Въпреки това, traceview представлява точно това. Да, някои системи за трасируване предлагат компресирани traceview, когато броят на span-овете в trace е толкова голям, че не могат да бъдат визуализирани в рамките на едно представяне. Въпреки това, поради голямото количество информация, съдържаща се дори в такава съкратена визуализация, инженерите все пак са принудени да "пресяват" информацията, ръчно стеснявайки избора до набор от услуги, източници на проблеми. Уви, на това поле машините значително изпреварват хората, по-малко са подложени на грешки, а резултатите им са по-повторяеми.
Още една причина, поради която смятам, че методът traceview е неправилен, е, че той е лошо пригоден за отстраняване на проблеми на базата на хипотези. По същество отстраняването на проблеми е итеративен процес, който започва с хипотеза, следвана от проверка на различни наблюдения и факти, получени от системата по различни вектори, заключения и по-нататъшна оценка на истинността на хипотезата.
Възможност бързо и евтино тестуването на хипотези и съответното подобряване на умствената модел е основополагащо за отстраняването на проблеми. Всяки инструмент за отстраняване на проблеми трябва да бъде интерактивен и да стеснява пространството на търсене или, в случай на фалшив сигнал, да позволява на потребителя да се върне назад и да се фокусира върху друга област на системата. Идеалният инструмент ще прави това с предвидливост, веднага привличайки вниманието на потребителя към потенциално проблемни области.
За съжаление, traceview не може да бъде наречен инструмент с интерактивен интерфейс. Най-доброто, на което може да се надяваме при неговото използване, е да се открие някакъв източник на повишени забавяния и да се прегледат всички възможни тагове и логове, свързани с него. Това не помага на инженера да установи закономерности в трафика, като специфики на разпределението на забавянията или да открие корелации между различни измервания. може да помогне да се заобиколят някои от тези проблеми. В действителност, за успешен анализ с помощта на машинно обучение за откриване на аномални span'ове и идентифициране на подмножество тагове, които могат да бъдат свързани с аномално поведение. Въпреки това, все още не съм срещал убедителни визуализации на открития, направени с помощта на машинно обучение или анализ на данни, приложени към span'овете, които значително се различават от traceview или DAG (директен ацикличен граф).
Span'овете са твърде нискоуровневи
Основният проблем с traceview е, че span'овете са твърде нискоуровневи примитиви както за анализа на забавянията, така и за анализа на основните причини. Все едно е да анализираме отделни команди на процесора в опит да отстраним изключение, знаейки, че съществуват много по-високоуровневи инструменти като backtrace, с които да работим е много по-удобно.
Освен това, имам смелостта да твърдя следното: в идеалния случай, ние изобщо не се нуждаем от пълна картина което възниква по време на жизнения цикъл на заявката, представяно от съвременните инструменти за трасировка. Вместо това е необходима форма на абстракция от по-високо ниво, съдържаща информация за това какво не е наред (по аналогия с backtrace), заедно с определен контекст. Вместо да наблюдавам целия trace, предпочитам да виждам неговата част, където се случва нещо интересно или необичайно. В момента търсенето се извършва ръчно: инженерът получава trace и самостоятелно анализира span-овете в търсене на нещо интересно. Подходът, при който хората гледат span-ове в отделни trace-ове с надежда да открият подозрителна активност, абсолютно не се мащабира (особено когато им се налага да осмислят всичките метаданни, закодирани в различни span-ове, като span ID, име на метода RPC, продължителност на span-а, логове, тагове и т.н.).
Алтернативи на traceview
Резултатите от трасировката са най-полезни, когато могат да бъдат визуализирани по начин, който предоставя нетривиално представление за това, което се случва в взаимосвързаните части на системата. Дотогава, докато това не бъде постигнато, процесът на отстраняване на грешки остава до голяма степен инертен и зависи от способността на потребителя да забелязва правилните корелации, да проверява правилните части на системата или да събира парчета от мозайката заедно — за разлика от инструмента, което помага на потребителя да формулира тези хипотези.
Не съм визуален дизайнер и не съм експерт в областта на UX, но в следващия раздел бих искал да споделя няколко идеи за това как могат да изглеждат подобни визуализации.
Фокус върху конкретни услуги
В условия, при които индустрията се консолидира около идеи , изглежда разумно, че отделните екипи трябва предимно да следят за съответствието на техните услуги с тези цели. Оттук следва, че визуализацията, ориентирана към услуга , е най-подходяща за такива екипи.
Trace-овете, особено без извадка, са съкровище от информация за всеки компонент на разпределената система. Тази информация може да бъде предоставена на хитър обработчик, който ще доставя на потребителите находки, ориентирани към услуга. Те могат да бъдат идентифицирани предварително — още преди потребителят да разгледа trace-овете:
- Диаграми на разпределение на забавяне само за силно изразяващи се заявки (outlier requests);
- Диаграми на разпределение на забавяне за случаи, когато целите на SLO не са постигнати;
- Най-б „общите“, „интересни“ и „странни“ тагове в заявките, които най-често се повтарят;
- Разпределение на забавянията за случаи, когато зависимости на услугата не достигат поставените SLO цели;
- Разпределение на забавянията по различни подлежащи (downstream) услуги.
На някои от тези въпроси вградени метрики просто не могат да отговорят, принуждавайки потребителите да проучат внимателно span’овете. В крайна сметка, имаме изключително враждебен към потребителя механизъм.
Във връзка с това възниква въпросът: какво ще кажете за комплексните взаимодействия между разнообразни услуги, управлявани от различни екипи? Нали traceview не се счита за най-подходящия инструмент за осветяване на подобна ситуация?
Мобилни разработчици, собственици на stateless услуги, собственици на управлявани stateful услуги (като бази данни) и собственици на платформи могат да се интересуват от друго представление на разпределена система; traceview — това е твърде универсално решение за тези коренно различни нужди. Дори в много сложна микросервисна архитектура, на собствениците на услугата не им трябват дълбоки познания за повече от две-три upstream и downstream услуги. Всъщност, в повечето сценарии на потребителите им е достатъчно да отговарят на въпроси, касаещи ограничен набор от услуги..
Това прилича на разглеждане на малко подмножество услуги през лупа, за да се получи скрупульозно проучване. Това ще позволи на потребителя да задава по-належащи въпроси относно комплексното взаимодействие междур тези услуги и техните непосредствени зависимости. Това е аналогично на backtrace в света на услугите, където инженерът знае, какво не как, а също така има известна представа за случващото се в околните услуги, за да разбере, защо.
Моят подход е пълна противоположност на методологията "отгоре-надолу", основана на traceview, при която анализът започва с цялото трасиране и след това постепенно се спуска до отделни спанове. Напротив, подходът "отдолу-нагоре" започва с анализ на малка част, близка до потенциалната причина за инцидента, а след това обхватът на търсенето се разширява при необходимост (с възможно включване на други екипи за анализ на по-широк спектър от услуги). Вторият подход е по-добре адаптиран за бърза проверка на начални хипотези. След получаване на конкретни резултати, ще можем да преминем към по-целенасочен и детайлен анализ.
Изграждане на топология
Представленията, свързани с конкретна услуга, могат да бъдат изключително полезни, ако потребителят знае, коя услуга или група услуги е отговорна за увеличаването на забавянията или е източник на грешки. Въпреки това, в сложна система определянето на услуга-виновник може да се окаже нетривиална задача по време на проблем, особено ако съобщенията за грешки от услугите не са получени.
Изграждането на топология на услугите може значително да помогне при установяването на това, коя услуга показва рязък скок в честотата на грешките или увеличава забавянето, водещо до забележимо влошаване на работата на услугата. Когато говоря за изграждане на топология, не визирам карта на услугите, отразяваща всяка налична услуга в системата и известна със своите . Тази представа не е по-добра от traceview на базата на насочен ацикличен граф. Вместо това, бих искал да видя динамично генерирана топология на услугите, основана на определени атрибути, като честота на грешки, време за отговор или на всякакъв зададен от потребителя параметър, който помага да се изясни ситуацията с конкретни съмнителни услуги.
Нека да се обърнем към един пример. Да си представим един хипотетичен новинарски сайт. Услугата на началната страница (front page) обменя данни с Redis, с услугата за препоръки, с рекламната услуга и видео услугата. Видео услугата взема видеоклипове от S3, а метаданните — от DynamoDB. Услугата за препоръки получава метаданни от DynamoDB, зарежда данни от Redis и MySQL, изпраща съобщения в Kafka. Рекламният сервиз получава данни от MySQL и изпраща съобщения в Kafka.
По-долу е представено схемно изображение на тази топология (много търговски софтуерни програми изграждат топологии за проследяване). То може да е полезно, ако е необходимо да се разберат зависимостите на услугите. Въпреки това, по време на за отстраняване на неизправности, когато определена услуга (например, видео услугата) показва увеличено време за отговор, подобна топология не е много полезна.
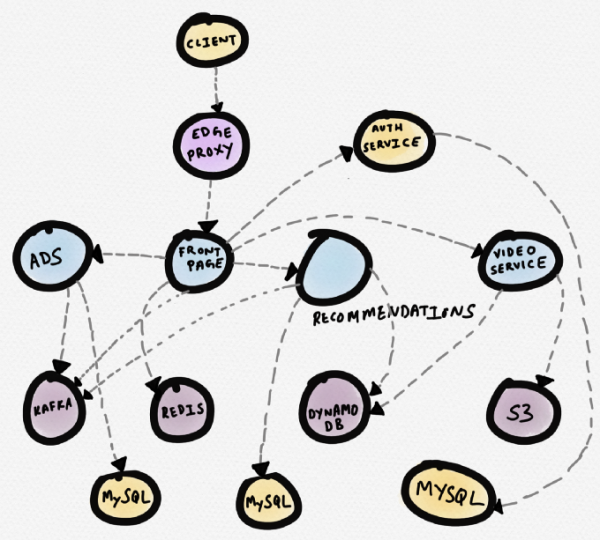
Схема на услугите на хипотетичен новинарски сайт
По-подходяща би била диаграмата, изобразена по-долу. На нея проблемната услуга (video) е изобразена директно в центъра. Потребителят веднага я забелязва. От тази визуализация става ясно, че видео услугата работи аномално поради увеличаване на времето за отговор на S3, което влияе на скоростта на зареждане на част от началната страница.
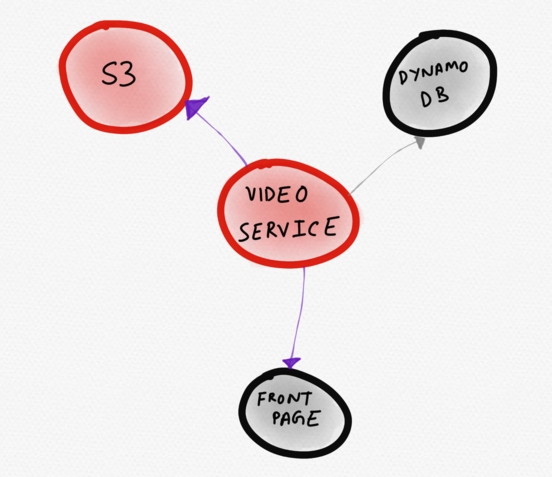
Динамична топология, показваща само "интересните" услуги
Динамично генерираните топологични схеми могат да бъдат по-ефективни от статичните карти на услугите, особено в еластични, автоматично мащабируеми инфраструктури. Възможността да се сравняват и противоставят топологиите на услугите позволява на потребителя да задава по-актуални въпроси. По-точните въпроси за системата с по-голяма вероятност водят до по-добро разбиране на начина, по който системата работи.
Сравнителна визуализация
Още една полезна визуализация би била сравнителната визуализация. В момента трасетата не са особено удобни за сравняване странично, затова обикновено се сравняват span'овете. Основната идея на тази статия е, че span-овете са твърде ниско ниво, за да извлекат най-ценната информация от резултатите от проследяването.
Сравнението на две трасета не изисква принципно нови визуализации. Всъщност е достатъчно нещо като хистограма, представляваща същата информация, която и traceview. Учудващо е, но дори и този прост метод може да донесе много повече ползи, отколкото просто изучаването на две трасета поотделно. Още по-мощно би било възможността визуализиране сравнение на трасетата в съвкупност. Бихме могли да видим как наскоро внедрената промяна в конфигурацията на базата данни, с включен GC (събиране на боклука), влияе на времето за отговор на downstream-сервиса в рамките на няколко часа. Ако това, което описвам тук, изглежда подобно на A/B анализ на влиянието на инфраструктурни промени в множество услуги чрез резултатите от трасировките, не сте прекалено далеч от истината.
Заключение
Не оспорвам полезността на самата трасировка. Искрено вярвам, че няма друг метод да се съберат толкова богати, случаи и контекстуални данни, каквито се съдържат в трасировките. Въпреки това, смятам, че всички решения за трасировка използват тези данни изключително неефективно. Докато инструментите за трасировка продължават да са фокусирани върху представянето на трасировките, те ще бъдат ограничени в способността си да извлекат максималната стойност от информацията, съдържаща се в трасировките. Освен това, съществува риск от допълнителното развитие на изключително нефункционален и неинтуитивен визуален интерфейс, който значително ще ограничи способността на потребителя да отстранява проблеми в приложението.
Отстраняването на проблеми в сложни системи, дори с помощта на най-новите инструменти, е невероятно трудно. Инструментите трябва да помагат на разработчика да формулира и проверява хипотези, активно предоставяйки релевантна информация, идентифицирайки аномалии и отбелязвайки особености в разпределението на закъсненията. За да стане трасировката предпочитан инструмент на разработчиците при отстраняване на проблеми в продукция или решаване на проблеми, обхващащи различни услуги, са необходими оригинални потребителски интерфейси и визуализации, които в значителна степен съответстват на менталната модел на разработчиците, които създават и експлоатират тези услуги.
Ще са необходими сериозни умствени усилия, за да се проектира система, която ще представя различните сигнали, достъпни в резултатите от трасировките, по начин, оптимизиран за улесняване на анализа и изводите. Необходимо е да се помисли как да се абстрахира топологията на системата по време на отстраняване на проблеми, така че да помогне на потребителя да преодолее слепите зони, без да разглежда отделни трасировки или обхвати.
Нужни са ни добри възможности за абстракция и разделяне на нива (особено в потребителския интерфейс). Такива, които добре се вписват в процеса на отстраняване на грешки, основан на хипотези, където може итеративно да поставяме въпроси и да проверяваме хипотезите. Те няма да решат автоматично всичките проблеми с наблюдаемостта, но ще помагат на потребителите да усъвършенстват интуицията си и да формулират по-внимателни въпроси. Призовавам за по-разумен и иновативен подход в областта на визуализацията. Тук има реална перспектива за разширяване на хоризонтите.
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
