

CAP-теоремата е основополагающият камък на теорията на разпределените системи. Разбира се, дебатите около нея не утихват: определенията в нея не са канонически, а и строго доказателство липсва… Въпреки това, твърдо стоейки на позициите на общия здрав разум™, интуитивно разбираме, че теоремата е вярна.
Единственото нещо, което не е очевидно, е значението на буквата „P“. Когато клъстерът се раздели, той решава – да не отговаря, дока до не се набере кворум, или да предостави данните, които има. В зависимост от резултатите от този избор, системата се класифицира или като CP, или като AP. Например, Cassandra може да се държи по два начина, в зависимост не само от настройките на клъстера, а и от параметрите на конкретната заявка. Но ако системата не е „P“, и се е разделила, тогава – какво?
Отговорът на този въпрос е донякъде неочакван: CA-клъстер не може да се раздели.
Какъв е този клъстер, който не може да се раздели?
Непременното условие за такъв клъстер е обща система за съхранение на данни. В преобладаващата част от случаите това означава свързване чрез SAN, което ограничава применението на CA-решенията до големи предприятия, способни да поддържат SAN инфраструктура. За да могат няколко сървъри да работят с едни и същи данни, необходима е клъстерна файлова система. Такива файлови системи са налични в портфейлите на HPE (CFS), Veritas (VxCFS) и IBM (GPFS).
Oracle RAC
Опцията Real Application Cluster за първи път се появи през 2001 година с изданието Oracle 9i. В такъв клъстер няколко инстанции сървър работят с една и съща база данни.
Oracle може да работи както с клъстерна файлова система, така и с собственото си решение – ASM, Automatic Storage Management.
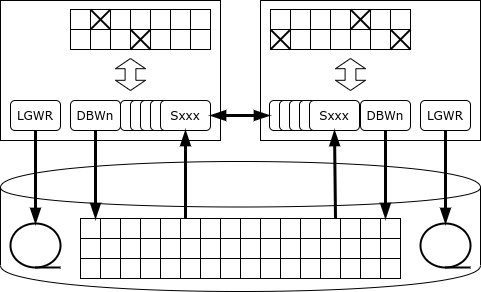
Всяка инстанция води свой журнал. Транзакцията се изпълнява и записва от една инстанция. В случай на неуспех на инстанцията, един от оцелелите възли на клъстера (инстанциите) прочита нейния журнал и възстановява загубените данни – по този начин се осигурява наличност.
Всички инстанции поддържат собствен кеш, и едни и същи страници (блокове) могат да бъдат едновременно в кешовете на няколко инстанции. Освен това, ако някоя страница е необходима на една инстанция и е в кеша на друга инстанция, тя може да я получи от „съседа“ чрез механизма cache fusion, вместо да чете от диска.
Но какво ще се случи, ако на един от екземплярите му трябва да промени данни?
Характеристика на Oracle е, че няма отделна услуга за заключване: ако сървърът иска да заключи ред, записът за заключването се поставя директно на страницата в паметта, където се намира заключеният ред. Благодарение на този подход, Oracle е шампион по производителност сред монолитни бази: услугата за заключване никога не става тесен поток. Но в клъстерна конфигурация такава архитектура може да доведе до интензивен мрежов обмен и взаимни блокировки.
Когато записът бъде заключен, екземплярът уведомява всички останали екземпляри, че страницата, на която се съхранява този запис, е взета в монополен режим. Ако на друг екземпляр му е необходимо да промени записа на същата страница, той трябва да изчака, докато промените на страницата не бъдат фиксирани, т.е. информацията за промяната не бъде записана в журнала на диска (като по време на това транзакцията може да продължава). Може да се случи така, че страницата да бъде променяна последователно от няколко екземпляра, и тогава при записването на страницата на диска ще трябва да се установи, при кого точно се съхранява актуалната версия на тази страница.
Случайно обновление на едни и същи страници през различни възли на RAC води до рязко намаляване на производителността на базата данни – до такава степен, че производителността на клъстера може да бъде по-ниска, отколкото производителността на единствен екземпляр.
Правилната употреба на Oracle RAC е физическо разделение на данни (например, с помощта на механизма на секционирани таблици) и достъп до всяка група секции през отделен възел. Главното предназначение на RAC стана не хоризонталното мащабиране, а осигуряването на отказоустойчивост.
Ако възелът спре да отговаря на heartbeat, то онзи възел, който първи го установи, стартира процедурата за гласуване на диска. Ако и тук отсъстващият възел не се запише, то един от възлите поема отговорностите за възстановяване на данни:
- «замразява» всички страници, които са били в кеша на отсъстващия възел;
- чете журналите (redo) на отсъстващия възел и повторно прилага промените, записани в тези журнали, като проверява дали други възли имат по-нови версии на променяните страници.
- откатыва незавършени транзакции.
За да опрости превключването между възлите, Oracle има концепцията за услуга – виртуален екземпляр. Един екземпляр може да обслужва няколко услуги, а услуга може да се премества между възлите. Приложен екземпляр, който обслужва конкретна част от базата данни (например, група клиенти), работи с една услуга, а услугата, отговаряща за тази част от базата, при извънредна ситуация на възел, се премества на друг възел.
IBM Pure Data Systems for Transactions
Клъстерното решение за СУБД навлезе в портфейла на Голямата Синя Компания през 2009 година. Идеологически то е наследник на клъстера Parallel Sysplex, построен на 'обикновено' оборудване. През 2009 година беше представен продуктът DB2 pureScale, който представлява комплект софтуер, а през 2012 година IBM предлага софтуерно-апаратен комплект (appliance) под името Pure Data Systems for Transactions. Не бива да се бърка с Pure Data Systems for Analytics, което е просто преименуван Netezza.
Архитектурата pureScale на пръв поглед прилича на Oracle RAC: също така, няколко възла са свързани към обща система за съхранение на данни, и на всеки възел работи свой екземпляр на СУБД със свои области на памет и журнални файлове. Но, в контекста на DB2, в отличие от Oracle, съществува специализирана услуга за заключвания, представена от набор от процеси db2LLM*. В клъстерната конфигурация тази услуга се изнася на отделен възел, който в Parallel Sysplex се нарича coupling facility (CF), а в Pure Data – PowerHA.
PowerHA предлага следните услуги:
- мениджър на заключвания;
- глобален буферен кеш;
- област за междупроцесни комуникации.
За предаване на данни от PowerHA към възлите на БД и обратно се използва дистанционен достъп до памет, затова клъстерният интерконект трябва да поддържа протокола RDMA. PureScale може да използва както Infiniband, така и RDMA over Ethernet.
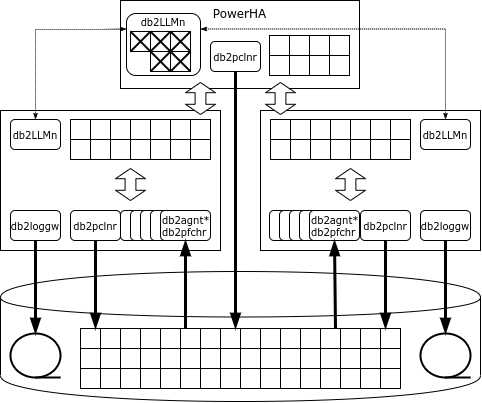
Ако на възела му е необходима страница и тази страница не е в кеша, той я запитва в глобалния кеш, и само ако и там я няма, я чете от диска. За разлика от Oracle, запитването отива само към PowerHA, а не към съседните възли.
Ако екземпляр ще променя ред, той блокира променливата в ексклузивен режим, а страницата, където се намира реда, – в споделен режим. Всички блокировки се регистрират в глобалния мениджър на блокировките. Когато транзакцията приключи, възелът изпраща съобщение до мениджъра на блокировките, който копира променената страница в глобалния кеш, сваля блокировките и инвалидира променената страница в кешовете на другите възли.
Ако страницата, в която се намира изменяемият ред, вече е блокирана, мениджърът на блокировките ще прочете променената страница от паметта на възела, който е направил промените, ще свали блокировката, ще инвалида променената страница в кешовете на другите възли и ще предостави блокировката на страницата на възела, който я е поискал.
„Мръсните“, тоест променени, страници могат да бъдат записвани на диск както от обикновен възел, така и от PowerHA (castout).
При отказ на един от възлите pureScale възстановяването е ограничено само до онези транзакции, които в момента на сбоя все още не са завършени: страниците, променени от този възел в приключилите транзакции, се намират в глобалния кеш на PowerHA. Възелът рестартира на ограничена конфигурация на един от сървърите в клъстера, отменя незавършените транзакции и освобождава блокировките.
PowerHA работи на два сървъра, а основният възел синхронно репликира своето състояние. При отказ на основния възел PowerHA клъстерът продължава работа с резервния възел.
Разбира се, ако се обръщате към набор от данни през един възел, общата производителност на клъстера ще бъде по-висока. PureScale дори може да забележи, че определена зона от данни се обработва от един възел, и тогава всички блокировки, свързани с тази зона, ще се обработват локално от възела без комуникации с PowerHA. Но веднага щом приложението се опита да се обърне към тези данни през друг възел, централизираното обработване на блокировките ще бъде възобновено.
Вътрешните тестове на IBM при натоварване, състоящо се от 90% четене и 10% запис, което е много близо до реално индустриално натоварване, показват почти линейно мащабиране до 128 възли. Условията на тестовете, за съжаление, не са разкрити.
HPE NonStop SQL
В портфолиото на Hewlett-Packard Enterprise съществува и своя платформа с висока наличност. Това е платформа NonStop, пусната на пазара през 1976 година от компания Tandem Computers. През 1997 година компанията беше придобита от Compaq, който, от своя страна, през 2002 година се сля в Hewlett-Packard.
NonStop се използва за изграждане на критични приложения – например, HLR или обработка на банкови карти. Платформата се предоставя под формата на софтуерно-апаратен комплекс (appliance), включващ изчислителни възли, система за съхранение на данни и комуникационно оборудване. Мрежата ServerNet (в съвременните системи – Infiniband) служи както за обмен между възлите, така и за достъп до системата за съхранение на данни.
В ранните версии на системата се използваха собственически процесори, които бяха синхронизирани един с друг: всички операции се изпълняваха синхронно от няколко процесора, и когато един от процесорите се провалеше, той се изключваше, а вторият продължаваше да работи. По-късно системата премина на обикновени процесори (първоначално MIPS, след това Itanium и накрая x86), а за синхронизацията бяха използвани други механизми:
- съобщения: всеки системен процес има двойник-„свят”, на който активният процес периодично изпраща съобщения за своето състояние; при сбой на основния процес, тендовия процес започва работа от момента, определен от последното съобщение;
- гласуване: системата за съхранение на данни разполага с специален хардуерен компонент, който приема няколко идентични заявки и ги изпълнява само в случай, че заявките съвпадат; вместо физическа синхронизация, процесорите работят асинхронно, а резултатите от тяхната работа се сравняват само в моментите на вход/изход.
От 1987 година на платформата NonStop функционира релационна СУБД – първо SQL/MP, а по-късно – SQL/MX.
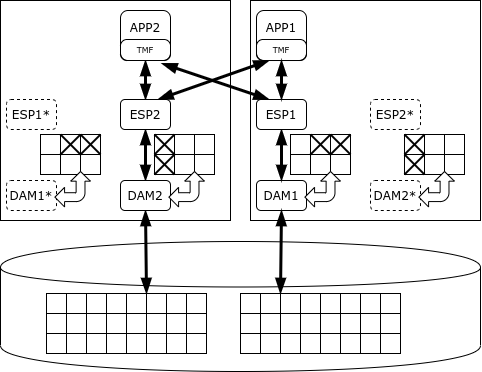
Цялата база данни се дели на части, като всяка част е отговорност на свой процес Data Access Manager (DAM). Той осигурява запис на данни, кеширане и механизъм за блокиране. Обработката на данни се извършва от изпълнителни процеси (Executor Server Process), работещи на същите възли, на които се намират съответните мениджъри на данни. Планиращият SQL/MX разпределя задачите между изпълнителите и комбинира резултатите. При необходимост от съгласувани промени се използва протоколът на двуфазно ангажиране, осигурен от библиотеката TMF (Transaction Management Facility).
NonStop SQL може да приоритизира процесите така, че дългите аналитични запитвания да не пречат на изпълнението на транзакции. Въпреки това, основната ѝ цел е именно обработката на кратки транзакции, а не аналитика. Разработчикът гарантира наличността на кластера NonStop на ниво пет 'деветки', което означава, че просто се състои само в 5 минути годишно.
SAP HANA
Първият стабилен релиз на СУБД HANA (1.0) се състоя през ноември 2010 година, а пакетът SAP ERP премина на HANA от май 2013 година. Платформата се основава на закупени технологии: TREX Search Engine (търсене в колонковото хранилище), СУБД P*TIME и MAX DB.
Самото наименование „HANA“ е акроним, означаващ High performance ANalytical Appliance. Тази СУБД се предлага под формата на код, който може да работи на всякакви сървъри x86, но индустриалните инсталации са разрешени само на оборудване, което е преминало сертификация. Налице са решения от HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi и NEC. Някои конфигурации на Lenovo дори позволяват експлоатация без SAN – ролята на обща СХД играе клъстер GPFS на локални дискове.
В отличие от изброените платформи, HANA е СУБД в паметта, т.е. основният образ на данните се съхранява в оперативната памет, а на диска се записват само журнали и периодични снимки – за възстановяване в случай на авария.
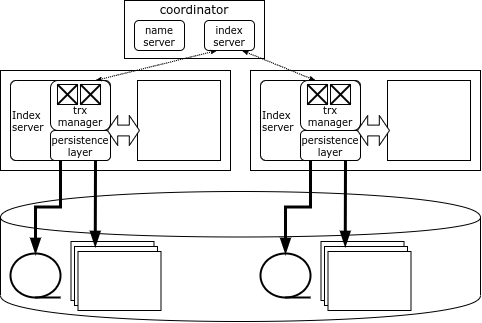
Всеки възел на кластера HANA отговаря за своята част от данните, а картата на данните се съхранява в специален компонент – Name Server, разположен на координаторния възел. Данните между възлите не се дублират. Информацията за блокировките също се съхранява на всеки възел, но в системата има глобален детектор на взаимни блокировки.
Клиент HANA при свързване с кластера зарежда неговата топология и след това може да се обръща директно към всяки възел в зависимост от нужните данни. Ако транзакцията засяга данни на единствен възел, тя може да бъде изпълнена локално от този възел, но ако се променят данни от няколко възли, възел-инициатор се обръща към координатор, който отваря и координира разпределената транзакция, фиксирайки я чрез оптимизиран протокол за двуфазно фиксиране.
Възел-координатор е дублиран, така че в случай на повреда на координатора резервният възел веднага поема работата. А ако възелът с данните е повреден, единственият начин за достъп до неговите данни е да се рестартира възелът. По правило в HANA клъстерве се държи резервен (spare) сървър, за да може възможно най-бързо да се рестартира изгубеният възел.
Източник: habr.com
