

Защо е нужно да правите резервни копия? Въпреки че оборудването е изключително надеждно и съществуват „облаци“, които в много отношения са по-добри от физическите сървъри: при правилна настройка „облачният“ сървър лесно ще издържи на отказа на инфраструктурния физически сървър, а от гледна точка на потребителите ще има малко, едва забележимо увеличение на времето за обслужване. Освен това дублирането на информация често изисква заплащане на „излишно“ процесорно време, натоварване на диска и мрежов трафик.
Идеалната програма работи бързо, не изтича от оперативната памет, няма дупки и не съществува.
—Неизвестен
Тъй като програмите все още се пишат от разработчици, а процесът на тестване често отсъства, плюс доставката на програми много рядко се случва с използване на „добри практики“ (които самите по себе си също са програми и следователно не са съвършени), системните администратори често трябва да решават задачи, които звучат кратко, но същевременно натоварено: „да се върне, както беше“, „да се приведат данните в нормална работа“, „работи бавно — възвръщаме“, а също и моят любим „не знам какво, но да го поправим“.
Освен логическите грешки, които се появяват в резултат на небрежната работа на разработчиците или стечението на обстоятелствата, а също и непълното познание или неразбиране на малките особености при изграждането на програми — включително свързващи и системни, включително операционни системи, драйвери и фърмуер — съществуват и други грешки. Например, повечето разработчици разчитат на рантайм, напълно забравяйки за физическите закони, които все още не могат да бъдат заобиколени чрез програми. Това включва безкрайната надеждност на дисковата подсистема и всяка подсистема за съхранение на данни (включително оперативна памет и кеш на процесора!), нулево време за обработка на процесора, отсъствие на грешки при предаване по мрежата и при обработка на процесора, и забавяния в мрежата, равни на 0. Не бива да пренебрегвате и известния дедлайн, защото ако не успеете да се вместите в него — ще има проблеми, по-неприятни от нюансите в работата на мрежата и диска.
Как да се справим с проблемите, които изникват и заплашват ценните данни? Няма как да заменим живите разработчици, а и не е сигурно, че това ще е възможно в близко бъдеще. От друга страна, досега само няколко проекта са успели да докажат, че програмата ще работи както е замислено, и е напълно възможно доказателствата да не могат да бъдат приложени към други, подобни проекти. Освен това, подобни доказателства отнемат много време и изискват специални умения и знания, което практически минимализира възможността за тяхното прилагане с оглед на краен срок. Освен това, все още не умеем да създаваме свръхбързи, евтини и безкрайно надеждни технологии за съхранение, обработка и предаване на информация. Подобни технологии, ако изобщо съществуват, са по-скоро концепции или — по-често — само в научно-фантастични книги и филми.
Добри художници копират, велики художници крадат.
—Пабло Пикасо.
Най-добрите решения и удивително прости неща обикновено се случват там, където се срещат абсолютно несъвместими на пръв поглед понятия, технологии, знания и области на науката.
Например, птиците и самолетите имат крила, но въпреки функционалната им сходство — принципът на действие в някои режими съвпада, и техническите проблеми се решават по аналогичен начин: кухи кокали, използване на здрави и леки материали и т.н., — резултатите са напълно различни, макар и много сходни. Най-добрите образци, които наблюдаваме в нашата техника, също предимно са заимствани от природата: херметични отделения на кораби и подводници — пряка аналогия с кольчатите червеи; построяване на raid-масиви и проверка на целостта на данните — дублиране на веригата ДНК; а също и двойни органи, независимост на работата на различни органи от ЦНС (автоматизация на работата на сърцето) и рефлекси — автономни системи в интернет. Разбира се, взимането и прилагането на готови решения „в лоб“ е опасно, но кой знае, може би други решения просто не съществуват.
Ако знаеше, къде ще паднеш — щеше да си постелеш сламки!
—Белоруска народна пословица
Следователно, резервните копия са жизненоважни за тези, които желаят:
- Да имат възможност да възстановят работата на системите си с минимални прекъсвания или дори без тях.
- Действайте смело, защото в случай на грешка винаги има възможност за възстановяване.
- Минимизирайте последствията от умишлено повреждане на данни.
Тук — малко теоретични основи.
Всяка класификация е произволна. Природата не класифицира. Класифицираме ние, защото така е по-удобно за нас. И класифицираме въз основа на данни, които също взимаме произволно.
— Жан Брюлер
Независимо от физическия начин на съхранение, логичното съхранение на данни може условно да се раздели на два начина за достъп до тези данни: блочно и файлово. Такова разделение напоследък е много размито, тъй като чисто блочни, както и чисто файлови, логически хранилища не съществуват. Все пак, за улеснение, ще приемем, че те са налице.
Блочното съхранение на данни предполага, че има физическо устройство, където данните се записват в определени фиксирани порции, блокове. Достъпът до блоковете става по определен адрес, като на всеки блок съответства свой адрес в рамките на устройството.
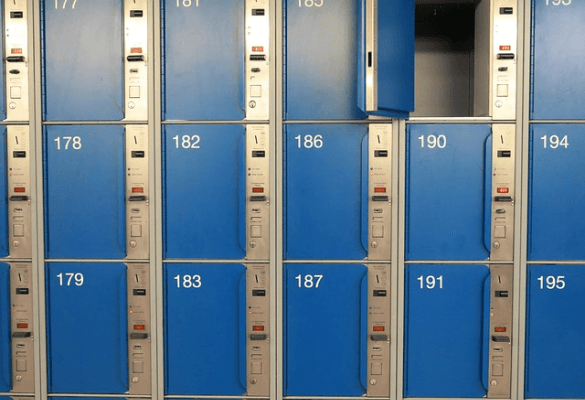
Резервното копие обикновено се прави чрез копиране на блокове данни. За да се осигури целостта на данните в момента на копирането, записването на нови блокове и промяната на съществуващите се спира. Ако вземем аналогия от обикновеното свят — това е най-близо до шкаф с еднакво номерирани клетки.
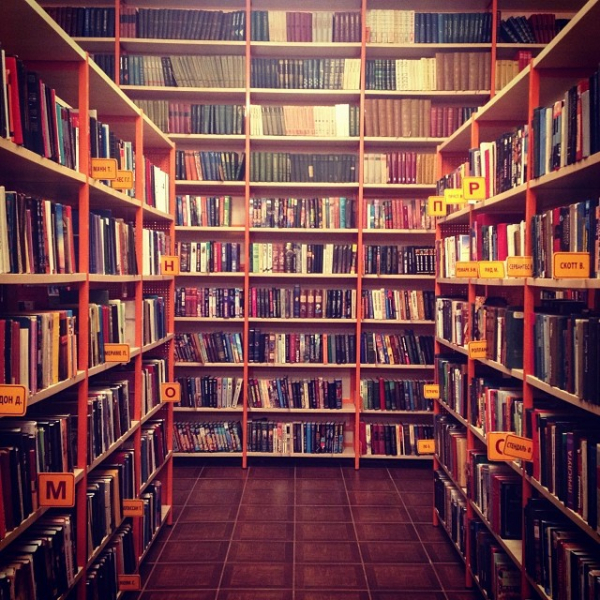
Файловото съхранение на данни по принцип е близко до блочното и често се организира отгоре. Важни различия са наличието на йерархия на съхранение и разбираеми за хората имена. Извежда се абстракция под формата на файл — именувана област от данни, а също така и каталог — специален файл, в който се съхраняват описания и достъпи до други файлове. Файловете могат да бъдат снабдени с допълнителни метаданни: време на създаване, достъпни флагове и т.н. Резервирането обикновено става по следния начин: търсят се променени файлове, след което те се копират в друга, структурно идентична файлово хранилище. Целостта на данните обикновено се реализира чрез отсъствие на файлове, в които се извършва запис. Метаданните на файловете се резервират аналогично. Най-близката аналогия е библиотека, където има секции с различни книги, както и каталог с разбираеми за хората имена на книги.
В последно време понякога описват и един вариант, с който всъщност започна съхранението на файлове, и който има същите архаични черти: обектно съхранение на данни.
От файловото съхранение се различава с това, че няма вложеност повече от едно ниво (плоска схема), а името на файловете, макар и четимо за човек, е по-скоро пригодено за обработка от машини. При резервирането обектните хранилища най-често се обработват като файловите, но понякога има и други варианти.
— Има два вида системни администратори: тези, които не правят резервни копия, и тези, които ВЕЧЕ правят.
— Всъщност има три вида: има и такива, които проверяват дали резервните копия могат да бъдат възстановени.—Неизвестен
Също така е важно да се разбере, че самият процес на резервиране на данни се осъществява от програми, така че той носи всички същите недостатъци, както и друга програма. За да се премахне (не да се изключи!) зависимостта от човешкия фактор, а също и особеностите — които поотделно не оказват значително влияние, но заедно могат да донесат осезаем ефект, се прилага т.н. правило 3-2-1. Има много варианти, как да се разчете, но на мен ми харесва следната трактовка: трябва да се съхраняват 3 комплекта от същите данни, 2 комплекта трябва да се съхраняват в различни формати, а също така 1 комплект трябва да бъде на географски отдалечено хранилище.
Под формата на съхранение следва да се разбира следното:
- Ако има зависимост от физическия начин на съхранение — променяме физическия начин.
- Ако има зависимост от логическия начин на съхранение — променяме логическия начин.
За постигане на максимален ефект от правилото 3-2-1 се препоръчва смяна на формата на съхранение и по двата начина.
От гледна точка на готовността на резервното копие за неговата основна цел — възстановяване на работоспособността, — се различават «горещи» и «студени» резервни копия. Горещите от студените се различават само с едно: те са готови за работа веднага, докато студените изискват допълнителни действия за възстановяване: разшифроване, извличане от архив и т.н.
Не трябва да се бъркат горещите и студените копия с онлайн и офлайн копия, които означават физическа изолация на данните и по същество представляват друг признак на класификация на методите за резервно копиране. Така офлайн копия — не свързана директно със системата, където трябва да се възстанови, — може да бъде както гореща, така и студена (с оглед на готовността за възстановяване). Онлайн копията може да бъде достъпна директно там, където трябва да се възстанови, и най-често е гореща, но може да съществуват и студени копия.
Освен това, не трябва да се забравя, че самият процес на създаване на резервни копия обикновено не приключва с направата на едно резервно копие, а копията могат да бъдат в значителен брой. Следователно, е необходимо да се различават пълни резервни копия, т.е. тези, които могат да се възстановяват независимо от другите резервни копия, а също и разностни (инкрементални, диференциални, декрементални и др.) копия — тези, които не могат да бъдат възстановени самостоятелно и изискват предварително възстановяване на едно или повече други резервни копия.
Разностни инкрементални копия — опит за спестяване на размер на хранилището за резервни копия. По този начин в резервното копие се записват само променените данни от последното резервно копие.
Разностни декрементални се създават с същата цел, но по малко различен начин: прави се пълно резервно копие, но реално се съхранява само разликата между новата копия и предишната.
Отделно е важно да се разгледа процесът на резервно копиране над хранилище, което поддържа отсъствие на дубликати. По този начин, ако се пишат пълни резервни копия върху него, реално ще бъде записана само разликата между резервните копия, но процесът на възстановяване на резервни копия ще протича аналогично на възстановяването от пълна копия и напълно прозрачно.
Quis custodiet ipsos custodes?
(Кой ще пази самите стражи? — лат.)
Изключително неприятно е, когато няма резервни копия, но е още по-лошо, ако резервното копие изглежда направено, но при възстановяването се оказва, че не може да бъде възстановено, защото:
- Целостта на изходните данни е нарушена.
- Хранилището с резервните копия е повредено.
- Възстановяването работи доста бавно, не могат да се използват данни, които са частично възстановени.
Правилно изграденият процес на архивиране трябва да вземе предвид подобни забележки, особено първите две.
Целостта на оригиналните данни може да бъде гарантирана по няколко начина. Най-често се използват следните: а) създаване на снимки на файловата система на блочно ниво, б) "замразяване" на състоянието на файловата система, в) специално блочно устройство за съхранение на версии, г) последователно записване на файлове или блокове. Също така се използват контролни суми за осигуряване на проверка на данните при възстановяване.
Поврежданията на хранилището също могат да бъдат открити с помощта на контролни суми. Допълнителен метод е използването на специализирани устройства или файлови системи, в които е невъзможно да се променят вече записаните данни, но е възможно да се добавят нови.
За ускоряване на възстановяването се използва възстановяване на данни с множество процеси за възстановяване — при условие че няма "бутилочно гърло" в лицето на бавна мрежа или бавна дискова система. За да се заобиколи ситуацията с частично възстановени данни, може да се раздели процесът на архивиране на относително малки подзадачи, всяка от които се изпълнява поотделно. Така се създава възможност последователно да се възстанови работоспособността с прогноза за времето за възстановяване. Този проблем най-често е в организационната сфера (SLA), затова няма да се спираме на него подробно.
Разбира нещо в подправките не е този, който ги добавя във всяко ястие, а този, който никога не добавя нищо излишно.
—В. Синявски
Практиката при използваното софтуерно осигуряване от системните администратори може да варира, но общите принципи все пак остават едни и същи, по-конкретно:
- Настоятелно се препоръчва да се прилагат готови решения.
- Програмите трябва да работят предсказуемо, т.е. не трябва да има недокументирани особености или тесни места.
- Настройката на всяка програма трябва да е толкова проста, че да не се налага всеки път да се чете ръководство или бележка.
- Решението трябва да бъде универсално, тъй като сървърите могат да се различават значително по своите хардуерни характеристики.
За създаване на резервни копия от блочни устройства са налични следните разпространени програми:
- dd, позната на ветераните в системното администриране, също влизат подобни програми (например, dd_rescue).
- Вградени в някои файлови системи обслужващи програми (утилити), които създават копие (dump) на файловата система.
- Всеобхватни утилити; например, partclone.
- Собствени, често собственически, решения; например, NortonGhost и по-късни версии.
За файловите системи задачата за резервно копиране частично се решава с помощта на методи, приложими за блочни устройства, но задачата може да бъде решена и по-ефективно, използвайки, например:
- Rsync, универсална програма и протокол за синхронизиране на състоянието на файловите системи.
- Вградени средства за архивиране (ZFS).
- Външни средства за архивиране; най-популярният представител е tar. Има и други, например, dar — заместител на tar, насочен към съвременни системи.
Отделно трябва да се споменат софтуерни средства за осигуряване на консистентност на данните при създаване на резервни копия. Често се използват следните варианти:
- Монтиране на файловата система в режим само за четене (ReadOnly) или замразяване на файловата система (freeze) — методът е приложим ограничено.
- Създаване на копия на състоянието на файловата система или блочно устройство (LVM, ZFS).
- Използване на външни средства за организиране на копия, дори в случаите, когато предишните точки не могат да бъдат осигурени по някакви причини (програми от типа hotcopy).
- Техника за копиране при изменение (CopyOnWrite), обаче тя най-често е свързана с използваната файловата система (BTRFS, ZFS).
И така, за малък сървър трябва да се осигури схема за резервно копиране, която да отговаря на следните изисквания:
- Лесна за работа — не изисква специални допълнителни действия при работа, минимални действия за създаване и възстановяване на копия.
- Универсална — работи както на големи, така и на малки сървъри; това е важно при увеличаване на броя сървъри или мащабиране.
- Инсталира се чрез пакетен мениджър или с една-две команди от типа „изтегли и разопакова“.
- Стабилна — използва стандартен или отдавна установен формат за съхранение.
- Бърза в работа.
Кандидати, които в някаква степен отговарят на изискванията:
- rdiff-backup
- rsnapshot
- burp
- duplicati
- duplicity
- deja dup
- dar
- zbackup
- restic
- borgbackup
Като тестова платформа ще се използва виртуална машина (на базата на XenServer) със следните характеристики:
- 4 ядра 2.5 GHz,
- 16 GB оперативна памет,
- 50 GB хибридно хранилище (СХД с кеширане на SSD в размер на 20% от размера на виртуалния диск) под формата на отделен виртуален диск без разделяне,
- 200 Mbit/s канал в Интернет.
Като сервер-приемник на резервни копия ще се използва практически същата машина, само с твърд диск от 500 GB.
Операционна система — Centos 7 x64: стандартно разпределение, допълнителният дял ще се използва като източник на данни.
Като източник на данни ще вземем сайт на wordpress, с медийни файлове с размер 40 GB и база данни на mysql. Тъй като виртуални сървъри значително се различават по характеристики, а също и за по-добра възпроизводимост, тук има
резултати от тестването на сървъра с помощта на sysbench.sysbench —threads=4 —time=30 —cpu-max-prime=20000 cpu run
sysbench 1.1.0-18a9f86 (използвайки вграден LuaJIT 2.1.0-beta3)
Изпълнява теста с следните опции:
Брой нишки: 4
Инициализация на генератора на случайни числа от текущото време
Граница на простите числа: 20000
Инициализиране на работни нишки…
Нишките започнаха!
Скорост на CPU:
събития в секунда: 836.69
Пропускателна способност:
събития/s (eps): 836.6908
преминало време: 30.0039s
общ брой събития: 25104
Забавяне (ms):
мин: 2.38
средно: 4.78
макс: 22.39
95-ти процентил: 10.46
сума: 119923.64
Справедливост на нишките:
събития (средно/стандартно отклонение): 6276.0000/13.91
време за изпълнение (средно/стандартно отклонение): 29.9809/0.01
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=read memory run
sysbench 1.1.0-18a9f86 (използвайки вграден LuaJIT 2.1.0-beta3)
Изпълнява теста с следните опции:
Брой нишки: 4
Инициализация на генератора на случайни числа от текущото време
Изпълняване на тест за скорост на паметта с следните опции:
размер на блока: 1KiB
общ размер: 102400MiB
операция: четене
обхват: глобален
Инициализиране на работни нишки…
Нишките започнаха!
Общ брой операции: 50900446 (1696677.10 в секунда)
49707.47 MiB прехвърлени (1656.91 MiB/s)
Пропускателна способност:
събития/s (eps): 1696677.1017
преминало време: 30.0001s
общ брой събития: 50900446
Забавяне (ms):
мин: 0.00
средно: 0.00
макс: 24.01
95-ти процентил: 0.00
сума: 39106.74
Справедливост на нишките:
събития (средно/стандартно отклонение): 12725111.5000/137775.15
време за изпълнение (средно/стандартно отклонение): 9.7767/0.10
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=write memory run
sysbench 1.1.0-18a9f86 (използвайки вграден LuaJIT 2.1.0-beta3)
Изпълнява теста с следните опции:
Брой нишки: 4
Инициализация на генератора на случайни числа от текущото време
Изпълняване на тест за скорост на паметта с следните опции:
размер на блока: 1KiB
общ размер: 102400MiB
операция: запис
обхват: глобален
Инициализиране на работни нишки…
Нишките започнаха!
Общ брой операции: 35910413 (1197008.62 в секунда)
35068.76 MiB прехвърлени (1168.95 MiB/s)
Пропускателна способност:
събития/s (eps): 1197008.6179
преминало време: 30.0001s
общ брой събития: 35910413
Забавяне (ms):
мин: 0.00
средно: 0.00
макс: 16.90
95-ти процентил: 0.00
сума: 43604.83
Справедливост на нишките:
събития (средно/стандартно отклонение): 8977603.2500/233905.84
време за изпълнение (средно/стандартно отклонение): 10.9012/0.41
sysbench —threads=4 —file-test-mode=rndrw —time=60 —file-block-size=4K —file-total-size=1G fileio run
sysbench 1.1.0-18a9f86 (използвайки вграден LuaJIT 2.1.0-beta3)
Изпълнява теста с следните опции:
Брой нишки: 4
Инициализация на генератора на случайни числа от текущото време
Допълнителни флагове за отваряне на файл: (няма)
128 файла, по 8MiB всеки
Общ размер на файла 1GiB
Размер на блока 4KiB
Брой IO заявки: 0
Съотношение четене/писане за комбиниран тест за случаен IO: 1.50
Периодичен FSYNC активиран, извикваща fsync() на всеки 100 заявки.
Извикване на fsync() в края на теста, Активирано.
Използвайки синхронен I/O режим
Извършване на тест за случайно r/w
Инициализиране на работни нишки…
Нишките започнаха!
Пропускателна способност:
четене: IOPS=3868.21 15.11 MiB/s (15.84 MB/s)
писане: IOPS=2578.83 10.07 MiB/s (10.56 MB/s)
fsync: IOPS=8226.98
Забавяне (ms):
мин: 0.00
средно: 0.27
макс: 18.01
95-ти процентил: 1.08
сума: 238469.45
С тази бележка започва поредица
от статии за резервно копиране
- Резервно копиране, част 1: Защо е необходимо резервното копиране, преглед на методите и технологиите
- Архивиране, част 2: Преглед и тестване на инструменти за архивиране на базата на rsync
- Архивиране, част 3: Преглед и тестване на duplicity, duplicaty, deja dup
- Резервно копие, част 4: Преглед и тестване на zbackup, restic, borgbackup
- Резервно копиране, част 5: Тестване на bacula и veeam backup for linux
- Резервно копиране, част 6: Сравнение на инструменти за резервно копиране
- Резервно копиране, част 7: Изводи
Източник: habr.com
