

Според , data engineer в момента е професия, чийто интерес нараства по-бързо от всички останали. Data engineer играе критично важна роля в организациите – той създава и поддържа активни пайплайни и бази данни, които се използват за обработка, трансформация и съхранение на данни. Какви умения са необходими на специалистите в тази професия на първо място? Различава ли се списъкът от този, който се изисква от data scientists? Всичко това ще научите от моята статия.
Анализирах обявите за работа за позицията data engineer в такава форма, каквато са през януари 2020 година, за да разбера кои умения в областта на технологиите са най-търсени. След това сравних получените резултати с статистиката за обяви за позиции data scientist – това разкри интересни различия.
Няма нужда от дълги предисловия – ето десетте най-популярни технологии, които най-често се споменават в текстовете на обяви за работа:
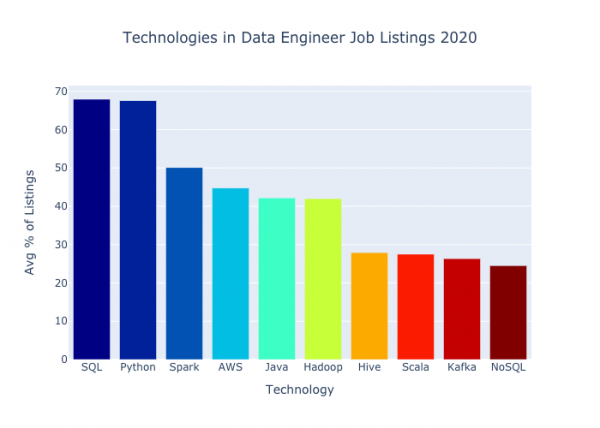
Упоминания за технологии в обявите за позицията data engineer през 2020 година
Нека разберем.
Задължения на data engineer
Към днешна дата работата, която изпълняват data engineers, има огромно значение за организациите – именно тези хора отговарят за съхраняването на информация и я подготвят да бъде използвана от други служители. Data engineers изграждат пайплайни, за да установят потока на данни или партиди от множество източници. След това пайплайните извършват операции по извличане, трансформация и зареждане (иначе казано, ETL процеси), което прави данните по-подходящи за последваща употреба. След това данните се предават на анализатори и data scientists за по-дълбока обработка. Накрая данните завършват пътуването си на информационни панели, в отчети и в модели за машинно обучение.
Търсих информация, която да даде представа за това кои технологии са най-търсени в работата на data engineer в момента.
Методите
Събирах информация от три сайта за търсене на работа — , и и гледах кои ключови думи се свързват с "data engineer" в текстовете на обяви, насочени към жители на САЩ. За тази задача използвах две Python библиотеки — и . Включих ключови думи както от предишния списък за анализ на обяви за работа за позицията data scientist, така и такива, които избрах ръчно, четейки обяви за работа за data engineers. LinkedIn не е включен в източниците, тъй като бях забранен там след последния опит да събера данни.
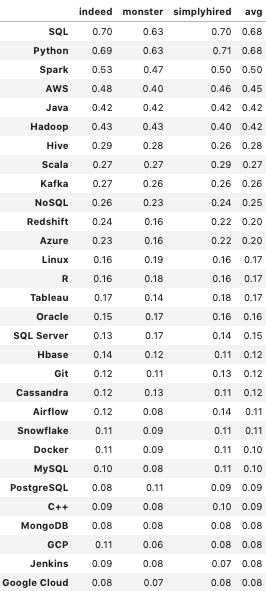
За всяка ключова дума изчислих процента на появяване спрямо общия брой текстове на всеки от сайтовете поотделно, а след това пресметнах средната стойност от трите източника.
Резултати
По-долу са представени тридесет технически термина от сферата на data engineering с най-високи показатели от всички три сайта за работа.
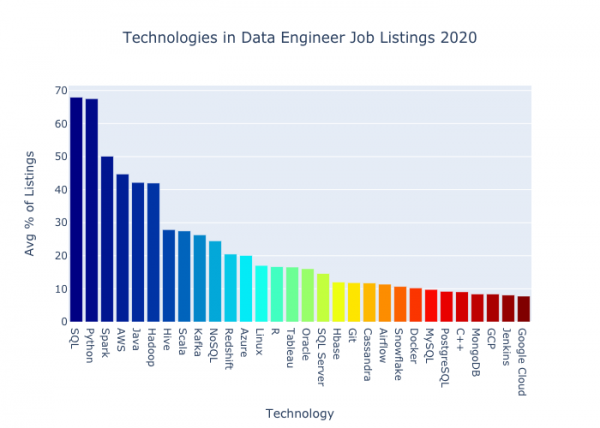
А ето и същите цифри, но представени под формата на таблица:
Нека да започнем по ред.
Преглед на резултатите
Как SQL, така и Python фигурира в повече от две трети от разгледаните обяви за работа. Именно тези две технологии има смисъл да се изучават на първо място. – много популярен език за програмиране, използван за работа с данни, създаване на уебсайтове и писане на скриптове. означава Structured Query Language (език за структурирани запитвания); той предполага стандарт, реализиран от група езици, и се използва за извличане на данни от релационни бази. Той съществува отдавна и е доказал своята надеждност.
За Spark се споменава в около половината от обявите. – е "обединен аналитичен двигател за обработка на големи данни с вградени модули за стрийминг, SQL, машинно обучение и обработка на графи". Той е особено популярен сред тези, които работят с големи бази данни.
AWS попада в приблизително 45% от текстовете на обявите. Това е облачна изчислителна платформа на Amazon; тя има най-голям дял на пазара сред всички облачни платформи.
Следват Java и Hadoop – малко повече от 40% от двамата. – широко разпространен, проверен в бой език, който в зае десето място сред езиците, които предизвикват ужас у програмистите. В противовес на него, Python се оказа втори сред езиците, на които се залага най-голяма любов. Язикът Java се управлява от Oracle, и всичко, което човек трябва да знае за него, може да се разбере от този скрийншот на официалната страница от януари 2020 година.
Като че ли пътувах с машина на времето
използва софтуерния модел MapReduce с клъстери от сървъри за големи данни. Вече все по-често се отказва от този модел.
Следващото, което виждаме, е Hive, Scala, Kafka и NoSQL – всяка от тези технологии е спомената в една четвърт от представените обяви. Apache Hive е програма-хранилище на данни, която "улеснява четенето, написването и управлението на големи набори от данни, разпределени в разпределени хранилища, чрез SQL". – програмният език, активно използван при работа с големи данни. В частност, Spark е разработен на Scala. В споменатата вече класация на най-страшните езици, Scala заема единадесета позиция. – разпределена платформа за обработка на поточни съобщения. Много популярна като средство за предаване на данни.
се противопоставят на SQL. Те се различават с това, че не са релационни, неструктурирани и притежават хоризонтална скалируемост. NoSQL придоби известна популярност, но лудостта по този подход, достигаща до пророчества, че той ще смени SQL като доминираща парадигма за съхранение, изглежда, вече е зад нас.
Сравнение с термините в обявите за data scientist
Ето тридесет технологични термина, най-разпространени сред работодателите в сферата на data science. Този списък получих по същия начин, какъвто описах по-горе за data engineering.
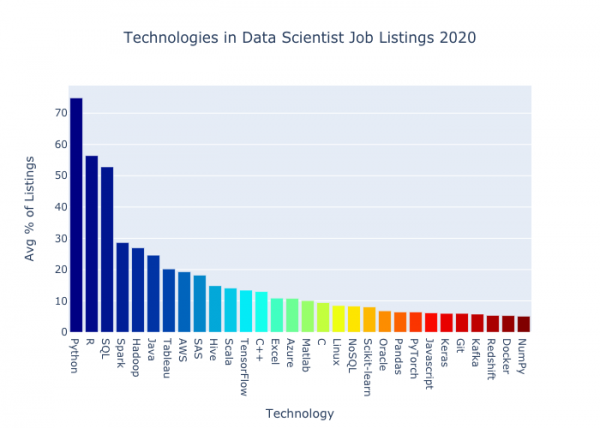
Споменавания на технологии в обявите за позиция data scientist през 2020 година
Ако говорим за общия брой, в сравнение с разгледания по-рано набор, обявите са увеличени с 28% (12 013 на 9 396). Нека видим, кои технологии се срещат в обявите за data scientists по-рядко, отколкото за data engineers.
По-популярни в data engineering
На графика по-долу са показани ключови думи с средна разлика в стойностите над 10% или под -10%.
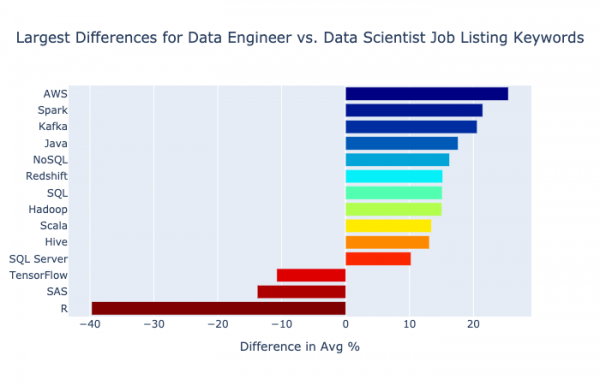
Най-големите различия в честотността на ключовите думи между data engineer и data scientist
Най-същественият ръст се наблюдава при AWS: в data engineering той се среща с 25% по-често, отколкото в data science (приблизително 45% и 20% от общия брой обяви съответно). Разликата е осезаема!
Ето същите данни в малко по-различен формат – на графиката резултатите за същата ключова дума в обявите за позиция data engineer и data scientist са поставени един до друг.
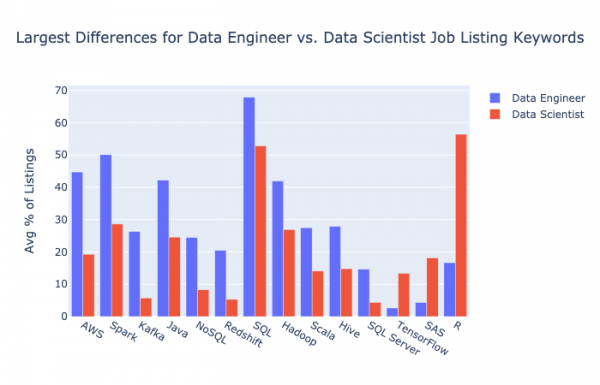
Най-големите различия в честотността на ключовите думи между data engineer и data scientist
Следващото голямо увеличаване забелязах при Spark – data engineer често трябва да работи с големи данни. също нарасна с 20%, което означава почти четири пъти в сравнение с резултата за ваканси data scientist. Предаването на данни е една от ключовите задължения на data engineer. Накрая, броят на споменаванията се е увеличил с 15% в сферата на data engineering за Java, NoSQL, Redshift, SQL и Hadoop.
По-малко популярни в data engineering
Сега да видим кои технологии са по-малко популярни в обявите за работа за data engineer.
Най-стръмният спад в сравнение със сферата на data science се случи при : там той се е срещал в около 56% от обявите, а тук – само в 17%. Впечатляващо. R е език за програмиране, който е популярен сред учени и статистици, и заема осмо място в рейтинга на ужасните езици.
също се среща в обявите на позицията data engineer значително по-рядко – разликата е 14%. SAS е патентован език, насочен към работа със статистика и данни. Интересен момент: според резултатите , в последно време той значително е загубил позиции – повече от всяка друга технология.
Търсени и в data engineering, и в data science
Трябва да се отбележи, че осем от десетте първи позиции в двата комплекта съвпадат. SQL, Python, Spark, AWS, Java, Hadoop, Hive и Scala влизат в десетката и за индустрията data engineering, и за data science. В графиката по-долу можете да видите петнадесетте най-популярни технологии при работодателите на data engineers, а до тях – техният показател за обяви за работа за data scientists.
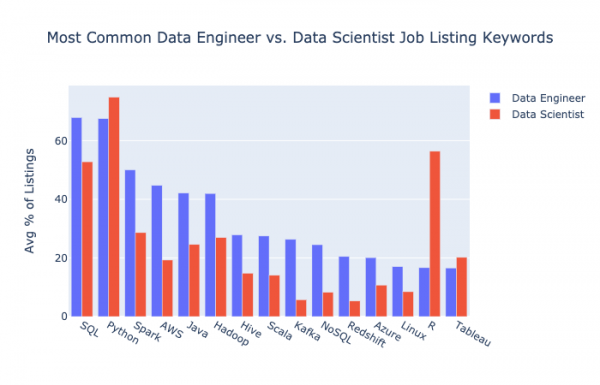
Препоръки
Ако искате да се занимавате с data engineering, бих ви посъветвал да овладеете следните технологии – изброявам ги в порядъка на приблизителна приоритетност.
Научете SQL. Насочвам ви към PostgreSQL, тъй като има отворен код, голяма популярност в общността и е в фаза на растеж. Как да използвате езика можете да разберете от книгата My Memorable SQL – нейното пилотно издание е налично .
Овладеите Python, макар и не на най-високо ниво. Книгата My Memorable Python е предназначена точно за начинаещи. Можете да я закупите на , електронна копие или физическо, по ваш избор, или може да я изтеглите в формат pdf или epub .
След като се запознаете с Python, преминете към pandas – Python библиотеката, която се използва за почистване и обработка на данни. Ако целите да работите в компания, която изисква умения за програмиране на Python (а такива са повечето), можете да бъдете сигурни, че знанието на pandas ще се предполага по подразбиране. В момента завършвам уводно ръководство за работа с pandas – можете , за да не пропуснете момента на излизане.
Научете AWS. Ако искате да станете data engineer, без облачна платформа в ръкава ви няма да се справите, а AWS е най-популярната сред тях. Курсовете , когато изучавах , си мисля, че и по AWS имат добри материали.
Ако вече сте овладели целия този списък и искате да нараснете в очите на работодателите като data engineer, предлагам да добавите Apache Spark за работа с големи данни. Въпреки че моето проучване на обявите за работа в data science показа спад на интереса, при data engineer-ите той все пак се появява почти в половината от обявите.
Накрая
Надявам се този обзор на най-търсените технологии за data engineer да ви е бил полезен. Ако ви интересува как стоят нещата с обявите за аналитиците, прочетете . Успешно инженерство!
Източник: habr.com
