

Прим. прев.: автор на тази статия (Luc Perkins) — разработчик и адвокат в организацията CNCF, която е дом за Open Source проекти, като Linkerd, SMI (Service Mesh Interface) и Kuma (между другото, замисляли ли сте се защо Istio не е в този списък?). Опитвайки се отново да донесе на DevOps общността по-добро разбиране за модния термин "service mesh", той представя 16 характерни възможности, които предлагат подобни решения.
Днес ― една от най-горещите теми в софтуерната инжинерия (и с право!). Считам, че тази технология е невероятно перспективна и мечтая да стана свидетел на нейното широко разпространение (разбира се, когато това има смисъл). Въпреки това, тя все още е обгърната в ореол на мистерия за повечето хора. В момента дори и онези, които са добре запознати с нея, често имат затруднения да формулират нейните предимства и какво точно представлява (включително и вашия покорен слуга). В статията ще се опитам да поправя ситуацията, изброявайки различни сценарии на използване "сервисни мрежи"*.
* Забележка: тук и по-нататък в статията ще се използва именно този превод ("сервисна мрежа") за все още новия термин service mesh.
Но преди това искам да направя няколко забележки:
- Никога не съм работил с сервисни мрежи и не съм ги използвал извън проекти, инициирани за собственото ми образование. От друга страна, аз написах куп документация за вътрешната service mesh на компанията Twitter през 2015 г. (тогава тя дори не се наричаше "сервисна мрежа") и участвах в разработването на сайта и документацията за , така че това означава нещо.
- Моят списък е ориентировъчен и непълен. Възможно е да съществуват неизвестни ми сценарии на използване, и с времето със сигурност ще се появят нови варианти, в зависимост от развитието на технологията и увеличаването на нейната популярност.
- В същото време не всяка съществуваща реализация на service mesh поддържа всички изброени случаи на използване. Затова моите изрази като "service mesh може..." трябва да се разбират като "отделни, а възможно и всички популярни реализации на service mesh могат...".
- Порядъкът на примерите няма значение.
Кратък списък:
- откриване на услуги;
- шифриране;
- автентикация и авторизация;
- балансиране на натоварването;
- circuit breaking;
- автоматично мащабиране;
- канарени разгръщания;
- синьо-зелени развертки;
- здравен статус;
- изключване на натоварването;
- планиране на трафика;
- изолация;
- ограничаване на честотата на запитванията, повторни опити и таймаути;
- телеметрия;
- одит;
- визуализация.
1. Откриване на услуги
TL;DR: Свържете се с други услуги в мрежата с помощта на простички имена.
Услугите трябва да имат възможността автоматично да "намират" една друга чрез адекватни имена ― например, service.api.production, pets/staging или cassandra. Облачните среди се отличават със своята еластичност, и зад едно име може да се крият множество инстанции на услугата. Ясно е, че в такава ситуация физически е невъзможно да се захардкодят всички IP адреси.
Освен това, когато една услуга открива друга, тя трябва да може да изпраща запитвания към тази услуга, без да се страхува, че те ще попаднат на входа на нейната неработеща инстанция. С други думи, service mesh трябва да следи за работоспособността на всички инстанции на услугите и да поддържа списък с хостове в максимално актуално състояние.
Всяка service mesh реализира механизъм за откриване на услуги по свой начин. В момента най-разпространеният метод е делегирането на външни процеси като DNS Kubernetes. В миналото в Twitter използвахме система за именуване . Освен това, технологията service mesh прави възможно появата на потребителски механизми за именуване (въпреки че все още не съм виждал реализация на SM с такава функционалност).
2. Шифроване
TL;DR: Премахнете незашифрованото трафик между услугите и нека този процес бъде автоматизиран и мащабируем.
Приятно е да знаете, че злоумышленици не могат да навлязат във вашата вътрешна мрежа. Мрежовите екрани се справят отлично с това. Но какво ще се случи, ако хакер все пак проникне вътре? Ще може ли да прави каквото си поиска с вътрешноуслужния трафик? Нека се надяваме, че това няма да се случи. За да предотвратим подобен сценарий, трябва да реализираме мрежа с нулево доверие (zero-trust), в която целият трафик между услугите е шифрован. Повечето съвременни услуги мрежи постигат това чрез взаимно (mutual TLS, mTLS). В някои случаи mTLS работи в цели облаци и клъстери (мисля, че и междупланетарните комуникации никога няма да се организират по подобен начин).
Разбира се, за mTLS service mesh не е задължително. Всяка услуга може сама да се погрижи за своя TLS, но това означава, че ще трябва да намерите начин за генериране на сертификати, разпределяне им по хостовете на услугата и включване в приложението код, който ще зарежда тези сертификати от файлове. И да, не забравяйте да актуализирате тези сертификати на определени интервали от време. Услугите мрежи автоматизират mTLS с помощта на системи като , които от своя страна автоматизират процеса на издаване и ротация на сертификати.
3. Автентикация и авторизация
TL;DR: Определете кой е инициатор на заявката и определете какво му е разрешено да прави още преди заявката да достигне услугата.
Услугите често искат да знаят, кой извършва заявката (автентикация) и, използвайки тази информация, решават, какво на този субект е разрешено да прави (авторизация). В този случай за местоимението "кой" могат да се крият:
- Други услуги. Това се нарича "автентикация на peer-а". Например, услугата
webиска да получи достъп до услугатаdb. Услугите мрежи обикновено решават подобни проблеми с помощта на mTLS: сертификатите в този случай служат като необходим идентификатор. - Някои потребители-личности. Това се нарича "автентикация на заявката". Например, потребителят
haxor69иска да закупи нова лампа. Услугите мрежи предоставят различни механизми, например, .На мнозина от нас ни се е налагало да правим това в кода на приложението. Постъпва заявка, преглеждаме таблицата
users, намираме потребителя и сравняваме паролата, след което проверяваме колонатаpermissionsи т.н. В случая на service mesh това се случва още преди заявката да достигне услугата.
След като установим, от кого е дошла заявката, трябва да определим какво му е разрешено да прави. Някои service mesh системи позволяват задаване на основни политики (за това кой и какво може да прави) под формата на YAML файлове или в командния ред, докато други предлагат интеграция с рамки като . Крайната цел е да накарате вашите услуги да приемат всякакви заявки, смело предполагайки, че те идват от надежден източник и и действието е разрешено.
4. Балансиране на натоварването
TL;DR: Разпределяйте натоварването по инстанциите на услугата по определен шаблон.
Сервизът в състава на обслужваща секта често се състои от множество идентични екземпляри. Например, днес сервизът cache състои се от 5 копия, а утре тяхното число може да се увеличи до 11. Заявките, насочващи се към cache, трябва да се разпределят в съответствие с определена цел. Например, за минимизиране на закъснението или максимизиране на вероятността да попаднете на работещ екземпляр. Най-често се използва алгоритъмът за ротационна обработка (Round-robin), но съществуват и множество други - например, методът на претеглените (weighted) заявки (може да изберете предпочитани цели), рингово (ring) хеширане (използване на консистентно хеширане за upstream хостове) или метод на най-малък брой заявки (предпочитание към екземпляра с най-малък брой заявки).
Класическите балансатори имат и други функции, като HTTP кеширане и защита от DDoS, но те не са много актуални за трафик от тип east-west (т.е. за трафик, протичащ в рамките на датацентъра - бел. на прев.) (типична област на приложение на service mesh). Разбира се, не е задължително да се използва service mesh за балансировка на натоварването, но тя позволява задаване и контролиране на политиките за балансировка за всеки сервиз от централен управляващ слой, елиминирайки необходимостта от стартиране и настройка на отделни балансатори в мрежовия стек.
5. Прекъсване на веригата (circuit breaking)
TL;DR: Спирайте трафика към проблемния сервиз и контролирайте щетите при най-лошите сценарии.
Ако по някаква причина сервизът не се справя с трафика, service mesh предоставя няколко варианта за решаване на този проблем (за други ще бъде говорено в съответните раздели). Circuit breaking е най-строгият вариант за изключване на сервиза от трафика. Въпреки това, сам по себе си той няма смисъл - необходим е резервен план. Може да се предвиди противовъздушно налягане () към сервизите, изпълняващи заявки (само не забравяйте да настроите вашата service mesh за това!), или например да боядисате статус страницата в червено и да пренасочите потребителите към друга версия на страницата с 'падащ кит' ('Twitter is down').
Сервизните мрежи позволяват не само да се определя, кога ще последва изключване и какво това следва. В този случай „когато“ може да включва всяка комбинация от зададени параметри: общият брой заявки за определен период, броя на паралелни връзки, pending-заявки, активни повторни опити и т.н.
Малко вероятно е да искате да злоупотребявате с circuit breaking, но е приятно да знаете, че има резервен план за крайни случаи.
6. Автомасштабиране
TL;DR: Увеличавайте или намалявайте броя на екземплярите на услугата в зависимост от зададените критерии.
Service mesh-овете не са планировчици, следователно те не извършват автомасштабиране самостоятелно. Въпреки това те могат да предоставят информация, на която планировчиците да вземат решения. Тъй като service mesh-овете имат достъп до целия трафик между услугите, те разполагат с обширна информация за текущото състояние: кои услуги имат проблеми, кои са слабо натоварени (ресурсите, отделени за тях, се използват напразно) и т.н.
Например, Kubernetes мащабира услугите в зависимост от използването на CPU и памет от подовете (вж. нашия доклад „“ — бел. на прев.), но ако решите да провеждате мащабиране на базата на какъвто и да е друг показател (в нашия случай — свързан с трафика), ще е необходима специална метрика. Ръководството показва как да го направите с помощта на , и , но самият процес е доста сложен. Бихме искали service mesh да го опрости, позволявайки просто да задаваме условия като „увеличи броя на екземплярите на услугата auth, ако броят на заявките, които чакат обработка, надвиши прагова стойност в течение на минута“.
7. Канарски разгръщания
TL;DR: Тествайте нови функции или версии на услугата в подмножество потребители.
Да предположим, че разработвате един SaaS продукт и планирате да пуснете новата му версия. Тествали сте я в staging и тя работи отлично. Но все пак, имате известни опасения относно нейното поведение в реални условия. С други думи, нужно е да проверите новата версия с реални задачи, без да рискувате доверието на потребителите. Канарените развертки са идеални за това. Те позволяват да демонстрирате нова функция на определена подгрупа от потребители. Тази подгрупа може да се състои от най-лоялните потребители или от тези, които ползват безплатната версия на продукта, или потребители, които изразяват желание да бъдат "опитни зайци".
Service mesh-овете реализират това, позволявайки да зададете критерии, които определят кой и коя версия на приложението ще види, и съответно маршрутизирайки трафика. За самите услуги нищо не се променя. Версия 1.0 на услугата предполага, че всички заявки идват от потребители, които точно нея трябва да видят, а версия 1.1 предполага същото за своите потребители. А вие, междувременно, можете да променяте процента на трафика между старата и новата версия, пренасочвайки растящ брой потребители към новата, ако тя работи стабилно и вашите "опитни" дават одобрение.
8. Синьо-зелени развертки
TL;DR: Пуснете новата уау функция, но бъдете готови веднага да я върнете.
Същност е в това, че пуснете нов "син" сервис, стартирайте го паралелно със стария "зелен". Ако всичко мине гладко и новият сервис се представи добре, то старият може да бъде постепенно изключен. (Уви, някой ден и този нов "син" сервис ще сподели съдбата на "зеления" и ще изчезне...) Синьо-зелените развертки се различават от канарените по това, че новата функция обхваща веднага всички потребители (а не част); смисълът тук е да имате подготвено "резервно пристанище", ако нещо не тръгне както трябва.
Service mesh-овете предлагат много удобен начин за тестване на "синия" сервис и мигновено превключване на работещия "зелен" в случай на проблеми. Да не говорим, че в процеса те предоставят много информация (вж. точка "Телеметрия" по-долу) за работата на "синия", която помага да се разбере, готов ли е той за пълноценна експлоатация.
Прим. прев.: Повече за различни стратегии за разгръщане в Kubernetes (включително споменатите canary, blue/green и други) можете да прочетете в .
9. Проверка на здравето
TL;DR: Следете кои копия на услугите са работоспособни и реагирайте на тези, които вече не са.
Проверка на здравето (health check) помага да се вземе решение дали копията на услугата са готови да приемат и обработват трафик. Например, в случая на HTTP услуги, проверката на здравето може да изглежда като GET заявка на endpoint /health. Отговор 200 OK означава, че копието е здраво, всеки друг - че не е готово да приема трафик. Service mesh-овете позволяват указване както на метода, по който ще се проверява работоспособността, така и на честотата, с която тази проверка ще се извършва. Тази информация може да се използва след това за други цели - например, за баланс на натоварването и circuit breaking.
Така проверката на здравето не е самостоятелна употреба, а обикновено се използва за постигане на други цели. Също така, в зависимост от резултатите от health check-ове, може да се наложат външни (спрямо другите цели на сервисните мрежи) действия: например, обновяване на страницата със състоянието, създаване на issue в GitHub или попълване на тикет в JIRA. И service mesh предлага удобен механизъм за автоматизация на всичко това.
10. Пренасочване на натоварването (load shedding)
TL;DR: Пренасочвайте трафика в отговор на временно увеличение на използването.
Ако даден сервис се окаже претоварен с трафик, можете временно да пренасочите част от този трафик на друго място (тоест да "изхвърлите", "препратите" (shed) го там). Например, в резервен сервис или дата-център, или в постоянен тема. В резултат, услугата ще продължи да обработва част от заявките, вместо да спре напълно обработката. Сблъскването на натоварването е предпочитано пред разкъсване на веригата, но все пак не е желателно да се злоупотребява с него. То позволява предотвратяване на каскадни откази, в резултат на които падат downstream-сервизите.
11. Паралелизиране/огледално отразяване на трафика
TL;DR: Изпращайте една заявка наведнъж на няколко места.
Понякога се налага да се изпрати заявка (или набор от заявки) наведнъж на няколко услуги. Характерен пример е изпращането на част от production-трафика към staging-сервиз. Основният уеб-сървър на production изпраща заявка към долния обслужващ сервиз products.production и само към него. А service mesh интелигентно копира тази заявка и я изпраща на products.staging, за което уеб-сървърът дори не подозира.
Още един свързан сценарий за използване на услугата мрежа, който може да бъде реализиран върху паралелизиране на трафика, е . То предвижда изпращането на едни и същи заявки до различни версии на услугата и проверката дали всички версии се държат еднакво. Все още не съм срещал реализирана service mesh с интегрирана система за регресионно тестване като , но самата идея изглежда обещаваща.
12. Изолация
TL;DR: Разделяйте вашата service mesh на мини-мрежи.
Също известна като сегментация, изолацията е изкуството да се разделя сервизната мрежа на логически отделни сегменти, които не знаят нищо един за друг. Изолацията е малко подобна на създаването на виртуални частни мрежи. Основната разлика обаче е, че все още можете да се възползвате от всички предимства на service mesh (като откритие на услуги), но с допълнителна сигурност. Например, ако злонамерен изпълнител пробие в услуга в една от подмрежите, той няма да може да види какви услуги са стартирани в другите подмрежи или да прихване трафика им.
Освен това, предимствата могат да бъдат и организационни. Може да искате да разделите услугите на подмрежи в зависимост от структурата на компанията и да освободите разработчиците от когнитивната тежест, произтичаща от необходимостта да имат всичко в съзнанието си за whole service mesh.
13. Ограничаване на честотата на заявките, повторни опити и таймаути
TL;DR: Вече не е необходимо да включвате текущите задачи за управление на заявките в кодовата база.
Всички тези неща могат да се разглеждат като отделни случаи на употреба, но реших да ги обединя поради една обща характеристика: те поемат задачите за управление на жизнения цикъл на заявките, които обикновено се изпълняват от библиотеките за приложения. Ако разработвате уеб сървър на Ruby on Rails (неинтегриран с service mesh), който извършва заявки към backend услуги чрез , приложението ще трябва само да решава какво да прави, ако N заявки завършват с неуспех. Също така ще трябва да се определи какъв обем трафик могат да обработят тези услуги и да се ‘hardcode’ тези параметри с помощта на специална библиотека. Освен това, приложението ще трябва да решава кога е време да се предаде и да позволи на заявката да изтече (по timeout). И за да се променят някои от изброените параметри, уеб сървърът ще трябва да се спре, да се преконфигурира и да се стартира отново.
Предаването на тези задачи на сервисната мрежа не само означава, че разработчиците на услуги не трябва да мислят за тях, но и че могат да се разглеждат по-широко. Ако се използва сложна верига от услуги, да кажем, A → B → C → D → E, необходимо е да се вземе предвид целият жизнен цикъл на заявката. Ако целта е да се удължат таймаутите в услуга C, логично е да се направи това всичко заедно, а не на части: актуализирайки кода на услугата и изчаквайки, докато pull request бъде приет и CI системата разгръща актуализираната услуга.
14. Телеметрия
TL;DR: Събирайте всяка нужна (и не съвсем) информация от услугите.
Телеметрията е общ термин, обхващащ метрики, разпределено проследяване и логове. Сервисните мрежи предлагат механизми за събиране и обработка на всички три типа данни. Тук става малко размито, тъй като броят на възможните варианти е твърде голям. За събиране на метрики има и други инструменти, а за събиране на логовете могат да се използват , , и др. (например, ClickHouse с нашия за K8s — бел. ред.), за разпределено проследяване има и т.н. Всяка service mesh може да поддържа определени инструменти и да не поддържа други. Интересно ще бъде да се види дали проектът може да осигури някаква конвергенция.
В този случай предимството на технологията service mesh е, че sidecar контейнерите могат в принцип да събират всички изброени данни от своите услуги. С други думи, получавате единна система за събиране на телеметрия и service mesh може да обработва цялата тази информация по различни начини. Например:
- следите логовете от някаква услуга в CLI;
- наблюдавате обема на заявките от контролния панел на service mesh;
- събирате разпределени трасировки и ги пренасочвате в система като Jaeger.
Внимание, субективно мнение: Общо взето, телеметрията е област, в която сериозно вмешателство на сервисната мрежа е нежелателно. Събирането на основна информация и наблюдаването в реално време на някои 'златни метрики' като процента на успешните заявки и закъсненията е нормално, но да се надяваме, че няма да се наложи да сме свидетели на възникването на така наречените Франкенщайн стекове, които се опитват да заменят специализирани системи, от които някои вече са доказали своето качество и са добре проучени.
15. Одит
TL;DR: Онзи, който забравя уроците по история, е обречен да ги повтори.
Одитът е изкуството да наблюдавате важни събития в системата. В случай на service mesh това може да означава проследяване на това, кой е извършил заявки към конкретни endpoint'и на определени услуги или колко пъти през последния месец е имало събитие, свързано с безопасността.
Ясно е, че одитът е изключително свързан с телеметрията. Разликата е, че телеметрията обикновено се асоциира с неща като производителност и техническа изправност, докато одитът може да има отношение към юридически и други въпроси, които излизат извън чисто техническата сфера (например, съответствие с GDPR — Общия регламент на ЕС за защита на данните).
16. Визуализация
TL;DR: Да живее React.js — неизчерпаем източник на странни интерфейси.
Възможно е да има по-подходящ термин, но не го знам. Просто имам предвид графично представяне на service mesh или на нейните компоненти. Тези визуализации могат да включват индикатори като средни закъснения, информация за конфигурацията на sidecar контейнерите, резултати от проверки за здраве и известия.
Работата в сервизно-ориентирана среда е свързана с много по-силно когнитивно натоварване в сравнение с Неговото Величество Монолита. Затова когнитивното налягане трябва да се намалява на всяка цена. Обикновен графичен интерфейс за service mesh с възможност да кликнете на бутон и да получите необходимия резултат може да има решаващо значение за растежа на популярността на тази технология.
Не бяха включени в списъка
Първоначално имах намерение да включа в списъка още няколко сценария на използване, но после реших да не го правя. Ето ги заедно с причините за решението ми:
- Мулти-датацентър. В моето разбиране, това не е толкова сценарий на използване, колкото тесна и конкретна област на приложение на сервисните мрежи или на определен набор от функции като откриване на услуги.
- Ingress и egress. Това е свързана област, но се ограничих (възможно е изкуствено) до сценария на използване „трафик east-west“. Ingress и egress заслужават отделна статия.
Заключение
Дотук е всичко! Отново, този списък е доста условен и вероятно непълен. Ако смятате, че съм пропуснал нещо или съм сгрешил, не се колебайте да се свържете с мен в Twitter (). Моля, спазвайте правилата на приличието.
P.S. от преводача
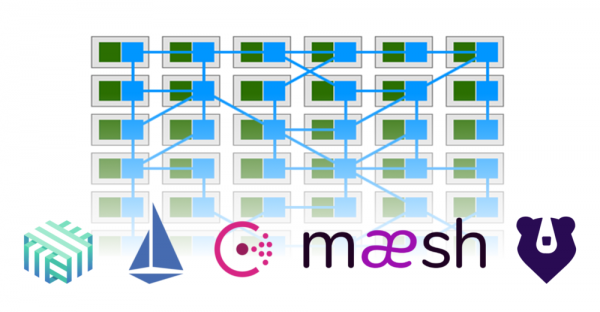
Като основа за заглавната илюстрация на статията е взето изображение от статията „“ (автор — Gregory MacKinnon). На него е показано как част от функционалността на приложенията (в зелено) преминава към service mesh, осигуряваща взаимовръзките между тях (в синьо).
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
