

Сървърлес не означава физическа липса на сървъри. Това не е "убиец" на контейнерите и не е мимолетна мода. Това е нов подход към изграждането на системи в облака. В днешната статия ще разгледаме архитектурата на Serverless приложения, ще видим каква роля играе доставчикът на Serverless услуги и проектите с отворен код. В края ще обсъдим въпроси относно приложението на Serverless.
Искам да напиша сървърната част на приложението (да е дори интернет магазин). Това може да бъде чат, услуга за публикуване на съдържание или балансировач на натоварването. Във всеки случай наистина ще има много главоболия: ще трябва да подготвя инфраструктурата, да определя зависимостите на приложението, да обмислям операционната система на хоста. След това ще трябва да обновявам малки компоненти, които не засягат работата на останалата част от монолита. И нека не забравяме за мащабирането при натоварване.
А какво ако вземем ефимерни контейнери, в които нужните зависимости вече са инсталирани, а самите контейнери са изолирани един от друг и от ОС на хоста? Ще разбием монолита на микросервизи, всеки от които може да се обновява и мащабира независимо от другите. Като поставя кода в такъв контейнер, мога да го стартирам на всяка инфраструктура. Вече е по-добре.
А ако не искам да настройвам контейнери? Не искам да мисля за мащабиране на приложението. Не искам да плащам за времето, когато контейнерите са пуснати, а натоварването на услугата е минимално. Искам да пиша код. Да се съсредоточа върху бизнес логиката и да пускам продукти на пазара с бързината на светлината.
Тези мисли ме доведоха до сървърлес изчисления. Сървърлес в този случай означава не физическа липса на сървъри, а отсъствие на главоболия, свързани с управлението на инфраструктурата.
Идеята е, че логиката на приложението се разделя на независими функции. Те имат събитийна структура. Всяка функция изпълнява една "микро задание". Всичко, което се изисква от разработчика, е да качи функциите в конзолата, предоставена от облачния доставчик, и да ги свърже с източниците на събития. Кодът ще се изпълнява при поискване в автоматично подготвен контейнер, а аз ще платя само за времето на изпълнение.
Нека разгледаме как сега ще изглежда процесът на разработка на приложението.
От страна на разработчика
По-рано говорихме за приложението за онлайн магазин. В традиционния подход основната логика на системата се изпълнява от монолитно приложение. И сървърът с приложението е постоянно активен, дори ако няма натоварване.
За да преминем към serverless, разделяме приложението на микрозадачи. За всяка от тях пишем своя функция. Функциите са независими една от друга и не запазват информация за състоянието (stateless). Те дори могат да бъдат написани на различни езици. Ако една от тях ‘падне’, приложението изцяло няма да спре. Архитектурата на приложението ще изглежда така:
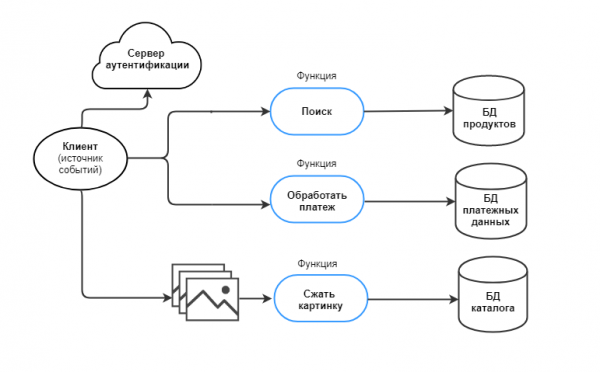
Разделението на функции в Serverless напомня на работата с микросервизи. Но микросервизът може да извършва няколко задачи, докато функцията по идея трябва да извършва само една. Нека си представим, че стои задача да се събира статистика и да се извежда при запитване на потребителя. В микросервисния подход задачата се изпълнява от един сервис с две входни точки: за запис и за четене. В безсървърните изчисления това ще бъдат две различни функции, не свързани помежду си. Разработчикът спестява изчислителни ресурси, ако например статистиката се обновява по-често, отколкото се извежда.
Serverless-функциите трябва да се изпълняват за кратък период от време (timeout), зададен от доставчика на услуги. Например, за AWS timeout е 15 минути. Следователно, дълготрайните функции (long-lived) ще трябва да бъдат адаптирани към изискванията - с това Serverless се различава от другите популярни технологии днес (контейнери и Platform as a Service).
На всяка функция задаваме събитие. Събитието е тригер за действие:
Събитие
Действие, което изпълнява функцията
В хранилището е качена картинка на продукта
Сжать картинка и выгрузить в каталог
В базата данни е обновен адреса на физическия магазин
Добавяне на ново местоположение в картите
Клиентът плаща за продукта
Стартиране на обработката на плащането
Събитията могат да бъдат HTTP-заявки, потокови данни, опашки от съобщения и така нататък. Източниците на събития са промяна или появяване на данни. Освен това, функциите могат да се стартират по таймер.
Архитектурата е разработена и приложението почти стана serverless. Продължаваме напред към доставчика на услуги.
От страна на доставчика
Обикновено безсървърните изчисления се предлагат от доставчици на облачни услуги. Наричат се по различен начин: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
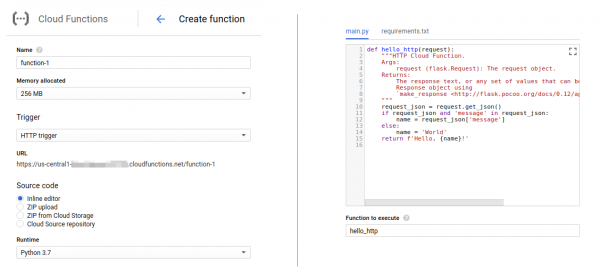
Ще използваме услугата чрез конзолата или личния кабинет на доставчика. Кодът на функциите може да се зареди по един от следните начини:
- да пишем кода в интегрираните редактори чрез уеб-конзолата,
- да качим архив с кода,
- да работим с публични или частни git-репозитории.
Тук също конфигурираме събитията, които предизвикват функцията. При различните доставчици наборите от събития могат да се различават.
Доставчикът е изградил и автоматизирал система Function as a Service (FaaS) на своята инфраструктура:
- Кодът на функциите попада в хранилището на страната на доставчика.
- Когато се появи събитие, на сървъра автоматично се разгръщат контейнери с подготвена среда. Всеки екземпляр на функцията има свой изолиран контейнер.
- От хранилището функцията се изпраща в контейнера, изчислява се и връща резултата.
- Броят на паралелните събития расте ― увеличава се числото на контейнерите. Системата автоматично се мащабира. Ако потребителите не се обръщат към функцията, тя ще бъде неактивна.
- Доставчикът задава времето на неактивност на контейнерите ― ако в рамките на това време функции не се появят в контейнера, той се унищожава.
По този начин получаваме Serverless „извън кутията“. Ще плащаме за услугата по модела pay-as-you-go и само за тези функции, които се използват, и само за времето, в което са били използвани.
За да запознаят разработчиците с услугата, доставчиците предлагат до 12 месеца безплатно тестване, но ограничават общото време на изчисления, броя на запитванията на месец, средствата или потреблението на мощности.
Основното предимство от работа с доставчика е, че не е нужно да се грижим за инфраструктурата (сървъри, виртуални машини, контейнери). От своя страна доставчикът може да реализира FaaS както на свои разработки, така и с помощта на open-source инструменти. За тях ще говорим по-долу.
От страна на open source
През последните години общността на open-source активно работи върху инструменти Serverless. Включително големите играчи на пазара допринасят за развитието на безсървърните платформи:
- Google предлага на разработчиците своя open-source инструмент ― . В разработката му участват IBM, RedHat, Pivotal и SAP;
- IBM работели са по платформата Serverless , която по-късно стана проект на Apache Foundation;
- Microsoft частично откриха кода на платформата .
Разработките продължават и в посоката на serverless-фреймворковете. и разгръщат се вътре в предварително подготвени Kubernetes-кластери, работи както с Kubernetes, така и с Docker Swarm. Фреймворкът играе ролята на своеобразен контролер - по заявка подготвя среда за изпълнение вътре в кластера и след това стартира функция.
Фреймворковете оставят пространство за конфигуриране на инструмента според собствените нужди. Например, в Kubeless разработчикът може да настрои timeout за изпълнение на функцията (по подразбиране 180 секунди). Fission, в опит да реши проблема с студения старт, предлага да се поддържат част от контейнерите постоянно включени (въпреки че това води до разходи за неактивни ресурси). А OpenFaaS предлага набор от тригери на всякакъв вкус: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs и други.
Инструкции за започване на работа могат да се намерят в официалната документация на фреймворковете. Работата с тях предполага наличие на малко повече умения, отколкото при работа с доставчик - минимум умение за стартиране на Kubernetes-кластер чрез CLI. Максимум, да включим в работа и други open-source инструменти (например, мениджър на опашки Kafka).
Независимо от начина, по който ще работим с Serverless - чрез доставчик или с помощта на open-source, ще получим редица предимства и недостатъци на Serverless подхода.
От гледна точка на предимствата и недостатъците,
Serverless развива идеите на контейнерната инфраструктура и микросервисния подход, при които екипите могат да работят в многоезичен режим, без да се привързват към една платформа. Изграждането на системата се опростява, а коригирането на грешки става по-лесно. Микросервисната архитектура позволява добавяне на нов функционал значително по-бързо, отколкото в случая с монолитно приложение.
Serverless още повече намалява времето за разработка, позволявайки на разработчика да се съсредоточи изцяло върху бизнес логиката на приложението и писането на код. В следствие на това времето за извеждане на разработките на пазара се съкращава.
Като бонус получаваме автоматично мащабиране в зависимост от натоварването, а плащаме само за използваните ресурси и само в периода, когато те се използват.
Както всяка технология, Serverless има недостатъци.
Например, такъв недостатък може да бъде времето на студения старт (в рамките на 1 секунда за езици като JavaScript, Python, Go, Java, Ruby).
От една страна, реално времето за студен старт зависи от много променливи: езикът, на който е написана функцията, броят на библиотеките, обемът на кода, взаимодействията с допълнителни ресурси (като бази данни или сървъри за удостоверяване). Тъй като разработчикът управлява тези променливи, той може да намали времето за стартиране. Но от друга страна, разработчикът не може да контролира времето за стартиране на контейнера ― тук всичко зависи от доставчика.
Студеният старт може да се превърне в топъл, когато функцията използва предишен контейнер, стартиран от предишно събитие. Тази ситуация ще възникне в три случая:
- ако клиентите често използват услугата и нараства броят на обажданията към функцията;
- ако доставчикът, платформата или фреймуъркът позволяват да се държат част от контейнерите включени постоянно;
- ако разработчикът стартира функции на таймер (например, на всеки 3 минути).
За много приложения студеният старт не е проблем. Тук трябва да се основаваме на типа и задачите на услугата. Забавянето на старта с една секунда не винаги е критично за бизнес приложение, но може да стане критично за медицински услуги. Вероятно, в такъв случай безсървърният подход вече не е подходящ.
Следващият недостатък на безсървърните технологии е краткото време на живот на функцията (таймаутът, в който функцията трябва да бъде изпълнена).
Но, ако предстои работа с дългоживеещи задачи, може да се използва хибридна архитектура ― да се комбинира безсървърно с друга технология.
Не всички системи ще могат да работят по безсървърна схема.
Някои приложения все още ще съхраняват данни и състояние по време на изпълнение. Някои архитектури ще останат монолитни, а някои функции ще бъдат дългоживеещи. Въпреки това (както някога облачните технологии, а след това и контейнерите), безсървърните технологии са с голямо бъдеще.
В това отношение бих искал плавно да премина към въпроса за приложението на безсървърния подход.
От гледна точка на приложението
През 2018 година процентът на използване на безсървърните технологии . Сред компаниите, които вече са внедрили технологията в своите услуги, са гиганти на пазара като Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. В същото време трябва да се разбира, че безсървърното не е панацея, а инструмент за решаване на определен кръг от задачи:
- Да се намали простоя на ресурсите. Не е необходимо постоянно да поддържате виртуална машина за услуги, към които има малко запитвания.
- Обработвайте данни "в движение". Стискайте изображения, изрязвайте фона, променяйте кодировката на видео, работете с IoT сензори, извършвайте математически операции.
- "Скъсайте" различни услуги помежду им. Git хранилище с вътрешни програми, чат бот в Slack с Jira и календара.
- Баланс на натоварването. Тук ще се спрем по-подробно.
Предполагаме, че има услуга, която получава 50 потребителя. За нея е настроена виртуална машина със слаб хардуер. От време на време натоварването на услугата нараства многократно. В този случай слабият хардуер не справя.
Може да включите балансировач в системата, който да разпределя натоварването, да речем, на три виртуални машини. На този етап ние не можем точно да прогнозираме натоварването, затова някакво количество ресурси държим включени като "резерв". И плащаме за бездействие.
В такава ситуация можем да оптимизираме системата чрез хибриден подход: зад балансировача на натоварването оставяме една виртуална машина и поставяме връзка на Serverless Endpoint с функции. Ако натоварването надвиши прага, балансировачът задейства инстанции на функции, които поемат част от обработката на заявките.
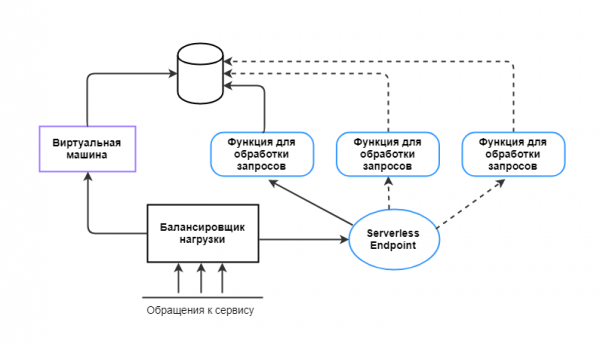
По този начин Serverless може да се използва там, където периодично, но интензивно се обработват голям брой заявки. В този случай е по-изгодно да стартирате няколко функции за 15 минути, отколкото постоянно да поддържате виртуална машина или сървър.
При всички предимства на безсървърната обработка, преди внедряването, най-напред трябва да оцените логиката на приложението и да разберете какви задачи може да реши Serverless в конкретния случай.
Serverless и Selectel
В Selectel ние вече чрез нашия контролен панел. Сега изграждаме собствена FaaS платформа. Искаме разработчиците да могат да решават своите задачи, използвайки Serverless чрез удобен, гъвкав интерфейс.
Ако имате идеи за това какъв трябва да бъде идеалният FaaS платформ и как искате да използвате Serverless в своите проекти, споделете ги в коментарите. Ще вземем вашите желания предвид при разработването на платформата.
Материалите, използвани в статията:
Източник: habr.com
