

Философско въведение
Както е известно, има само два метода за решаване на задачи:
- Метод на анализа или метод на дедукцията, от общото към частното.
- Метод на синтеза или метод на индукцията, от частното към общото.
За решаване на проблема „подобряване на производителността на базата данни“ това може да изглежда по следния начин.
Анализ — разлагаме проблема на отделни части и, решавайки ги, се опитваме в крайна сметка да подобрим производителността на базата данни като цяло.
На практика анализът изглежда примерно така:
- Появява се проблем (инцидент с производителността)
- Събираме статистическа информация за състоянието на базата данни
- Търсим „тесни места“ (bottlenecks)
- Решаваме проблемите с тесните места
Тесни места на базата данни — инфраструктура (CPU, памет, дискове, мрежа, ОС), настройки (postgresql.conf), заявки:
Инфраструктура: възможностите за влияние и промяна за инженера — почти нулеви.
Настройки на базата данни: възможностите за промени са малко по-големи, отколкото в предишния случай, но като правило все пак доста затруднителни, особено в облаците.
Запитвания към базата данни: единствената област за маневри.
Синтез — подобряваме производителността на отделни части, очаквайки, че в резултат производителността на базата данни ще се подобри.
Лично въведение или защо всичко това е необходимо
Как протича процесът на решаване на инциденти с производителността, ако производителността на базата данни не се наблюдава:
Клиентът - „при нас е всичко лошо, бавно, направете ни добре“
Инженерът - „лошо как?“
Клиентът – „ето как сега (преди час, вчера, на предишната сделка беше), бавно“
Инженерът – “а кога беше добре?”
Клиентът – “преди седмица (две седмици) беше прилично.” (Това е честно)
Клиентът – “а не помня, кога е било добре, но сега е зле” (Обичаен отговор)
В резултат на това получаваме класическа картина:
Кой е виновен и какво да се прави?
На първата част от въпроса е най-лесно да се отговори — винаги е виновен инженерът DBA.
На втората част отговорът също не е особено сложен — необходимо е да се внедри система за мониторинг на производителността на базата данни.
Възниква първият въпрос — какво да се наблюдава?
Път 1. Ще наблюдаваме ВСИЧКО
Натоварването на CPU, броят на операции с четене/запис на диска, размерът на определената памет и още множество различни метрики, които всяка по-утвърдена система за мониторинг може да предостави.
В резултат се получава купчина графики, обобщаващи таблици и непрекъснати известия на имейл, а инженерите са напълно заети с решаването на стотици еднакви тикети, обикновено с формулировката — "Временен проблем. Не са необходими действия." Но все пак, всички са заети и винаги има какво да се покаже на клиента — работата кипи.
Път 2. Да се мониторира само това, което е необходимо, а онова, което не е необходимо, да не се мониторира.
Може да се мониторира малко по-различно — единствено съществата и събитията:
- На които инженерът DBA може да влияе.
- За които съществува алгоритъм на действие при настъпване на събитие или промяна в съществото.
Изхождайки от това предположение и помня "Философско въведение" с цел да се избегне редовното повторение на "Лично въведение или защо всичко това е необходимо", би било рационално да се мониторира производителността на определени заявки, за оптимизация и анализ, което в крайна сметка би трябвало да доведе до подобрение на производителността на цялата база данни.
Но за да подобрим тежка заявка, която влияе на общата производителност на базата данни, първо трябва да я намерим.
Така че, възникват два взаимосвързани въпроса:
- каква заявка се счита за тежка
- как да търсим тежки заявки.
Очевидно, тежка заявка е заявка, която използва много ресурси на ОС за получаване на резултат.
Преминаваме към втория въпрос — как да търсим и след това мониторим тежки заявки?
Какви възможности за мониторинг на заявки има в PostgreSQL?
В сравнение с Oracle, възможностите са малко, но все пак има какво да направим.
PG_STAT_STATEMENTS
За търсене и мониторинг на тежки заявки в PostgreSQL е предназначено стандартното разширение pg_stat_statements.
След инсталацията на разширението в целевата база данни се появява идентично наименовано представление, което трябва да се използва за целите на мониторинга.
Целеви колони pg_stat_statements за изграждане на система за мониторинг:
- queryid Вътрешен хеш-код, изчислен от синтактичното дърво на оператора
- max_time Максимално време, прекарано на оператора, в милисекунди
Натрупвайки и използвайки статистиката по тези две колони, може да се построи система за мониторинг.
Как се използва pg_stat_statements за мониторинг на производителността на PostgreSQL?
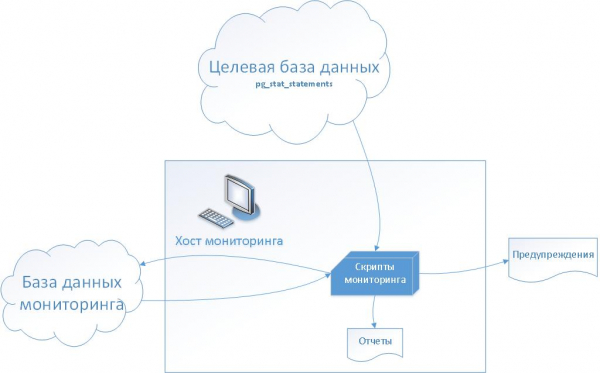
За наблюдение на производителността на запитванията се използва:
От страна на целевата база данни — изглед pg_stat_statements
От страна на сървър и базата данни за мониторинг — набор от bash скриптове и сервизни таблици.
Първи етап — събиране на статистически данни
На хоста за мониторинг редовно се стартира скрипт, който копира съдържанието на изгледа pg_stat_statements от целевата база данни в таблицата pg_stat_history в базата данни за мониторинг.
По този начин се формира история на изпълнението на отделни запитвания, която може да се използва за генериране на отчети за производителността и настройка на метриките.
Втори етап — настройка на метриките за производителност
На базата на събраните данни избираме запитвания, чиято изпълнение е най-критично/важно за клиента (приложението). Съгласно споразумението с клиента, задаваме стойности на метриките за производителност, използвайки полетата queryid и max_time.
Резултат — стартиране на мониторинга на производителността
- Мониторинговият скрипт при стартиране проверява конфигурираните метрики за производителност, сравнявайки стойността на max_time метриката със стойността от изгледа pg_stat_statements в целевата база данни.
- Ако стойността в целевата база данни надвишава стойността на метриката – се генерира предупреждение (инцидент в тикетната система)
Допълнителна възможност 1
История на плановете за изпълнение на запитванията
За по-късно разрешаване на инциденти с производителността е много полезно да имате история на промените в плановете за изпълнение на запитванията.
За съхранение на историята се използва сервизна таблица log_query. Таблицата се запълва при анализа на заредения лог-файл на PostgreSQL. Тъй като в лог-файла, за разлика от изгледа pg_stat_statements, попада целият текст с параметрите на изпълнението, а не нормализираният текст, имате възможност да водите запис не само на времето и продължителността на запитванията, но и да запазите плановете за изпълнение към текущия момент.
Допълнителна възможност 2
Процес на непрекъснато подобряване на производителността
Наблюдението на отделни запитвания по принцип не е предназначено за решаване на проблема с непрекъснатото подобряване на производителността на базата данни като цяло, тъй като контролира и решава проблемите с производителността само за отделни запитвания. Въпреки това, методът може да се разшири и да се настрои за наблюдение на запитванията за всички бази данни.
За целта трябва да въведете допълнителни метрики за производителност:
- През последните дни
- За базовия период
Скриптът избира заявки от представление pg_stat_statements в целевата база данни и сравнява стойността max_time с средната стойност max_time, в първия случай за последните дни или за избрания период от време (базова линия), а във втория случай.
По този начин, в случай на деградация на производителността за всяка заявка, предупреждението ще бъде генерирано автоматично, без ръчен анализ на отчетите.
Какво общо има синтезът?
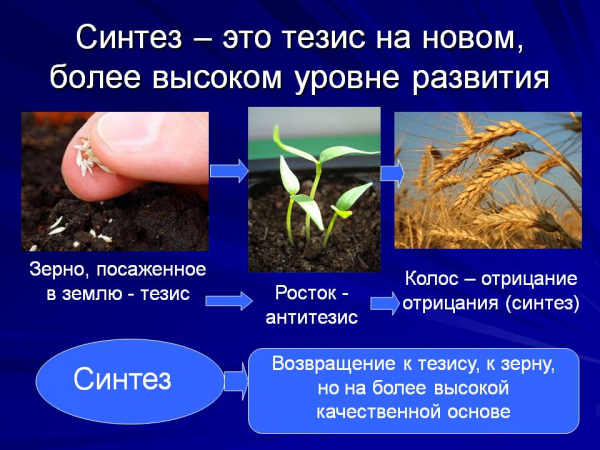
В описания подход, както предполага методът на синтез — чрез подобряване на отделни части от системата, подобряваме системата като цяло.
- Заявката, изпълнявана от базата данни – тезис
- Променената заявка – антитезис
- Смяната на състоянието на системата — синтез
Развитие на системата
- Разширения на събираната статистика чрез добавяне на история за системното представление pg_stat_activity
- Разширение на събираната статистика чрез добавяне на история за статистиката на отделните таблици, участващи в заявките
- Интеграция с облачната система за мониторинг на AWS
- И още, нещо може да измислим…
Източник: habr.com
