

Kube-scheduler е незаменим компонент на Kubernetes, който отговаря за планирането на подове по нодове в съответствие с зададените политики. Често, при експлойтация на Kubernetes клъстера, не ни се налага да се замисляме за политиките, по които се извършва планирането на подовете, тъй като наборът от политики на дефолтния kube-scheduler е подходящ за повечето ежедневни задачи. Въпреки това, има ситуации, в които е важно прецизно да управляваме разпределението на подовете, и за изпълнението на тази задача има два пути:
- Създаване на kube-scheduler с персонализиран набор от правила
- Написване на собствен scheduler и обучение за работа с API-сървъра
В рамките на тази статия ще опиша изпълнението именно на първата точка за решаване на проблема с неравномерното планиране на подове в един от нашите проекти.
Кратко въведение в работата на kube-scheduler
Важно е да се отбележи, че kube-scheduler не отговаря за непосредственото планиране на подове — той отговаря само за определянето на нодата, на която трябва да бъде разположен под. С други думи, резултатът от работата на kube-scheduler е името на нодата, което той връща на API-сървъра на запитването за планиране и на това неговата работа свършва.
Първо, kube-scheduler изготвя списък на нодите, на които може да бъде планиран под в съответствие с политиките predicates. След това всяка нода от този списък получава определено количество точки в съответствие с политиките priorites. В резултат се избира нода, натрупала максимален брой точки. Ако има ноди, натрупали еднакъв максимален брой точки, се избира случайна. Списъкът и описанието на политиките predicates (филтриране) и priorites (оценяване) могат да бъдат намерени в .
Описание на проблема
Въпреки голямото количество различни Kubernetes клъстери, с които се занимаваме в Nixys, за първи път срещнахме проблема с планирането на подове само наскоро, когато за един от нашите проекти възникна необходимостта от стартиране на голям брой периодични задачи (~100 единици CronJob). За да опростим максимално описанието на проблема, като пример ще вземем един микросервис, в рамките на който всяка минута се стартира cron-задание, създаващо натоварване на CPU. За работа на cron-заданието бяха отделени три абсолютно еднакви по характеристики ноди (по 24 vCPU на всяка).
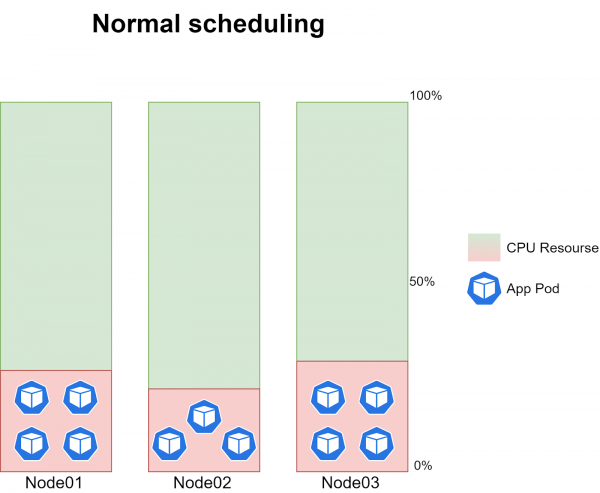
Въпреки това не може да се каже с точност колко време ще отнеме изпълнението на CronJob, тъй като обемът на входящите данни постоянно се променя. В среда на нормална работа на kube-scheduler, на всяка нода работят 3-4 екземпляра на задачата, които генерират около 20-30% натоварване на CPU на всяка нода:
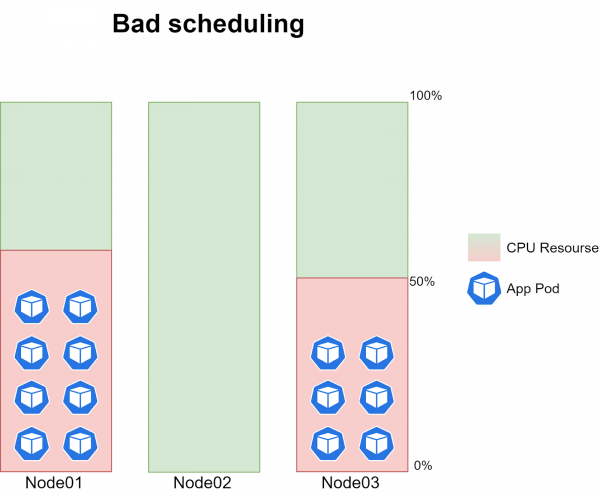
Проблемът сам по себе си е, че понякога подовете на cron-задачите не се планират на една от трите ноди. Тоест, в определен момент на времето на една от нодите не се е планирал нито един под, докато на другите две ноди работят по 6-8 екземпляра на задачата, създавайки около 40-60% натоварване на CPU:
Проблемът се повтаряше с абсолютно случайна периодичност и понякога корелираше с момента на пускане на нова версия на кода.
Увеличавайки нивото на логиране на kube-scheduler до 10-то ниво (-v=10), започнахме да фиксираме колко точки получава всяка от нодите в процеса на оценка. При нормална работа на планирането в логовете можеше да се види следната информация:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 -> Score 100043
generic_scheduler.go:781] Host Node02 -> Score 100043
generic_scheduler.go:781] Host Node03 -> Score 100043
Тоест, съдейки по информацията, получена от логовете, всяка от нодовете е набрала равно количество окончателни точки и за планирането е избирана случайна. В момента на проблемното планиране логовете изглеждаха по следния начин:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1587 millicores 4581125120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1087 millicores 3532549120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1587 millicores 4581125120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 987 millicores 3322833920 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 987 millicores 3322833920 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1087 millicores 3532549120 memory bytes, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 -> Score 100041
generic_scheduler.go:781] Host Node02 -> Score 100041
generic_scheduler.go:781] Host Node01 -> Score 100038
От което става ясно, че един от възлите е получил по-малко точки от останалите, и поради това планирането е било извършено само на двата възла, получили максимален брой точки. По този начин ние уверено установихме, че проблемът е в планирането на подовете.
Следващият алгоритъм за решаване на проблема беше очевиден за нас — да анализираме логовете, да разберем по какъв точно приоритет възелът не е набрал точки и, при необходимост, да коригираме политиките на дефолтния kube-scheduler. Въпреки това, тук се сблъскахме с две значителни трудности:
- На максимално ниво на логиране (10) се отразява само набор от точки по някои приоритети. В приложеното по-горе откъсче от логовете може да се забележи, че по всички приоритети, отразени в логовете, възлите получават едно и също количество точки при нормално и проблемно планиране, но крайният резултат в случай на проблемно планиране е различен. Следователно, можем да заключим, че по някои приоритети изчисляването на точките се извършва зад кулисите
- и ние нямаме никаква възможност да разберем по какъв именно приоритет възелът не е натрупал точки. Тази проблема е подробно описана в репозитория Kubernetes на Github. Към момента на написване на статията беше полученият отговор от разработчиците, че поддръжката на логиране ще бъде добавена в обновленията на Kubernetes v1.15, v1.16 и v1.17. .
Няма прост начин да разберете с какъв конкретен набор от политики в момента работи kube-scheduler. Да, в този списък е изброен, но в него няма информация за конкретните тежести, зададени на всяка от политиките. Да видите тежестите или да редактирате политиките на дефолтния kube-scheduler е възможно само в . Трябва да се отбележи, че един път успяхме да установим, че възелът не е натрупал точки по политиката ImageLocalityPriority, която начислява точки на възела, ако на него вече има образ, необходим за стартиране на приложението. Тоест, в момента на издаването на новата версия на приложението, cron-задачата успяваше да се стартира на два възла, изтегляйки нов образ от docker registry, и по този начин двата възла получаваха по-висок крайния счет от третия.
Както вече споменах, в логовете не виждаме информация за оценката на политиката ImageLocalityPriority, затова, за да проверим предположението си, заредихме образ с новата версия на приложението на третия възел, след което планирането заработи коректно. Именно поради политиката ImageLocalityPriority, проблемът с планирането се наблюдаваше сравнително рядко, по-често той беше свързан с нещо друго. Понеже не можехме да дебъгваме всяка от политиките в списъка с приоритети на дефолтния kube-scheduler, възникна необходимост от гъвкаво управление на политиките за планиране на подовете.
Формулиране на задачата
Искахме решението на проблема да бъде колкото се може по-точно, тоест основните същности на Kubernetes (тук се има предвид дефолтният kube-scheduler) да останат непроменени. Не ни се искаше да решаваме проблема на едно място и да го създаваме на друго. Така стигнахме до две възможности за решаване на проблема, които бяха представени в уводната част на статията — създаване на допълнителен scheduler или написване на свой собствен. Основното изискване за планирането на cron-заданията е равномерното разпределение на натоварването по трите възли. Това изискване може да бъде удовлетворено с вече съществуващите политики на kube-scheduler, така че за решаването на нашия проблем няма смисъл да пишем собствен scheduler.
Инструкцията за създаване и внедряване на допълнителен kube-scheduler е описана в . Все пак, на нас ни се стори, че съществуването на Deployment не е достатъчно, за да се осигури отказоустойчивостта на такъв критичен сервис като kube-scheduler, затова решихме да разположим нов kube-scheduler като Static Pod, който ще бъде наблюдаван директно от Kubelet. Така формулирахме следните изисквания към новия kube-scheduler:
- Сервизът трябва да бъде разположен като Static Pod на всички мейнтъри на клъстера.
- Трябва да бъде предвидена отказоустойчивост в случай на недостъпност на активния pod с kube-scheduler.
- Основен приоритет при планирането трябва да бъде количеството налични ресурси на възела (LeastRequestedPriority).
Реализация на решението
Веднага трябва да отбележим, че всички работи ще проведем в Kubernetes v1.14.7, тъй като именно тази версия е използвана в проекта. Ще започнем с написването на манифеста за нашия нов kube-scheduler. За основа ще вземем манифеста на дефолтния (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) и ще го приведем в следния вид:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Кратко за основните промени:
- Сменихме името на пода и контейнера на kube-scheduler-cron
- Указахме използването на портовете 10151 и 10159, тъй като е зададена опция
hostNetwork: trueи не можем да използваме същите портове, които е дефинирал стандартния kube-scheduler (10251 и 10259) - С помощта на параметъра --config указахме конфигурационен файл, с който трябва да бъде стартиран сервизът
- Настроихме монтиране на конфигурационния файл (scheduler-custom.conf) и файла с политики за планиране (scheduler-custom-policy-config.json) от хоста
Не забравяме, че нашият kube-scheduler ще изисква права, аналогични на тези на стандартния. Редактираме неговата роля в клъстера:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Сега да поговорим за съдържанието на конфигурационния файл и файла с политики за планиране:
- Конфигурационен файл (scheduler-custom.conf)
За да получим конфигурацията на стандартния kube-scheduler, е необходимо да използваме параметъра--write-config-toот . Получената конфигурация ще сложим в файла /etc/kubernetes/scheduler-custom.conf и ще я приведем в следния вид:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Кратко за основните промени:
- Задайте в schedulerName името на нашата услуга kube-scheduler-cron.
- В параметъра
lockObjectNameсъщо е необходимо да зададете името на нашата услуга и да се уверите, че параметърътleaderElectе зададен на true (ако имате само една майсторска нода, можете да зададете false). - Указахме пътя до файла с описания на политиките за планиране в параметъра
algorithmSource.
Нека да се спрем по-подробно на втория пункт, където редактираме параметрите за ключа leaderElection. За да осигурим отказоустойчивост, активирахме (leaderElect) процеса на избор на лидер (майстор) между подовете на нашия kube-scheduler, използвайки единен endpoint (resourceLock) с името kube-scheduler-cron (lockObjectName) в пространството имена kube-system (lockObjectNamespace). За това как Kubernetes осигурява висока достъпност на основните компоненти (включително kube-scheduler) можете да се запознаете с .
- Файлът с политиките за планиране (scheduler-custom-policy-config.json)
Както вече споменах, разберем с какви точно политики работи дефолтният kube-scheduler, можем само чрез анализ на неговия код. Тоест, не можем да получим файл с политиките за планиране на дефолтния kube-scheduler, както за файла с конфигурация. Ще опишем интересуващите ни политики за планиране в файла /etc/kubernetes/scheduler-custom-policy-config.json по следния начин:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Следовательно, kube-scheduler първо съставя списък с нодове, на които можем да планираме под в съответствие с политиката GeneralPredicates (която включва набор от политики PodFitsResources, PodFitsHostPorts, HostName и MatchNodeSelector). След това се оценява всяка нода според набора от политики в масива priorities. За да постигнем целите на нашата задача, считаме, че този набор политици ще бъде оптималното решение. Напомням, че наборът от политики с подробното им описание е наличен в . За да изпълните задачата си, можете просто да промените набора от използвани политики и да им зададете съответните тегла.
Манифестът на новия kube-scheduler, който създадохме в началото на главата, ще наречем kube-scheduler-custom.yaml и ще го поставим на следния път /etc/kubernetes/manifests на трите мастер-нодове. Ако всичко е правено правилно, Kubelet на всяка нода ще стартира пода, а в логовете на нашия нов kube-scheduler ще видим информация, че нашият файл с политики успешно е приложен:
Създаване на планировчик от конфигурация: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Регистриране на предикат: GeneralPredicates
Предикат тип GeneralPredicates вече е регистриран, повторно използване.
Регистриране на приоритет: ServiceSpreadingPriority
Приоритет тип ServiceSpreadingPriority вече е регистриран, повторно използване.
Регистриране на приоритет: EqualPriority
Приоритет тип EqualPriority вече е регистриран, повторно използване.
Регистриране на приоритет: LeastRequestedPriority
Приоритет тип LeastRequestedPriority вече е регистриран, повторно използване.
Регистриране на приоритет: NodePreferAvoidPodsPriority
Приоритет тип NodePreferAvoidPodsPriority вече е регистриран, повторно използване.
Регистриране на приоритет: NodeAffinityPriority
Приоритет тип NodeAffinityPriority вече е регистриран, повторно използване.
Създаване на планировчик с подходящи предположения 'map[GeneralPredicates:{}]' и функции за приоритет 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Сега остава само да посочите в спецификацията на нашата CronJob, че всички заявки за планиране на нейните подове трябва да се обработват от нашия нов kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Заключение
В крайна сметка получихме допълнителен kube-scheduler с уникален набор от политики за планиране, работата на който наблюдава директно kubelet. Освен това настроихме избор на нов лидер между подовете на нашия kube-scheduler в случай, че старият лидер по някаква причина стане недостъпен.
Обичайните приложения и услуги продължават да се планират чрез стандартния kube-scheduler, докато всички cron-задачи са напълно преместени на новия. Натоварването, генерирано от cron-задачите, сега се разпределя равномерно между всички нодове. Като се има предвид, че голяма част от cron-задачите се изпълняват на същите нодове, на които са основните приложения на проекта, това позволи значително да се намали рискът от преместване на подовете поради недостиг на ресурси. След внедряването на допълнителен kube-scheduler, проблемите с неравномерното планиране на cron-задачите вече не възникваха.
Също така прочетете и други статии в нашия блог:
Източник: habr.com
