

През годините на съществуване на Pinterest 300 милиона потребители на услугата създадоха повече от 200 милиарда пина на повече от 4 милиарда дъски. За да обслужва тази армия потребители и обширна база от съдържание, порталът разработи хиляди услуги, от микросервизи, с които може да се справи няколко CPU, до огромни монолити, които работят на цял парк виртуални машини. И ето, настъпи моментът, в който погледът на компанията падна върху k8s. Какво точно привлече .
И така, стотици милиони потребители и стотици милиарди пина. За да обслужим тази армия потребители и обширната база от съдържание, ние разработихме хиляди услуги, от микросервизи, с които може да се справи няколко CPU, до огромни монолити, които работят на цял парк виртуални машини. Освен това, имаме разнообразие от фреймворкове, които също могат да изискват ресурси CPU, памет или достъп до операции за вход-изход.
В хода на поддръжката на този зоопарк от инструменти, екипът по разработка се сблъсква с редица проблеми:
- Инженерите нямат унифициран начин за стартиране на работна среда. Stateless услуги, Stateful услуги и проекти в активна разработка се основават на напълно различни технологични стекове. Това доведе до създаването на цял обучителен курс за инженерите и сериозно усложнява работата на нашия инфраструктурен екип.
- Разработчици, разполагащи със собствен парк от виртуални машини, създават огромна натовареност на вътрешните администратори. В резултат на това, такива прости операции, като ъпдейт на ОС или AMI, се разтягат на седмици и месеци. Това води до увеличение на натоварването в, на пръв поглед, напълно ежедневни ситуации.
- Трудности при създаването на глобални инструменти за управление на инфраструктурата върху вече съществуващи решения. Ситуацията се усложнява и от факта, че намирането на собствениците на виртуални машини не е лесно. Тоест не знаем дали може безопасно да изтеглим тези ресурси за работа на други участъци от нашата инфраструктура.
Контейнерните системи за оркестрация обединяват управлението на работни натоварвания. Те ви предоставят възможност да ускорите разработката и опростят управлението на инфраструктурата, тъй като всички ресурси, участващи в проекта, се управляват от една централизирана система.
Фигура 1: Приоритети на инфраструктурата (надеждност, производителност на разработчиците и ефективност).
Екипът по управление на облачни платформи в Pinterest се запозна с K8s през 2017 година. До първата половина на 2017 документirахме голяма част от нашите производствени ресурси, включително API и всички наши уеб сървъри. След това извършихме внимателна оценка на различни системи за оркестрация на контейнерни решения, изграждане на клъстери и работа с тях. В края на 2017 решихме да използваме Kubernetes. Той бе достатъчно гъвкав и широко поддържан в разработващата общност.
Към момента сме създали собствени инструменти за първоначално зареждане на клъстера, базирани на Kops, и преместихме в Kubernetes съществуващите компоненти на инфраструктурата — като мрежа, сигурност, метрики, водене на дневници, управление на идентичността и трафика. Също така реализирахме система за моделиране на работни натоварвания за нашия ресурс, сложността на която е скрита от разработчиците. Сега сме фокусирани върху осигуряване на стабилност на клъстера, неговото мащабиране и свързване на нови клиенти.
Kubernetes: Пътят на Pinterest
Започването на работа с Kubernetes в мащабите на Pinterest като платформа, която ще бъде обичана от нашите инженери, доведе до множество трудности.
Като голяма компания вложихме значителни средства в инфраструктурни инструменти. Пример за това са инструментите за сигурност, които обработват сертификати и разпределят ключове, компоненти за контрол на трафика, системи за откриване на услуги, компоненти за видимост, изпращане на дневници и метрики. Всичко това не беше събрано случайно: преминахме през нормален процес на опити и грешки, и затова искахме да интегрираме всичките тези неща в новата инфраструктура на Kubernetes, вместо да изобретяваме стария велосипед на нова платформа. Този подход генерално опрости миграцията, тъй като цялата поддръжка на приложенията вече съществува, няма нужда да бъде създавана от нулата.
От друга страна, моделите за прогнозиране на натоварвания в самия Kubernetes (например, разгръщания, задачи и набори Daemon) не са достатъчни за нашия проект. Тези проблеми с употребата представляват огромни прегради при преминаването към Kubernetes. Например, чухме как разработчици на услуги се оплакват от липсата или неправилното конфигуриране на входа. Също така срещнахме неправилно използване на шаблонизаторите, когато се създаваха стотици копия с идентична спецификация и задача, което водеше до ужасни проблеми с отстраняването на грешки.
Освен това беше много трудно да се поддържат различни версии в един и същи кластер. Представете си сложността на клиентската поддръжка, ако трябва да работите с множество версии на една и съща среда за изпълнение, с всичките им проблеми, бъгове и актуализации.
Потребителски ресурси и контролери на Pinterest
За да улесним процеса на внедряване на Kubernetes за нашите инженери, както и за да опростим инфраструктурата и да ускорим нейното функциониране, ние разработихме нашите собствени определения на потребителски ресурси (CRD).
CRD предлагат следните функционални възможности:
- Обединяване на различни нативни ресурси на Kubernetes, за да функционират като единично натоварване. Например, ресурсът PinterestService включва разгръщане, услуга за вход и конфигурационна карта. Това позволява на разработчиците да не се притесняват за конфигурирането на DNS.
- Внедряване на необходимата поддръжка на приложения. Потребителят трябва да се съсредоточи само върху спецификацията на контейнера в съответствие с бизнес логиката си, докато контролерът CRD внедрява всички необходими init-контейнери, променливи на средата и спецификации на pod. Това осигурява коренно различно ниво на комфорт за разработчиците.
- Контролерите CRD също управляват жизнения цикъл на собствените ресурси и увеличават достъпността на отстраняването на грешки. Това включва съгласуване на желаните и реалните спецификации, актуализиране на статуса на CRD и водене на логове на събития и не само. Без CRD разработчиците биха били принудени да управляват многобройни набори от ресурси, което само увеличава вероятността за грешки.
Ето пример на PinterestService и вътрешен ресурс, който се управлява от нашия контролер:
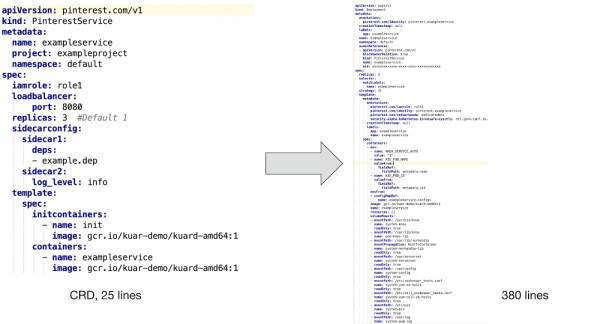
Както беше споменато по-горе, за да поддържаме потребителски контейнер, трябва да интегрираме в него контейнер за инициализация и няколко добавки, за да осигурим безопасността, видимостта и работата с мрежовия трафик. Освен това създадохме шаблони за конфигурационни карти и реализирахме поддръжка на PVC шаблони за партидни задания, както и проследяване на множество променливи среди за наблюдение на идентификацията, потреблението на ресурси и събиране на "боклук".
Трудно е да си представим, че разработчиците биха искали да напишат тези конфигурационни файлове ръчно без поддръжка на CRD, да не говорим за по-нататъшната поддръжка и отстраняване на проблеми с конфигурациите.
Работен поток за разполагане на приложения
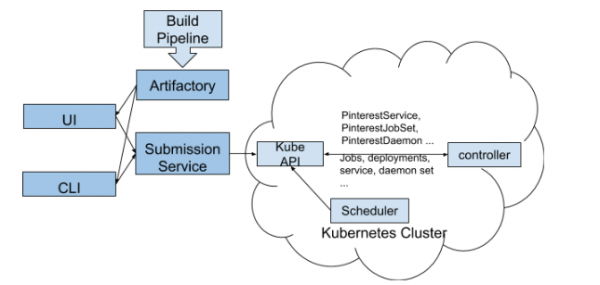
На изображението по-горе е показано как да разположите потребителски ресурс Pinterest в кластер на Kubernetes:
- Разработчиците взаимодействат с нашия кластер Kubernetes чрез CLI и потребителски интерфейс.
- CLI / UI инструментите извлечат YAML-файлове за конфигурация на работния поток и други свойства на сборката (същият идентификатор на версията) от Artifactory, след което ги изпращат на Услугата за подаване на задания. Тази стъпка гарантира, че в кластера ще бъдат внедрени само работещи версии.
- JSS е шлюз за различни платформи, включително Kubernetes. Тук се извършва аутентификация на потребителя, разпределяне на квоти и частична проверка на конфигурацията на нашето CRD.
- След проверката на CRD от страна на JSS информацията се изпраща на API-то на платформата k8s.
- Нашият CRD контролер проследява събитията на всички потребителски ресурси. Той преобразува CR в нативни ресурси на k8s, добавя необходимите модули, задава съответните променливи среди и изпълнява друга помощна работа, което гарантира, че контейнерните потребителски приложения получават достатъчна инфраструктурна поддръжка.
- След това контролерът на CRD предава получените данни на API-то на Kubernetes, за да бъдат обработени от планировчика и стартирани.
Забележка: Това предрелийз работен поток за внедряване беше създаден за първите потребители на новата k8s платформа. В момента сме в процес на усъвършенстване на този процес, за да се интегрираме напълно с новата си CI/CD. Това означава, че не можем да споделим всичко, свързано с Kubernetes. Очакваме с нетърпение възможността да споделим нашия опит и да разкажем за напредъка на екипа в това направление в следващата ни блог публикация „Създаване на CI/CD платформа за Pinterest.“
Видове специализирани ресурси
На базата на конкретните нужди на Pinterest, разработихме следните CRD, които са подходящи за различни работни потоци:
- PinterestService — това са дългосрочни stateless услуги. Многобройни основни системи се основават на набор от такива услуги.
- PinterestJobSet моделира пакетни задания с пълен цикъл. В Pinterest има разпространен сценарий, при който няколко задания стартират едни и същи контейнери паралелно, независимо от други подобни процеси.
- PinterestCronJob широко се използва за малки периодични натоварвания. Това е обвивка за нативната работа cron с механизми за поддръжка на Pinterest, отговарящи за сигурността, трафика, логовете и метриките.
- PinterestDaemon включва инфраструктурни Daemon-и. Това семейство продължава да расте, тъй като добавяме все повече поддръжка за нашите клъстери.
- PinterestTrainingJob обхваща процеси на Tensorflow и Pytorch, осигурявайки същото ниво на поддръжка по време на работа, както и всички други CRD. Тъй като Pinterest активно използва Tensorflow и други системи за машинно обучение, имаме основание да изградим отделен CRD около тях.
Също така работим върху PinterestStatefulSet, който скоро ще бъде адаптиран за хранилища данни и други stateful системи.
Поддръжка на изпълнителна среда
Когато модулът на приложението се стартира в Kubernetes, той автоматично получава сертификат за идентификация на себе си. Този сертификат се използва за достъп до хранилище на секрети или за комуникация с други услуги чрез mTLS. В същото време конфигуриращият инициализатор на контейнери и Daemon зареждат всички необходими зависимости преди стартирането на контейнерното приложение. Когато всичко е готово, трафикът на sidecar и Daemon регистрират IP адреса на модула в нашия Zookeeper, за да могат клиентите да го открият. Всичко това ще работи, тъй като мрежовият модул беше настроен преди стартирането на приложението.
По-горе са дадени типични примери за поддръжка на работни натоварвания по време на изпълнение. За други типове работни натоварвания може да е необходима малко различна поддръжка, но всички те са представени под формата на sidecar на ниво pod, възлови или Daemon-и на ниво виртуални машини. Ние се грижим всичко това да бъде разположено в рамките на управляващата инфраструктура и да бъде координирано между приложенията, което в крайна сметка значително намалява натоварването по отношение на техническите работи и поддръжката на клиентите.
Тестване и QA
Събрахме end-to-end тестов конвейер върху вече съществуващата тестова инфраструктура на Kubernetes. Тези тестове се разпространяват върху всички наши клъстери. Нашият пайплайн преживя множество преустройства преди да стане част от продуктовия клъстер.
Освен системите за тестване, ние имаме системи за мониторинг и известяване, които постоянно следят състоянието на компонентите на системата, консумацията на ресурси и други важни показатели, уведомявайки ни само при необходимост от човешка намеса.
Алтернативи
Разгледахме някои алтернативи на персонализирани ресурси, като мутационни контролери за достъп и системи за шаблони. Въпреки това, всички те са свързани с сериозни трудности в работата, затова избрахме пътя на CRD.
Мутиралия контролер за достъп беше използван за въвеждане на сайдкари, променливи на средата и друга поддръжка по време на изпълнението. Все пак той се сблъскваше с различни проблеми, например, с свързването на ресурси и управлението на техния жизнен цикъл, докато в CRD такива проблеми не възникват.
Бележка: Шаблонните системи, като диаграмите на Helm, също се използват широко за стартиране на приложения с подобни конфигурации. Обаче нашите работни приложения са твърде разнообразни, за да бъдат управлявани с шаблони. Също така, по време на непрекъснато разгръщане, използването на шаблони ще предизвика твърде много грешки.
Предстояща работа
Сега се справяме със смесена натовареност на всички наши клъстери. За да поддържаме подобни процеси с различен тип и размер, работим в следните направления:
- Сборът от клъстери разпределя големи приложения между различни клъстери, за да осигури мащабируемост и стабилност.
- Осигуряване на стабилност, мащабируемост и видимост на клъстера за създаване на връзка между приложението и неговото SLA.
- Управление на ресурсите и квотите, така че приложенията да не конфликтуват помежду си, а мащабът на клъстера да се контролира от наша страна.
- Нова платформа CI/CD за поддръжка и разгръщане на приложения в Kubernetes.
Източник: habr.com
