

Анонс
Колеги, през средата на лятото планирам да публикувам още един цикъл от статии за проектиране на системи за масово обслужване: “Експеримент VTrade” — опит да напиша фреймуърк за търговски системи. В цикъла ще бъдат разгледани теорията и практиката на изграждането на борса, аукцион и магазин. В края на статията предлагам да гласувате за най-интерсните за вас теми.
Това е финалната статия от цикъла за разпределени реактивни приложения на Erlang/Elixir. В можете да намерите теоретичните основи на реактивната архитектура. илюстрира основните шаблони и механизми за изграждане на подобни системи.
Днес ще повдигнем въпросите за развитието на кодовата база и проектите като цяло.
Организация на услугите
В реалния живот при разработката на услуга често е необходимо да се комбинират няколко шаблона за взаимодействие в един контролер. Например, услугата users, която се занимава с управлението на профилите на потребителите в проекта, трябва да отговаря на заявки req-resp и да съобщава за актуализации на профилите чрез pub-sub. Този случай е доста прост: за messaging стои един контролер, който реализира логиката на услугата и публикува актуализации.
Ситуацията се усложнява, когато е необходимо да реализираме отказоустойчив разпределен сервиз. Да предположим, че изискванията към users са се променили:
- сега услугата трябва да обработва заявки на 5 възела в клъстера,
- да има възможност за изпълнение на фонови задачи по обработка,
- както и да може динамично да управлява списъците за абонамент за актуализации на профилите.
Забележка: Не разглеждаме въпроса за консистентното съхранение и репликация на данни. Нека предположим, че тези въпроси са решени по-рано и в системата вече съществува надежден и мащабируем слой на съхранение, а обработчиците имат механизми за взаимодействие с него.
Формалното описание на услугата users стана по-сложно. От гледна точка на програмиста, благодарение на използването на messaging, промените са минимални. За да удовлетворим първото изискване, трябва да настроим балансировка на точката за обмен req-resp.
Честото се появява необходимостта от обработка на фонови задачи. В users това могат да бъдат проверки на документите на потребителите, обработка на качените мултимедийни файлове или синхронизация на данни със социални мрежи. Тези задачи трябва да бъдат разпределени в рамките на клъстера и контролирани. Затова имаме два варианта за решение: или да използваме шаблона за разпределение на задачи от предишната статия, или, ако той не подхожда, да напишем персонализиран планировчик на задачи, който да управлява пуловете от обработващи единици по необходимия начин.
Точка 3 изисква разширение на шаблона pub-sub. За да го реализираме, след създаването на точката на обмен pub-sub, трябва допълнително да стартираме контролера на тази точка в рамките на нашия сервис. По този начин сякаш изнасяме логиката за обработка на абонаменти и отписвания от слоя messaging в реализацията users.
В крайна сметка, декомпозицията на задачата показа, че за да отговорим на изискванията, е необходимо да стартираме 5 инстанции на сервиса на различни възли и да създадем допълнителна единица – контролер pub-sub, отговорен за абонамента.
Не е необходимо да променяме кода на сервиса, за да стартираме 5 обработващи единици. Единственото допълнително действие е настройването на правилата за балансировка на точката на обмен, за което ще говорим малко по-късно.
Също така се появява допълнителна сложност: контролерът pub-sub и персонализираният планировчик на задачи трябва да работят в единствено число. Отново, сервисът messaging, като основен, трябва да предоставя механизъм за избор на лидер.
Избор на лидер
В разпределените системи, изборът на лидер е процедура за назначаване на единствен процес, отговорен за планирането на разпределената обработка на натоварването.
В системи, които не са склонни към централизиране, се използват универсални алгоритми и алгоритми на основата на консенсус, например Paxos или Raft.
Тъй като messaging е брокер и централен елемент, той знае за всички контролери на услугата – кандидатите за лидер. Messaging може да назначава лидер без провеждане на гласуване.
Всички услуги след стартиране и свързване с точката на обмен получават системно съобщение #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. В случай, че LeaderPid отговаря на pid текущия процес, той бива назначен за лидер, а списъкът Servers включва всички възли и техните параметри.
Когато се появи нова и се изключи работеща възел на клъстера, всички контролери на услугата получават #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} и #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} съответно.
Така всички компоненти знаят за всички промени, и в клъстера по всяко време е гарантиран един лидер.
Променливи
За реализация на сложни разпределени процеси на обработка, както и в задачите по оптимизация на вече съществуващата архитектура, е удобно да се използват посредници.
За да не променяте кода на услугите и да решавате, например, задачи за допълнителна обработка, маршрутизация или логиране на съобщения, пред услугата можете да включите прокси обработчик, който ще извърши цялата допълнителна работа.
Класическият пример за оптимизация на pub-sub е разпределено приложение с бизнес ядро, генериращо събития за обновление, например промяна на цената на пазара, и слой на достъп — N сървъра, предоставящи websocket API за уеб клиенти.
Ако решавате "отпред", то обслужването на клиента изглежда по следния начин:
- клиентът установява връзки с платформата. От страната на сървъра, който прекратява трафика, започва процес, обслужващ това подключение.
- в контекста на обслужващия процес се извършва авторизация и абониране за обновления. Процесът извиква метода subscribe за темите.
- след генерирането на събитието в ядрото, то се доставя на процесите, обслужващи връзките.
Нека си представим, че имаме 50000 абонати на темата "новини". Абонатите са равномерно разпределени по 5 сървъра. В резултат на това всяко обновление, достигнало до точката за обмен, ще бъде репликирано 50000 пъти: 10000 пъти на всеки сървър, в зависимост от броя на абонатите на него. Не е точно ефективна схема, нали?
За да подобрим ситуацията, ще въведем прокси, което има същото име като точката за обмен. Регистраторът на глобални имена трябва да може да връща най-близкия процес по име, което е важно.
Ще стартираме този прокси на сървърите на слоя за достъп, и всички наши процеси, обслужващи websocket API, ще се абонират за него, а не за оригиналната pub-sub точка за обмен в ядрото. Прокси се абонира за ядрото само в случай на уникална абонация и репликира полученото съобщение на всичките си абонати.
В крайна сметка между ядрото и сървърите за достъп ще бъдат прехвърлени 5 съобщения, вместо 50000.
Маршрутизация и балансировка
Req-Resp
В текущата реализация на messaging съществуват 7 стратегии за разпределение на заявките:
по подразбиране. Запитът се изпраща на всички контролери.round-robin. Извършва се перебор и циклично разпределение на запитванията между контролерите.консенсус. Контролерите, обслужващи услугата, се делят на лидер и последователи. Запитванията се изпращат само на лидера.консенсус & рунд-робин. В групата има лидер, но запитванията се разпределят между всички членове.постоянен. Изчислява се хеш функция и тя се закрепва за определен обработчик. Последващите запитвания с тази сигнатура попадат при същия обработчик.постоянен-функция. При инициализацията на обменната точка допълнително се предава функция за изчисление на хеш запостояненбалансиране.забавление. Аналогично на постоянен-функция, само че допълнително може да се пренасочи, отклони или предобработи.
Стратегията за разпределение се задава при инициализацията на обменната точка.
Освен балансирането, messaging позволява тагиране на единици. Необходимо е да разгледаме видовете тагове в системата:
- Таг за свързване. Позволява да се разбере, през коя връзка са дошли събитията. Използва се, когато процесът на контролера се свързва с една обменна точка, но с различни маршрутизационни ключове.
- Таг на услугата. Позволява за една услуга да групира обработчиците и да разширява възможностите за маршрутизиране и балансиране. За модела req-resp маршрутизацията е линейна. Изпращаме запитване на обменната точка, след това тя го предава на услугата. Но ако трябва да разделим обработчиците на логически групи, разбиването се осъществява чрез таговете. При посочване на таг, запитването ще бъде насочено към конкретна група контролери.
- Таг за запитването. Позволява да се различават отговорите. Тъй като нашата система е асинхронна, за обработка на отговорите на услугата трябва да имаме възможност да посочим RequestTag при изпращане на запитването. По него ще можем да разберем на кое запитване е отговорено.
Pub-sub
За pub-sub всичко е малко по-просто. Имаме обменна точка, на която се публикуват съобщения. Обменната точка разпределя съобщенията между абонатите, които са се абонирали за нужните им маршрутизационни ключове (може да се каже, че това е аналог на темите).
Масштабируемост и устойчивост на откази
Масштабируемостта на системата като цяло зависи от степента на мащабируемост на слоевете и компонентите на системата:
- Услугите се мащабират чрез добавяне на допълнителни възли с обработчици на услугата в клъстера. По време на експерименталната експлоатация може да се избере оптимална политика за балансиране.
- Самата услуга messaging в рамките на отделен клъстер обикновено се мащабира или чрез преместване на особено натоварени точки за обмен на отделни възли на клъстера, или чрез добавяне на proxy процеси в особено натоварените зони на клъстера.
- Мащабируемостта на цялата система като характеристика зависи от гъвкавостта на архитектурата и възможността за обединяване на отделни клъстери в обща логическа единица.
От простотата и скоростта на мащабиране често зависи успехът на проекта. Messaging в текущото си изпълнение расте заедно с приложението. Дори ако ни липсват клъстери от 50-60 машини, може да се прибегне до федерация. За съжаление, темата за федерацията излиза извън рамките на тази статия.
Резервиране
При разглеждане на балансирането на натоварването вече обсъждахме резервирането на контролерите на услугите. Въпреки това messaging също трябва да бъде резервиран. В случай на падение на възел или машина, messaging трябва автоматично да се възстанови, и то в най-кратки срокове.
В проектите си използвам допълнителни възли, които поемат натоварването в случай на падение. В Erlang съществува стандартна реализация на разпределен режим за приложения OTP. Разпределеният режим, както точно осъществява възстановяване в случай на срив, стартира падналото приложение на друг предварително стартиран възел. Процесът е прозрачен, след срив приложението автоматично преминава на failover възел. Можете да прочете повече за тази функционалност. .
Производителност
Нека опитаме поне приблизително да сравним производителността на rabbitmq и нашия кастомизиран messaging.
Намерих от тестовете на rabbitmq от екипа на openstack.
В точка 6.14.1.2.1.2.2. от оригиналния документ е представен резултатът от RPC CAST:
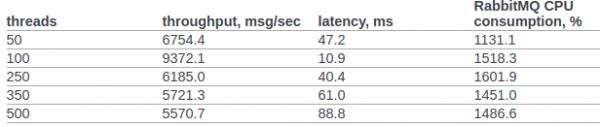
Предварително няма да правим допълнителни настройки в ядрото на ОС или erlang VM. Условия за теста:
- erl opts: +A1 +sbtu.
- Тестът в рамките на един възел erlang се стартира на лаптоп с остарял i7 в мобилно изпълнение.
- Клъстерните тестове се провеждат на сървъри с 10G мрежа.
- Кодът работи в docker контейнери. Мрежата е в режим NAT.
Код на теста:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Сценарий 1: Тестът се провежда на лаптоп с остарял мобилен i7. Тестовете, messaging и услугата работят на един възел в един docker контейнер:
Последователни 10000 цикъла за ~0 секунди (26987 цикъла/с)
Последователни 20000 цикъла за ~1 секунда (26915 цикъла/с)
Последователни 100000 цикъла за ~4 секунди (26957 цикъла/с)
Паралелни 2 100000 цикъла за ~2 секунди (44240 цикъла/с)
Паралелни 4 100000 цикъла за ~2 секунди (53459 цикъла/с)
Паралелни 10 100000 цикъла за ~2 секунди (52283 цикъла/с)
Паралелни 100 100000 цикъла за ~3 секунди (49317 цикъла/с)
Сценарий 2: 3 възела, стартирани на различни машини под docker (NAT).
Последователни 10000 цикъла за ~1 секунда (8684 цикъла/с)
Последователни 20000 цикъла за ~2 секунди (8424 цикъла/с)
Последователни 100000 цикъла за ~12 секунди (8655 цикъла/с)
Паралелни 2 100000 цикъла за ~7 секунди (15160 цикъла/с)
Паралелни 4 100000 цикъла за ~5 секунди (19133 цикъла/с)
Паралелни 10 100000 цикъла за ~4 секунди (24399 цикъла/с)
Паралелни 100 100000 цикъла за ~3 секунди (34517 цикъла/с)
Във всички случаи, използването на CPU не надвишава 250%
Итог
Надявам се този цикъл да не изглежда като излив на съзнание и моят опит да донесе реална полза както на изследователите на разпределени системи, така и на практиците, които са в самото начало на изграждането на разпределени архитектури за своите бизнес системи и с интерес гледат на Erlang/Elixir, но се съмняват дали си струва...
Снимка
Само регистрирани потребители могат да участват в анкетата. , моля.
Кои теми трябва да разгледам по-подробно в рамките на цикъла “Експеримент VTrade”?
Теория: Пазари, поръчки и време на действие: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Книга на поръчките. Теория и практика на реализиране на книгата с групирането
Визуализация на търговията: Тикове, барове, резолюции. Как да съхранявате и как да свързвате
Бек офис. Планиране и разработване. Контрол на служителите и разследване на инциденти
API. Разглеждаме какви интерфейси са необходими и как да ги реализираме
Съхранение на информация: PostgreSQL, Timescale, Tarantool в търговските системи
Реактивност в търговските системи
Други. Ще напиша в коментарите
Гласуваха 6 потребители. Задържаха се 4 потребители.
Източник: habr.com
