

Въведение
В тази статия ще разгледам известния алгоритъм на Хафман и неговото приложение в компресирането на данни.
В резултат ще напишем простичък архиватор. За това вече имаше , но без практическа реализация. Теоретичният материал на текущия пост е взет от училищни уроци по информатика и книгата на Робърт Лафоре „Структури от данни и алгоритми на Java“. И така, всичко е под кат!
Някои размишления
В обикновен текстов файл един символ се кодира с 8 бита (кодировка ASCII) или 16 бита (кодировка Unicode). По-надолу ще разгледаме кодировката ASCII. За пример, нека вземем низ s1 = «SUSIE SAYS IT IS EASYn». В низa има общо 22 символа, разбира се, включително интервали и символа за нов ред — ‘n’. Файлът, съдържащ този низ, ще тежи 22*8 = 176 бита. Веднага възниква въпросът: рационално ли е да използваме всичките 8 бита за кодиране на 1 символ? Ние не използваме всички символи от кодировката ASCII. Дори да ги използвахме, би било по-рационално на най-често срещаната буква — S — да се даде най-краткият възможен код, а на най-редката буква — T (или U, или ‘n’) — да се даде по-дълъг код. В това и се състои алгоритъмът на Хафман: необходимо е да се намери оптимален вариант на кодиране, при който файлът ще бъде с минимално тегло. Съвсем нормално е, че различните символи могат да имат различна дължина на кода — на това се основава алгоритмът.
Кодиране
Защо да не дадем на символа ‘S’ код, примерно, с дължина 1 бит: 0 или 1. Нека това бъде 1. Тогава на втория най-често срещан символ — ‘ ‘(интервал) — даваме 0. Представете си, че сте започнали да декодирате своето послание — закодирания низ s1 — и виждате, че кодът започва с 1. И така, какво да правим: това символ S ли е, или е някой друг символ, например A? Затова възниква важно правило:
Нито един код не бива да бъде префикс на друг
Това правило е ключово в алгоритъма. Затова създаването на код започва с таблица на честотите, в която е посочена честотата (брой на появи) на всеки символ:
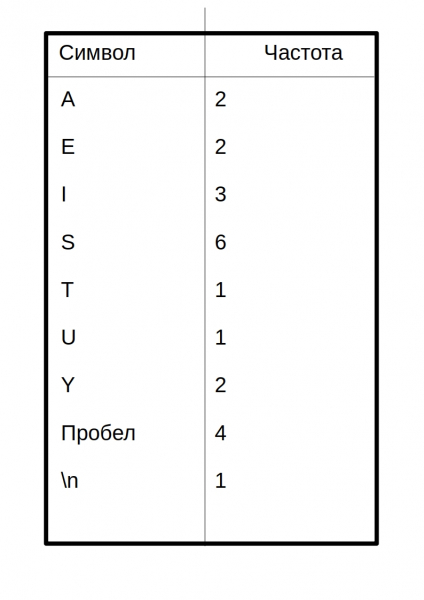 Символите с най-голямо количество появи трябва да се кодирани с най-малкия възможен брой битове. Давам пример за една от възможните таблици с кодове:
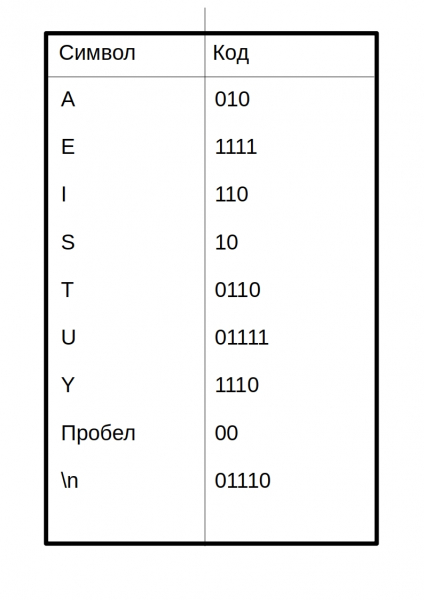 Така закодираното послание ще изглежда така:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Кодът на всеки символ отделих с интервал. В действителност в компресирания файл такова нещо няма да има!
Въпросът е: как този младеж измисли кода за създаване на таблица с кодове? За това ще говорим по-долу.
Построяване на Хафманово дърво
Тук в помощ идват двоичните дървета за търсене. Не се притеснявайте, тук не са необходими методи за търсене, вмъкване и изтриване. Ето структурата на дървото на Java:
public class Node {
    private int frequency;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Това не е пълният код, пълният код ще бъде по-долу.
Ето алгоритъма за построяване на дървото:
- Създайте обект Node за всеки символ от съобщението (стринга s1). В нашия случай ще има 9 възела (обекта Node). Всеки възел се състои от две полета данни: символ и честота.
- Създайте обект на дървото (BinaryTree) за всеки от възлите Node. Възелът става корен на дървото.
- Въведете тези дървета в приоритетната опашка. Колкото по-ниска е честотата, толкова по-висок е приоритетът. Така при извличане винаги се избира дървото с най-ниска честота.
След това циклично изпълнявайте следното:
- Извлечете два дървета от приоритетната опашка и направете ги потомци на нов възел (току-що създадения възел без буква). Честотата на новия възел е равна на сумата на честотите на двете дървета-потомци.
- За този възел създайте дърво с корен в посочения възел. Вкарайте това дърво обратно в приоритетната опашка. (Тъй като дървото има нова честота, вероятно то ще заеме ново място в опашката.)
- Продължавайте да изпълнявате стъпки 1 и 2, докато в опашката не остане само едно дърво — Хафмановото дърво.
Нека разгледаме този алгоритъм на стринга s1:
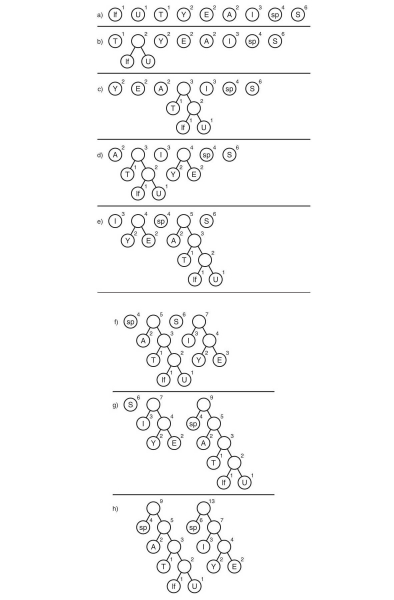
Тук символът «lf» (linefeed) обозначава преминаване на нов ред, а «sp» (space) — това е интервал.
Какво следва?
Получихме Хафманово дърво. Добре. И какво да правим с него? Дори безплатно няма да го вземат. А след това, трябва да проследим всички възможни пътища от корена до листата на дървото. Условно ще означим ребро 0, ако води към левия потомък и 1 — ако към десния. Строго казано, в тези обозначения, кодът на символа е пътят от корена на дървото до листа, съдържащ този символ.
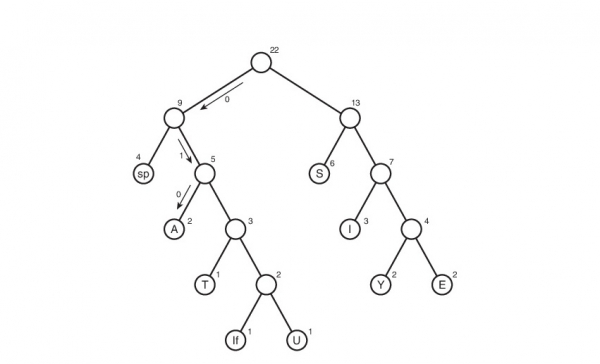
Така се получи таблица с кодове. Забележете, че ако разгледаме тази таблица, можем да направим извода за "тежестта" на всеки символ — това е дължината на кода му. Тогава в компресиран вид, оригиналният файл ще тежи: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 бита. Първоначално той тежеше 176 бита. Следователно, сме го намалили с 176/65 = 2.7 пъти! Но това е утопия. Такъв коефициент едва ли ще бъде получен. Защо? За това ще говорим по-късно.
Декодиране
Ами, остави ми просто — декодирането. Мисля, че много от вас се досетиха, че просто не можем да създадем компресиран файл без никакви намеци за това как е бил кодирано — няма да можем да го декодираме! Да, беше трудно да осъзная, но ще трябва да създам текстов файл table.txt с таблица за компресия:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Записването на таблицата в вида 'символ'«код на символа». Защо 01110 без символ? Всъщност той е с символ, просто средствата java, които използвах при записването във файла, символа за нов ред — 'n' -конвертира в нов ред (каквото и да звучи глупаво). Затова празният ред отгоре е символ за кода 01110. За кода 00 символът е интервал в началото на реда. Веднага ще кажа, че нашият коефициент е изложен на риск — този начин на съхранение на таблицата може да претендира на най-нерационалния. Но е прост за разбиране и реализиране. С удоволствие ще приема вашите препоръки в коментарите относно оптимизацията.
С тази таблица е много лесно да декодирате. Нека да си припомним с кое правило се ръководехме при създаването на кодирането:
Нито един код не трябва да е префикс на друг.
Тук играе облекчаваща роля. Четем последователно бит по бит и, когато полученият низ d, състоящ се от прочетените битове, съвпада с кодирането, съответстващо на символа character, веднага знаем, че е кодирано символът character (и само той!). След това записваме character в декодираната низ (низ, съдържащ декодираното съобщение), нулираме низа d и четем нататък кодиран файл.
Реализация
Време е да унижа кода си и да пиша архиватор. Нека го наречем Compressor.
Да започнем от начало. Първо пишем клас Node:
публичный класс Node {
    приватный int частота;
    приватный char буква;
    приватный Node левыйПотомок;
    приватный Node правыйПотомок;


    публичный Node(char буква, int частота) {
        this.буква = буква;
        this.частота = частота;
    }

    публичный Node() {}
    публичный void добавитьПотомка(Node новыйУзел) {
        если (левыйПотомок == null)
            левыйПотомок = новыйУзел;
        еще {
            если (левыйПотомок.получитьЧастоту() <= новыйУзел.получитьЧастоту())
                правыйПотомок = новыйУзел;
            еще {
                правыйПотомок = левыйПотомок;
                левыйПотомок = новыйУзел;
            }
        }

        частота += новыйУзел.получитьЧастоту();
    }

    публичный Node получитьЛевыйПотомок() {
        вернуть левыйПотомок;
    }

    публичный Node получитьПравыйПотомок() {
        вернуть правыйПотомок;
    }

    публичный int получитьЧастоту() {
        вернуть частота;
    }

    публичный char получитьБукву() {
        вернуть буква;
    }

    публичный boolean являетсяЛистом() {
        вернуть левыйПотомок == null && правыйПотомок == null;
    }
}
Сейчас дерево:
класс BinaryTree {
    приватный Node корень;

    публичный BinaryTree() {
        корень = новый Node();
    }

    публичный BinaryTree(Node корень) {
        this.корень = корень;
    }

    публичный int получитьЧастоту() {
        вернуть корень.получитьЧастоту();
    }

    публичный Node получитьКорень() {
        вернуть корень;
    }
}
Приоритетная очередь:
импорт java.util.ArrayList;

класс PriorityQueue {
    приватный ArrayList данные;
    приватный int количествоЭлементов;

    публичный PriorityQueue() {
        данные = новый ArrayList();
        количествоЭлементов = 0;
    }

    публичный void вставка(BinaryTree новоеДерево) {
        если (количествоЭлементов == 0)
            данные.добавить(новоеДерево);
        еще {
            для (int i = 0; i  новоеДерево.получитьЧастоту()) {
                    данные.добавить(i, новоеДерево);
                    перерыв;
                }
                если (i == количествоЭлементов - 1)
                    данные.добавить(новоеДерево);
            }
        }
        количествоЭлементов++;
    }

    публичный BinaryTree удалить() {
        BinaryTree временное = данные.получить(0);
        данные.удалить(0);
        количествоЭлементов--;
        вернуть временное;
    }
}
Класс, создающий дерево Хаффмана:
публичен клас HuffmanTree {
    частен финален байт РАЗМЕР_НА_ТАБЛИЦАТА_ПРИКОДИРАНЕ = 127; //дължина на таблицата за кодиране
    частен String myString; //съобщение
    частен BinaryTree huffmanTree; //дърво на Хаффман
    частен int[] freqArray; //таблица на честотите
    частен String[] encodingArray; //таблица за кодиране


    //----------------конструктор----------------------
    публичен HuffmanTree(String newString) {
        myString = newString;

        freqArray = нов int[РАЗМЕР_НА_ТАБЛИЦАТА_ПРИКОДИРАНЕ];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = нов String[РАЗМЕР_НА_ТАБЛИЦАТА_ПРИКОДИРАНЕ];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------таблица на честотите------------------------
    частен void fillFrequenceArray() {
        за (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    публичен int[] getFrequenceArray() {
        върни freqArray;
    }

    //------------------------създаване на дърво на Хаффман------------------
    частен BinaryTree getHuffmanTree() {
        PriorityQueue pq = нов PriorityQueue();
        //алгоритъм описан по-горе
        за (int i = 0; i < РАЗМЕР_НА_ТАБЛИЦАТА_ПРИКОДИРАНЕ; i++) {
            ако (freqArray[i] != 0) { //ако символът съществува в строката
                Node newNode = нов Node((char) i, freqArray[i]); //то създай за него Node
                BinaryTree newTree = нов BinaryTree(newNode); //а за Node създай BinaryTree
                pq.insert(newTree); //вмъкни в опашката
            }
        }

        докато (вярно) {
            BinaryTree tree1 = pq.remove(); //извади от опашката първото дърво.

            опитайте {
                BinaryTree tree2 = pq.remove(); //извади от опашката второто дърво

                Node newNode = нов Node(); //създай нов Node
                newNode.addChild(tree1.getRoot()); //прави го потомък на двете извадени дървета
                newNode.addChild(tree2.getRoot());

                pq.insert(нов BinaryTree(newNode);
            } хващам (IndexOutOfBoundsException e) { //остава едно дърво в опашката
                върни tree1;
            }
        }
    }

    публичен BinaryTree getTree() {
        върни huffmanTree;
    }

    //-------------------таблица за кодиране------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { //попълни таблицата за кодиране
        ако (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } иначе {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        върни encodingArray;
    }

    публичен void displayEncodingArray() { //за отстраняване на грешки
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Таблица за кодиране====================");
        за (int i = 0; i < РАЗМЕР_НА_ТАБЛИЦАТА_ПРИКОДИРАНЕ; i++) {
            ако (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        върни myString;
    }
}
Класът, който кодира/декодира:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // размер таблицы
    private HuffmanTree mainHuffmanTree; // дерево Хаффмана (используется только для сжатия)
    private String myString; // исходное сообщение
    private int[] freqArray; // частотная таблица
    private String[] encodingArray; // кодировочная таблица
    private double ratio; // коэффициент сжатия


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // для сжатия
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // для извлечения;

    //---------------------------------------сжатие-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // промежуточная строка (без добавочных нулей)
        // System.out.println("=============================Сжатие=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // нужно добавить нули в конец (можно 1, это не важно)
        byte counter = 0; // количество добавленных в конец нулей (байта вполне хватит: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta; counter++) { // delta - количество добавленных нулей
            intermidiate += "0";
        }

        // склеить количество добавочных нулей в бинарном представлении и промежуточную строку
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // идеализированный коэффициент
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // посчитать идеализированный коэффициент
        double sumA = 0, sumB = 0; // A - оригинальная сумма
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // финальное сжатие
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    //---------------------------------------конец сжатия----------------------------------------------------------------
    //------------------------------------------------------------извлечение-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // получить количество вставленных нулей
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, т.к. первым байтом у нас идет количество вставленных нулей
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // если совпало
                    decompressed += (char)j; // то добавляем элемент
                    current = ""; // и обнуляем текущую строку
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // для отладки
        System.out.println("======================Таблица кодирования====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Клас, който улеснява записването във файл:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Невалиден път или файлът не съществува!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Клас, който улеснява четенето от файл:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // ако файлът е свършил
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
И главният клас:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // указваме инструкция с помощта на аргументите от командния ред
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Неверен формат на входните аргументи");
            System.out.println("Прочетете Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Неверен път или такъв файл не съществува!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Текущата кодировка на файла не се поддържа");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // създаване на файл с кодова таблица:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Път до компресирания файл: " + compressedFile.getAbsolutePath());
        System.out.println("Път до кодовата таблица " + table.getAbsolutePath());
        System.out.println("Без таблица, файлът няма да може да бъде извлечен!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // идеализиран коефициент
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // реален коефициент

        System.out.println("Идеализираният коефициент на компресия е " + idealRatio);
        System.out.println("Коефициент на компресия с включена кодова таблица " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // чете компресирания файл
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! проверете тук:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // методът връща EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // чете кодовата таблица:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // пропускаме първия празен ред
        	encodingArray[(byte)'n'] = fi.readLine(); // чете кода за 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // извлича:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Път до разпакования файл " + extractedFile.getAbsolutePath());
    }
}
Файл с инструкциите readme.txt ще трябва да напишете сами 🙂
Заключение
Мисля, че това е всичко, което исках да кажа. Ако имате нещо да добавите относно моята некомпетентност по отношение на подобренията в кода, алгоритъма или каквато и да е оптимизация, не се колебайте да пишете. Ако не съм обяснил нещо достатъчно, също пишете. Ще се радвам да чуя вашето мнение в коментарите!
P.S.
Да-да, все още съм тук, тъй като не съм забравил за коефициента. За низ s1 кодировъчната таблица тежи 48 байта — много повече от първоначалния файл, и не забравяйте за добавените нули (броят на добавените нули е 7) => коефициентът на компресия ще бъде по-малък от единица: 176/(65 + 48*8 + 7)=0.38. Ако и вие сте забелязали това, просто не изпитвайте вина. Да, тази реализация ще бъде извънредно неефективна за малки файлове. Но какво се случва с големите файлове? Размерите на файла значително надвишават размера на кодировъчната таблица. Тук алгоритъмът работи както трябва! Например, за архиваторът дава реален (не идеализиран) коефициент, равен на 1.46 — почти 1.5 пъти! И да, предполага се, че файлът ще бъде на английски език.
Източник: habr.com
