

Меня зовут Юрий, я ръководител на екипа за системно администриране в Ситимобил. Днес ще споделя опита си в работата с технологията на тънкото резервиране (thin provisioning) на файлови системи Linux и ще разкажа как може да се прилага в технологичните CI/CD процеси на компанията. Ще разгледаме ситуация, при която за автоматично тестване на кода при доставката му в продукция, ни трябват копия на БД MySQL, максимално близки до „оперативната“ версия, налични за четене и запис.
Въведение: защо да даваме вредни съвети?
Логичен въпрос, тъй като вече съществуват отработени механизми за миграции на схеми на БД в тестови среди. Защо изобщо да довеждаме основната нестандартна СУБД до такива обеми? И за тестване не са нужни всички данни. Ще се опитам да обясня.
Приблизително преди година, на фона на активния растеж на нашия агрегатор за таксита (през 2018 година завършените пътувания нараснаха около 15 пъти), нараснаха и обемите на данните, натоварването на сървърите и честотата на внедряванията. Оказахме се в следната ситуация:
- Основната БД MySQL нарасна до около 1000 таблици с общ обем от 2,5 Тб и продължава да расте.
- Нямаше възможност бързо да се шардим и да разпределим базата. Старият подход „пиша в базата каквото и както искам“ създаде много JOIN-ове и вътрешни зависимости между таблиците.
- Нямаше механизъм за миграции на схемата на БД в тестови среди.
- Нямаше автоматично тестване на кода при внедряване в експлоатация.
Последният проблем искахме да решим възможно най-бързо. Бяха написани тестове с Postman за проверка на основния PHP монолит, но нямаше актуална база данни. Не можехме да създаваме реплика през нощта, да я направим мастър и да я предоставим за експлоатация през деня: огромното количество внедрения и промени, включително в данните и схемата на БД, щяха да направят стенда неработоспособен до средата на деня. А ограничаването на внедренията само до работен ден би било неефективно.
Въпреки това, задачата беше изпълнена: първият работещ стенд получихме вече след две седмици. През изминалата година той е претърпял много изменения и продължава да се използва.
По-долу подробно ще опиша всички стъпки и етапи на развитието на нашето решение. Ще се уверите, че този метод заслужава право на съществуване.
Какво е "тънко резервиране"?
Това е хардуерна или софтуерна технология (друго название — sparse volumes), която позволява да се резервират повече ресурси, отколкото има налични. В същото време резервираният обем трябва да отговаря на критерии за just-enough (толкова, колкото е необходимо) и just-in-time (в необходимото време). Основно, тънкото резервиране се използва в различни СХД, за да предостави дисково пространство в необходимите обеми, превишаващи действително наличните. Технологията се поддържа от различни файлови системи, като LVM2, ZFS, BTRFS. Тя се използва широко в хипервизори за виртуализация. Тънкото резервиране ни позволяваше бързо да създадем толкова копия от основния дял с данни, колкото ни е нужно (data-директория на СУБД MySQL) от снимки.
Първи стенд, технология Thin LVM
Тази глава може да се нарече "Как да направим максимално бързи снимки на големи обеми данни с помощта на ", намалявайки стабилността на файловата система и СУБД MySQL до неприлични резултати."
Тъй като вече използвахме LVM за изграждане на основните дялове на ОС, решихме да започнем именно от нея. Първо, нуждаехме се от отделна физическа машина — реплика на нашата основна база MySQL, на която можехме да създадем снимка на репликата и да я стартираме с отделен екземпляр на MySQL. По време на тестовете разрешихме прилагането на операции за модификация на този екземпляр и след приключване на тестовете го изтривахме. Конфигурацията на сървъра беше следната:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD в RAID-контролер Adaptec в RAID-10
По темата за избора между RAID-контролер и софтуерен RAID MD може да се напише отделна статия. Ще кажа само, че нашият избор беше повлиян от два фактора:
- Времето на поставяне на задачата, ние всички СУБД инсталирахме на RAID-контролери, следователно може да се каже, че така исторически се е сложило.
- Разликата в производителността при синтетичните тестове на файловата система и тестовете с различни операции в MySQL беше минимална.
Разделихме получения RAID-10: създадохме единен Volume Group (VG) за целия обем (с надходи от около 6,7 Гб) и създадохме логичен дял (Logical Volume, LV) за системата от 50 Гб. В обичайна ситуация останалото пространство определяме за дял с MySQL. Но ни беше нужно тънко резервиране, затова първо създадохме така наречения pool, вътре в който създадохме дял под /var/lib/mysql с 3,5 Тб (на база предполагаемите обеми на БД):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Форматирахме дяла в ext4, монтирахме го, записахме реплика и получихме изходния стенд. След това направихме свързване под формата на API, който трябва да създава снимки, да стартира екземпляр на БД MySQL на зададения порт и да изтрива създадения екземпляр. Понеже за това се използват изключително системни повиквания, за език на скриптовете избрахме обикновен bash, а за свързването API HTTP → bash внедрихме open source решение. , написано на Go.
Някога ще публикуваме нашите bash-скриптове с open source, а засега просто ще опиша основния алгоритъм:
Създаване на основната снимка snapmain:
- Спираме основната реплика.
- Слагаме заключване на операциите със снимката snapmain.
- Създаваме нова снимка snapmain.
- Стартираме MySQL и премахваме заключването.
Създаване на БД на произволен порт от snapmain:
- Слагаме заключване на конкретния екземпляр на БД (порт).
- Проверяваме наличието на заключване за създаването на основната снимка. Ако има, чакаме и проверяваме отново на всеки 5 секунди.
- Проверяваме, дали има стар LV-дял на екземпляра.
3.1 Ако има, спираме с помощта на kill -9 екземпляра MySQL и изтриваме LV-дяла. - Създаваме нов екземпляр от snapmain.
- Приготвяме и монтираме директориите за този екземпляр.
- Премахваме признаци на слейва (файлове) и стартираме екземпляра на MySQL.
- Правим от него master.
- Премахваме заключването.
Изтриване на БД на произволен порт:
- Слагаме заключване на конкретния екземпляр на БД (порт).
- Убиваме екземпляра на MySQL с помощта на kill -9.
- Размонтираме директориите.
- Изтриваме LV-дяла и премахваме заключването.
Примерни команди за клониране на дяловете на новия екземпляр на БД:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Сега ще поговоря за основния проблем, с който се сблъскахме при използването на тънко резервиране. Стигнахме до производителността на SSD дисковете. Това се случи заради особеностите на Thin LVM: тя в своята същност работи на ниво устройство с нискоуровневни чанкове с размер по подразбиране 4 MB. Как изглеждаше това:
- Създаваме снапшот от основната директория /var/lib/mysql.
- Стартираме репликация, за да настигнем майстора.
- Каквото и да е изменение в таблиците на репликата налага запазване на старите, неизменени чанкове данни в директорията на снапшота.
- Каквото и да е изменение в стартирания тестов екземпляр налага запазване на старите, неизменени чанкове данни в директорията на клонирания снапшот за този екземпляр.
- Получаваме натовареност на операциите на входно-изходни устройства от 100%, забавяне на всякакви операции и бавно изоставане на репликата.
- Към края на работния ден получаваме изостанала с няколко часа платформа.
Как се справяхме с това, за да получим по-адекватен резултат (основни моменти):
RAID контролер:
- Изключихме по подразбиране всичките видове кеширане.
- Настроихме writeback (когато данните влязат в буфера, записа приключва преди да се извърши действителното записване на диска).
Файлова система:
- В точката на монтиране /var/lib/mysql записахме noatime,nodiratime,data=writeback
- Изключихме журнализацията ext4 с помощта на tune2fs.
MySQL:
- Записахме innodb_flush_method = O_DSYNC (увеличихме скоростта на запис, намалявайки по този начин надеждността).
- Изключихме журнализацията, логовете не са ни нужни.
- Записахме innodb_buffer_pool_size = 4G (колкото по-малък е размерът на InnoDB пула, толкова по-бързо MySQL ще спре при спиране, и толкова по-бързо ще създадем снапшот).
Това далеч не е пълен списък, особено по отношение на MySQL. Впрочем, останалите изменения са незначителни и често не са приложими винаги и точно. Например, в опитите да облекчим дисковете дори преместихме innodb_parallel_doublewrite_path в /dev/shm, което в някои случаи при стартиране на некоректно завършен екземпляр спестяваше до 5 секунди.
Защо спираме MySQL преди да направим снапшот? Защото можем да го направим от работеща реплика. Вярно е, но новият екземпляр на БД на този снапшот по подразбиране ще се счита за повреден и ще изисква пълно сканиране при стартиране. Спирането на репликата определено отнема по-малко време, въпреки че в крайна сметка е най-дългата операция в целия процес.
В резултат получихме по-приемливи тайминги и готов стенд. Въпреки това, както личи от най-категоричната графика на закъснението на репликацията на основната реплика, ситуацията все още е далеч от идеала:
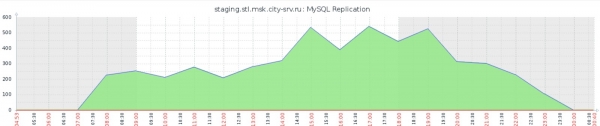
От другите недостатъци трябва да се отбележи практически невъзможността за мониторинг на Thin LVM пула: освен стандартните системни функции iostat, е невъзможно да се разбере, например, кой елемент от пула в момента оказва най-голямо натоварване на файловата система.
Отделно трябва да се спомене един голям недостатък, свързан с описаната по-горе оптимизация: получихме YOLO-стенд. Приблизително веднъж на един-два месеца ext4 не устояваше на подобни злоупотреби и безвъзвратно се повреждаше, изисквайки повторно форматиране и пренос на репликата. Спечелвайки на скорост, безнадеждно убихме стабилността.
На какви метрики трябва да се следи по време на експлоатацията на Thin LVM:
- Процент на данните в Thin pool
- Процент на метаданните в Thin pool
Ако стендът ни оцелее след изчерпване на пространството за данни (достатъчно е да почистим дисковете), то изчерпването на пространството за метаданни ще доведе до пълен крах на пула и необходимостта от неговото пресоздаване от нулата.
Файловата система вътре в пула с времето се фрагментира много. Препоръчвам ежедневно да стартирате по крон командата fstrim -v /var/lib/mysql.
Промеждутъчни резултати:
- Технологията лесно може да бъде приложена, както и самият LVM, и не изисква особена квалификация от инженерите.
- Тя е подходяща за малки бази данни и не особено натоварени системи. Колкото по-малка е базата данни, толкова по-малко чанкове се преместят по файловата система вътре в пула и толкова по-ниско е натоварването на дисковете.
- За нашата задача започнахме да търсим други решения, за което ще стане дума в следващия раздел.
Вторият стенд, технологията ZFS
Отдавна имах работа с файловата система ZFS, но тогава тя функционираше надеждно в родното си семейство ОС Solaris. Имаше портирована версия за FreeBSD с прилично ниво на реализация. Съществуваше и недовършен порт за Linux, който малко хора използваха. Поради структурата на съхранение на данни B-tree (между другото, същата структура използва и InnoDB на MySQL) ZFS не се представяше добре при инсталации с много файлове. Всичко това, в комбинация с необходимостта да се учи материята преди използването, отдавна я изключи от практиката ми. Появиха се ext4 и xfs, които се превърнаха в стандарт. Но при положение, че за нашата задача ZFS е повече от подходяща, и Linux версията, по отзиви, се е трансформирала в напълно приемлив продукт (въпреки че не е напълно поддържана, което прави инсталирането на системата на ZFS от нулата възможно само чрез различни маневри), решихме да я опитаме.
Поради разбираеми причини, избрахме стенд с аналогична конфигурация (с изключение на RAID контролера). Инсталирахме осем SSD диска с по 1920 Гб. Нямаше желание да пишем собствен мрежов образ за инсталиране на сървера на гола ZFS, затова отрязахме по 50 Гб от всеки диск и направихме MD RAID-10 за системата. Останалите 1950 Гб на всеки диск обединихме в ZFS аналог на RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Направихме дялове за MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Обърнете внимание, че сме активирали вграденото компресиране на данни gzip. Процесорните ресурси на нашия сървър са много и не са напълно използвани. В резултат 3 TB от нашата БД се трансформираха в 1,6 TB, а тъй като слабото звено, както и преди, е максималната производителност на дисковете, толкова по-малко данни — толкова по-добре, от самото начало получаваме отличен бонус от ZFS! По време на пиковите часове при пълно натоварване поддържането на работата на gzip изразходва до 4 ядра, но не ни е жал.
По-нататъшното внедряване премина по-бързо. По подобие пренесохме от LVM стенда настройките на репликата MySQL. Пришло се наложи да прекараме известно време в пренаписване на скриптове на команди на ZFS, но в общи линии алгоритмите останаха същите. Пример за създаване на моментна снимка:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
От допълнителния тунинг: изнесохме в паметта ZFS-разделите с метаданни и логове l2arc и zil. За нашата задача, както се оказа по-късно, това беше излишно, но за момента оставихме тази оптимизация, смяната ѝ не е сложна. От негативните ефекти — след рестартиране на сървъра е необходимо отново да се създадат съответните области в паметта. Изрязване на zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
В такава конфигурация започнахме да тестваме стенда и получихме прекрасни резултати: с две работещи едновременно инстанции на БД (и активна основна реплика) на снапшотове, натовареността на дисковете достигна 50-60 %.
Се отървахме от основния ни проблем, което се вижда на графиката на забавянето на репликацията (сравнете с предишната графика в раздела Thin LVM):
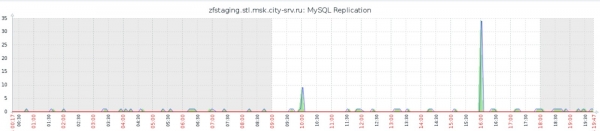
Освен и благодарение на това значително ускори всяка операция: пълното създаване на снапшот с спиране и пускане на реплика отнема до 40 секунди, а разгръщането на нова инстанция MySQL от снапшот отнема до 20 секунди. Това е повече от удовлетворително както за нас, така и за нашите тестове с програмния код.
Промеждутъчни резултати:
- Резултатите напълно удовлетвориха нуждата ни от получаване на копие на бойната БД за тестване на кода.
- Технологията изисква вникване: необходимо е да разбирате какво е ZFS и как да работите с нея.
- Не проверихме текущия статус на работата на ZFS с голям брой (над 1 млн) малки файлове. Но предполагаме, че проблемът остава, затова не бих препоръчал тази файлова система за каквито и да било файлови хранилища.
Какво следва?
В рамките на стенда не сме правили нищо друго, резултатът ни удовлетворява. В бъдеще може да добавим изключения на таблици в настройките на репликацията, които не са необходими за тестване, което още повече ще намали обема на БД. Не сме тествали системата BTRFS и нейната реализация на технологията за тънко архивиране. Въпреки това, такава задача вече не стои, тъй като основната цел е постигната. В общи линии, разбира се, искаме да се отдалечим от описания по-горе подход — да реализираме работещи миграции на БД в тестова среда, да създадем отделен тестов контур на БД и да се заемем с шардироването на основната база. Много от това вече реализираме, за което задължително ще разкажем в бъдещи статии.
Итог
Първоначалната задача е решена, макар и по необичаен начин. В междинните изводи бяха описани предимствата и недостатъците на всяка от използваните технологии, така че нека определим коя технология и кога може да бъде използвана:
- Thin LVM — при малки БД и когато не искате или нямате време да проучвате ZFS.
- ZFS — ако имате опит с нея или възможност да отделите време за изучаване при всякакви обстоятелства.
На по-високо ниво на представяне, тази статия не е просто сравнение на технологията на двете файлови системи. Основната идея, която искам да предам и утвърдя, е, че не бива да се страхувате да мислите нестандартно в ситуации, критични за бизнеса, и да взимате само готови рецепти. Някога можехме да поклатим глави и да кажем, че задачата да създадем три терабайтни копия на БД за по-малко от минута е невъзможна, и че не ни трябват рискови технологии, нека да направим как трябва. Това беше възможно, но щяхме да загубим около половин година-година и много клиентски пътувания (пътуванията са нашият основен бизнес показател) без тестове и по време на внедряването. Като подходихме нестандартно, загубихме не толкова много време за внедряване, получихме опит в нови и забравени стари технологии и предоставихме тестове точно в момента, когато много ги нуждаехме. Несъмнено, това се отрази положително на всички наши показатели. Изборът винаги е ваш, а ние от своя страна ще продължим да разказваме в нашия блог за интересни текущи и бъдещи достижения.
Източник: habr.com
