

На всички добри!
Казвам се Никита, аз съм тимлид на екипа инженери в Циан. Една от моите отговорности в компанията е да намаля инцидентите, свързани с инфраструктурата в продукцията, до нула.
Темата, за която ще стане дума по-късно, ни донесе много болка и целта на тази статия е да не позволим на другите да повтарят нашите грешки или поне да минимизират влиянието им.
Преамбула
Отдавна, когато Циан се състоеше от монолити и нямаше никакви намеци за микросервизи, ние измервахме наличността на ресурса, проверявайки 3–5 страници.
Ако отговарят — всичко е наред, ако не отговарят дълго време — идва аларма. Колко време трябва да не работят, за да се счита за инцидент, решаваха хората на заседания. Инженерният екип винаги участваше в разследването на инцидента. Когато разследването приключеше, пишехме постмортем — своеобразен отчет по имейл в формат: какво се е случило, колко е продължило, какво направихме в момента, какво ще направим в бъдеще.
Основни страници на сайта или как разбираме, че сме достигнали дъното
За да можем да разберем приоритета на грешките, ние отделихме най-критичните за бизнес функционалността страници на сайта. По тях считаме броя на успешните/неуспешните заявки и таймаутите. По този начин измерваме uptime.
Да кажем, че сме установили, че има редица супер важни раздели на сайта, които отговарят за основната услуга — търсенето и подаването на обяви. Ако броят на заявките, които завършват с грешка, надвишава 1% — това е критичен инцидент. Ако през 15 минути в пиковите часове процентът на грешките надвишава 0,1% — това също се счита за критичен инцидент. Тези критерии покриват по-голямата част от инцидентите, останалите излизат извън обхвата на тази статия.
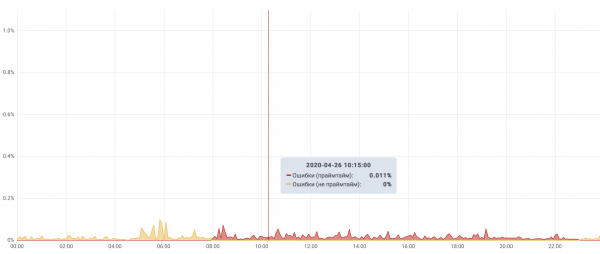
Топ инциденти в Циан
Така че определено научихме да определяме факта, че инцидент се е случил.
Сега всеки инцидент е подробно описан и отразен в епика на Jira. Между другото: за това създадохме отделен проект, който нарекохме FAIL — в него могат да се създават само епики.
Ако съберем всички провали през последните няколко години, водещи са:
- инциденти, свързани с mssql;
- инциденти, причинени от външни фактори;
- грешки на администратори.
Нека да се спрем по-подробно на грешките на администраторите, както и на някои други интересни провали.
Пето място — „Подреждане на DNS“
Това беше мъглив вторник. Решихме да подредим DNS клъстера.
Пожелахме да преминем от вътрешни DNS сървъри с bind на powerdns, като напълно отделихме специални сървъри, на които няма нищо освен DNS.
Поставихме по един DNS сървър на всяка локация на нашите дата центрове и настъпи моментът за прехвърляне на зоните от bind в powerdns и пренасочване на инфраструктурата към новите сървъри.
В самия разгара на прехвърлянето от всички сървъри, които бяха указани в локалните кеширащи bind на всички сървъри, остана само един, който беше в дата центъра в Санкт Петербург. Този дата център първоначално беше обявен за некритичен за нас, но внезапно стана единична точка на провал.
Точно в такъв период на прехвърляне се срина каналът между Москва и Санкт Петербург. Всъщност останахме без DNS за пет минути и се възстановихме, когато хостер бяха отстранени проблемите.
Изводи:
Ако преди пренебрегвахме външните фактори по време на подготовката за работа, сега също ги включваме в списъка на това, за което се подготвяме. И сега се стремим всичките компоненти да са резервирани n-2, а по време на работата можем да свалим това ниво до n-1.
- По време на съставяне на плана за действие отбелязвайте точки, където услугата може да се срине, и обмисляйте сценарий, в който всичко е „по-лошо не може да бъде“, предварително.
- Разпределяйте вътрешните DNS сървъри в различни геолокации/дата центрове/стойки/комутатори/вводове.
- На всеки сървър инсталирайте локален кеширащ DNS сървър, който пренасочва заявките към основните DNS сървъри, а в случай на недостъпност ще отговаря от кеша.
Четвърто място — „Подреждаме Nginx“
В един прекрасен ден нашият екип реши, че „стига толкова“, и започна процесът на рефактуриране на конфигурациите на nginx. Основната цел — да приведем конфигурациите към интуитивно понятна структура. Преди всичко беше „исторически наложено“ и нямаше никаква логика. Сега всеки server_name беше изнесен в едноименен файл и разпределихме всички конфигурации по папки. Между другото — конфигурацията съдържа 253949 реда или 7836520 символа и заема почти 7 мегабайта. Най-високо ниво на структурата:
Структура на Nginx
├── достъп
│   ├── allow.list
...
│   └── whitelist.conf
├── геобаза
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── геобд
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Стана значително по-добре, но в процеса на преименуване и разпределение на конфигурациите, част от тях имаше неправилно разширение и не попадна в директивата include *.conf. В резултат на това — част от хостовете стана недостъпна и върна 301 на главната страница. Поради факта, че кодът на отговора не беше 5хх/4хх, това не беше забелязано веднага, а едва сутринта. След това започнахме да пишем тестове за проверка на инфраструктурните компоненти.
Изводи:
- Правилно структурирайте конфигурациите (не само nginx) и замислете структурата на ранния етап от проекта. Така ще ги направите по-разбираеми за екипа, което от своя страна ще намали времето за пускане.
- За някои инфраструктурни компоненти пишете тестове. Например: проверка, че всички ключови server_name връщат правилен статус, + тялото на отговора. Достатъчно е да имате под ръка просто няколко скрипта, които проверяват основните функции на компонента, за да не трябва да си спомняте в 3 часа през нощта какво още трябва да проверите.
Трето място — „Внезапно свърши мястото в Cassandra“
Данните постепенно нарастваха и всичко беше наред до момента, когато в клъстера Cassandra започнаха да падат ремонти на големи кейспейсове, защото не може да се извърши компакция.
В един дъждовен ден клъстерът почти се преобразува в тиква, а именно:
- оставало е около 20% от общото място в клъстера;
- пълноценно добавяне на възли не е възможно, защото не минава почистване след добавяне на възел поради недостатъчно място на дяловете;
- производителността бавно намалява, тъй като компакцията не работи;
- клъстерът работи в аварийен режим.
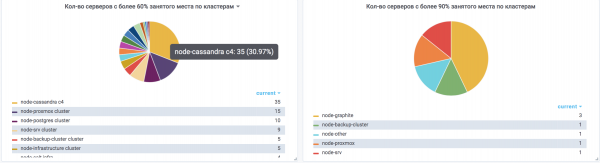
Изход — добавихме още 5 нода без почистване, след което започнахме планомерно да изключваме от клъстера и отново да въвеждаме, като празни нода, на които е свършило мястото. Времето, което беше изразходвано, беше значително повече, отколкото бихме искали. Имаше риск от частична или пълна недостъпност на клъстера.
Изводи:
- На всички сървъри Cassandra не трябва да бъде заето повече от 60% от мястото на всеки дял.
- Те трябва да бъдат натоварени не повече от 50% по ЦП.
- Не бива да пренебрегвате планирането на капацитета и то трябва да бъде обмислено за всеки компонент, в зависимост от неговата специфика.
- Колкото повече нода има в клъстера — толкова по-добре. Сървърите, които съдържат малък обем данни, се пренасочват по-бързо, а такъв клъстер е по-лесен за възстановяване.
Второ място — „Изчезнали данни от консул ключово-стойностно хранилище“
За откриване на услуги ние, както и много други, използваме консул. Но при нас неговото ключово-стойностно хранилище се използва и за blue-green разгръщането на монолита. Там се съхранява информация за активните и неактивните upstream-ове, които се разменят по време на деплой. За това беше написан деплой сървис, който взаимодействал с KV. В някакъв момент данните от KV изчезнаха. Възстановихме по памет, но с редица грешки. В резултат на това при разгръщането натоварването на upstream-ите се разпредели неравномерно и получихме много 502 грешки поради претоварване на бекендовете по ЦП. В крайна сметка преминахме от консул KV на Postgres, от където да ги премахнем вече не е толкова лесно.
Изводи:
- Услугите без никаква авторизация не трябва да съдържат критични за работа на сайта данни. Например, ако нямате авторизация в ES — е по-добре да забраните достъпа на ниво мрежа от навсякъде, където не е необходим, да оставите само нужните, както и да направите action.destructive_requires_name: true.
- Разработете механизма за резервно копие и възстановяване предварително. Например, предварително създайте скрипт (например на Python), който може и да архивира, и да възстановява.
Първо място — „Капитан неочевидност“
В някакъв момент забелязахме неравномерно разпределение на натоварването на nginx upstream при случаи, когато в бекенда имаше 10+ сървъра. Поради факта, че round-robin насочваше заявките от 1 до последния upstream по ред, и всяко презареждане на nginx започваше отначало, на първите upstream винаги се падаха повече заявки, отколкото на останалите. В резултат те работеха по-бавно и целият сайт страдаше. Това ставаше все по-забележимо с увеличаването на трафика. Проста актуализация на nginx, за да включи random, не проработи – необходимо беше да преработим куп lua код, който не заработи на версия 1.15 (по онова време). Пришло се да патчим нашия nginx 1.14.2, внедрявайки поддръжка на random. Това реши проблема. Тази грешка печели в категория „капитан очевидност“.
Изводи:
Беше много интересно и увлекателно да изследвам тази грешка).
- Изградете мониторинг така, че да помага за бързо откриване на подобни флуктуации. Например, можете да използвате ELK, за да наблюдавате rps на всеки бекенд на всеки upstream, следейки времето им за отговор от гледна точка на nginx. В този случай това ни помогна да идентифицираме проблема.
По-голямата част от проблемите можеха да бъдат избегнати с по-скрупульозен подход към това, което правите. Винаги трябва да помните закона на Мърфи: Всичко, което може да се обърка, ще се обърка, и да изграждате компонентите, ръководейки се от него.
Източник: habr.com
