

Какво бихте почувствали, ако в един прекрасен летен ден центърът за данни с вашето оборудване изглеждаше точно така?
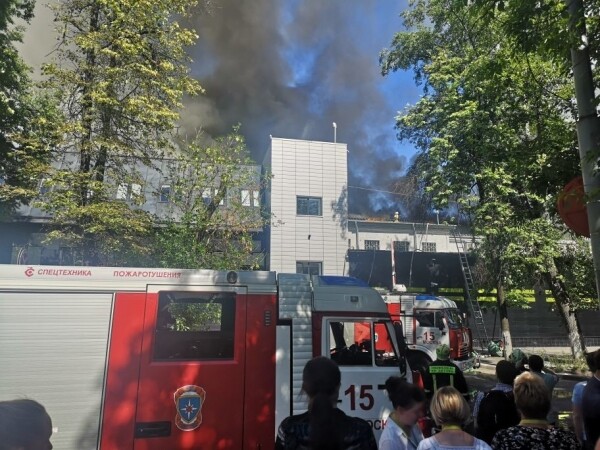
Здравейте на всички! Казвам се Дмитрий Самсонов и работя като старши системен администратор в „“. На снимката е един от четирите дата-центъра, където е инсталирано оборудването, обслужващо нашия проект. Зад тези стени се намират около 4000 устройства: сървъри, системи за съхранение на данни, мрежово оборудване и т.н. — почти ⅓ от всичкото ни оборудване.
По-голямата част от сървърите са с Linux. Има и десетки сървъри на Windows (MS SQL) — нашето наследство, от което постепенно се отказваме през последните години.
И така, на 5 юни 2019 г. в 14:35 инженерите на един от нашите дата-центрове съобщиха за пожарна тревога.
Отричане
14:45. Малките инциденти с дим в дата-центровете се случват по-често, отколкото изглежда. Показателите в залите бяха в нормите, затова първата ни реакция беше относително спокойна: наложихме забрана за работа с продукция, т.е. за всякакви промени в конфигурации, за разпространение на нови версии и т.н., освен за работа, свързана с ремонтиране на нещо.
Ярост
Питали ли сте някога пожарникарите, къде точно на покрива е възникнал пожар, или да се качите сами на горящия покрив, за да оцените ситуацията? Каква ще бъде степента на доверие към информацията, получена през петима души?
14:50. Получена е информация, че огънят се приближава до системата за охлаждане. Но ще стигне ли? Дежурният системен администратор насочва външния трафик от фронтовете на този дата-център.
В момента фронтовете на всички наши услуги са дублирани в три дата-центъра, използва се балансировка на ниво DNS, което позволява да бъдат премахнати адресите на един дата-център от DNS, като по този начин потребителите се предпазват от потенциални проблеми с достъпа до услугите. Ако проблеми в дата-центъра вече са възникнали, той автоматично излиза от ротацията. Повече информация може да се прочете тук:
Пожарът засега не е повлиял на нас — нито потребителите, нито оборудването пострадаха. Дали това е авария? Първата част от документа „План за действие при аварии“ дава определение на термина „Авария“ и завършва с раздела така:
«Ако има съмнения, дали това е авария или не, то това е авария!»
14:53. Назначава се координатор на аварията.
Координаторът е лицето, което контролира комуникацията между всички участници, оценява мащаба на аварията, използва "План за действие при авария", привлича необходимия персонал, контролира завършването на ремонта, най-вече делегира задачи. С други думи, това е човекът, който ръководи целия процес на ликвидиране на аварията.
Търг
15:01. Започваме да изключваме сървърите, които не са свързани с продукцията.
15:03. Коректно изключваме всички резервирани услуги.
Тук влизат не само фронтовете (на които към този момент потребителите вече не влизат) и техните помощни услуги (бизнес логика, кешове и т.н.), но и различни бази данни с репликационен фактор 2 и повече (, , , и други).
15:06. Постъпила е информация, че пожар застрашава една от залите на дата центъра. В тази зала нямаме оборудване, но фактът, че огънят може да се прехвърли от покрива към залите, значително променя ситуацията.
(По-късно стана ясно, че физическа заплаха за залата нямаше, тъй като тя е херметически изолирана от покрива. Заплахата бе само за системата за охлаждане на тази зала.)
15:07. Разрешаваме изпълнението на команди на сървърите в ускорен режим без допълнителни проверки ().
15:08. Температурата в залите е в нормата.
15:12. Забелязано е повишение на температурата в залите.
15:13. Повече от половината сървъри в дата центъра са изключени. Продължаваме.
15:16. Взето е решение за изключване на всичкото оборудване.
15:21. Започваме да изключваме захранването на stateless сървърите без коректно изключване на приложението и операционната система.
15:23. Определя се група отговорни за MS SQL (те не са много, зависимостта на услугите от тях не е голяма, но процедурата за възстановяване на работоспособността отнема повече време и е по-сложна, отколкото например при Cassandra).
Депресия
15:25. Постъпила е информация за изключване на захранването в четири зали от 16 (№6, 7, 8, 9). В зали 7 и 8 се намира нашето оборудване. Все още нямаме информация за две от нашите зали (№1 и 3).
Обикновено при пожари електрическото захранване веднага се изключва, но в този случай, благодарение на координираната работа на пожарникарите и техническия персонал на дата центъра, то не е било изключвано навсякъде и не веднага, а по необходимост.
(По-късно се установи, че захранването в зали 8 и 9 не е било прекъсвано.)
15:28. Започваме да възстановяваме базите данни MS SQL от архиви в други дата центрове.
Колко време ще отнеме това? Дали мрежовата пропускливост по целия маршрут е достатъчна?
15:37. Забелязано е прекъсване на някои участъци от мрежата.
Мениджмънт мрежата и продукционната мрежа са физически изолирани една от друга. Ако продукционната мрежа е достъпна, можете да влезете в сървъра, да спрете приложението и да изключите операционната система. Ако не е достъпна, можете да влезете през IPMI, да спрете приложението и да изключите операционната система. Ако никока от мрежите не е налична, не можете да направите нищо. 'Благодаря, капитане!', ще помислите вие.
'И всъщност, каква суматоха', може също да си помислите.
Работата е там, че сървърите дори без пожар генерират огромно количество топлина. По-точно, когато има охлаждане, те генерират топлина, а когато няма, създават адски пек, който в най-добрия случай ще разтопи част от оборудването и ще изключи друга част, а в най-лошия... ще предизвика пожар вътре в залата, който практически гарантирано ще унищожи всичко.
15:39. Отбелязваме проблеми с базата conf.
Базата conf е бекенд за едноименната услуга, която се използва от всички приложения на продукцията за оперативна промяна на настройки. Без тази база не можем да управляваме работата на портала, но самият портал в същото време може да работи.
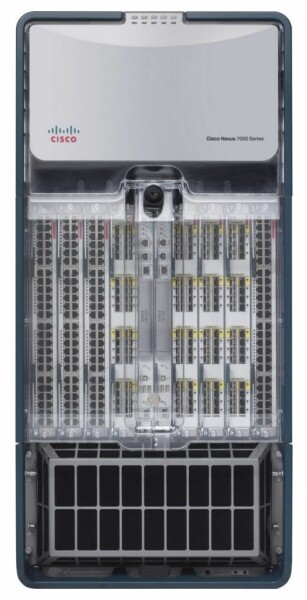
15:41. Температурните сензори на Core мрежовото оборудване фиксират стойности близки до допустимите максимуми. Това е кутия, заемаща цял рафт и осигуряваща работата на всички мрежи в рамките на дата центъра.
15:42. Issue tracker и wiki не са достъпни, преходиме на standby.
Това не е продукция, но при авария достъпността на всяка база знания може да бъде критична.
15:50. Прекъсна се една от системите за мониторинг.
Их са няколко, и те отговарят за различни аспекти на работата на услугите. Част от тях са настроени за автономна работа вътре в всеки дата център (тоест те наблюдават само своя дата център), а други се състоят от разпределени компоненти, които прозрачнo преживяват загубата на който и да е дата център.
В този случай переста да работи , която работи в режим master-standby. Превключихме на standby.
Приемане
15:51. Чрез IPMI изключихме без коректно завършване на работата всички сървъри, освен MS SQL.
Готови ли сте за масово управление на сървъри чрез IPMI, ако се наложи?
Този специален момент, когато спасението на оборудването в дата центъра на този етап е завършено. Всичко, което можеше да се направи, е направено. Някои колеги могат да си починат.
16:13. Получена е информация, че на покрива са се спукали фреоновите тръби на климатичните инсталации — това ще отложи старта на дата центъра след отстраняване на пожара.
16:19. Според данните от техническия персонал на дата центъра, повишаването на температурата в залите е спряло.
17:10. Възстановихме работата на базата conf. Сега можем да променим настройките на приложенията.
Защо това е толкова важно, ако всичко е отказоустойчиво и работи дори без един дата център?
На първо място, не всичко е отказоустойчиво. Има различни второстепенни услуги, които в момента не понасят достатъчно добре отказа на дата центъра, а също така има бази в режим master-standby. Възможността за управление на настройките позволява да направим всичко необходимо, за да минимизираме влиянието на последствията от инцидента върху потребителите дори в сложни условия.
На второ място, стана ясно, че в близките часове работата на дата центъра няма да бъде напълно възстановена, затова бе необходимо да се предприемат мерки, за да не доведе продължителната недостъпност на репликите до допълнителни неприятности като препълване на дисковете в останалите дата центрове.
17:29. Време за пица! Имаме хора, а не роботи.
Рехабилитация
18:02. В залите №№8 (наш), 9, 10 и 11 температурата се стабилизира. В една от залите, която остава изключена (№7), се намира нашето оборудване и температурата там продължава да нараства.
18:31. Даваме разрешение за стартиране на оборудването в залите №№1 и 3 — тези зали не бяха засегнати от пожара.
В момента се стартират сървъри в залите №№1, 3, 8, започвайки с най-критичните. Проверява се коректността на работа на всички стартирани услуги. Все още има проблеми със залата №7.
18:44. Техническият персонал на дата центъра установи, че в залата №7 (където е само нашето оборудване) много сървъри не са изключени. Според нашите данни, там остават включени 26 сървъра. След повторна проверка установяваме 58 сървъра.
20:18. Техническият персонал на дата центъра проветрява въздуха в залата без климатици чрез мобилни въздуховоди, положени през коридорите.
23:08. Пуснахме първия администратор у дома. Някой трябва да спи през нощта, за да продължи утре работата. След това отпускаме още част от администраторите и разработчиците.
02:56. Стартирахме всичко, което може да бъде стартирано. Правим голяма проверка на всички услуги с автотестове.
03:02. Климатицията в последната, 7-ма зала е възстановена.
03:36. Започнахме ротация на фронтовете в дата центъра в DNS. От този момент започва да идва потребителски трафик.
Разпускаме голяма част от екипа на администраторите по домовете. Но оставяме няколко души.
Небольшой FAQ:
В: Какво се случваше от 18:31 до 02:56?
О: Следвайки «Плана за действия при авария», ние стартираме всички услуги, започвайки от най-важните. Координаторът в чата предоставя услугата на свободния администратор, който проверява дали операционната система и приложението са стартирали, дали няма грешки и дали показателите са в норма. След завършване на стартирането, той уведомява в чата, че е свободен и получава нова услуга от координатора.
Процесът допълнително забавя отказалото се оборудване. Дори ако спирането на операционната система и изключването на сървърите са преминали коректно, част от сървърите не се връщат поради внезапно отказали се дискове, памет или шаси. При загуба на електрическа енергия процентът на отказите нараства.
В: Защо не може просто да стартираме всичко наведнъж и след това да ремонтираме онова, което излезе в мониторинга?
О: Всичко трябва да се прави постепенно, защото между услугите има зависимости. А проверката трябва да се извършва веднага, без да се чака мониторинга — защото е по-добре да се справим с проблемите веднага, вместо да чакаме тяхното усложнение.
7:40. Последният администратор (координатор) отиде да спи. Работата на първия ден е завършена.
8:09. Първите разработчици, инженери в дата центровете и администратори (включително новия координатор) започнаха възстановителните работи.
09:37. Започнахме да повдигаме зала №7 (последната).
Паралелно продължаваме възстановяването на това, което не завършихме в другите зали: смяна на дискове/памет/сървъри, ремонтиране на всичко, което «гори» в мониторинга, обратна смяна на ролите в схемите master-standby и други дреболии, които все пак са доста на брой.
17:08. Разрешихме всички обичайни работи с продукцията.
21:45. Работите от втория ден са завършени.
09:45. Днес е петък. В мониторинга все още има доста малки проблеми. Предстоят уикенд и всеки иска да почива. Продължаваме с масовото отстраняване на всичко възможно. Планираните администраторски задачи, които можеха да се отложат, са отложени. Новият координатор.
15:40. Изненадващо, половината от стека на Core мрежово оборудване в ДРУГ дата център беше рестартирано. Извадихме фронтовете от ротация, за да минимизираме рисковете. Нямаше ефект за потребителите. По-късно се установи, че това беше повреден шаси. Координаторът работи по поправката на два аварийни случая.
17:17. Работата на мрежата в друг дата център е възстановена, всичко е проверено. Дата центърът е включен в ротация.
18:29. Работата от третия ден и възстановяването след аварията е завършено.
Следсловие
04.04.2013 г., , „Однокласници“ — в продължение на три дни порталът беше напълно или частично недостъпен. През цялото това време над 100 души от различни градове, от различни компании (още веднъж благодаря!), работеха дистанционно и на място в дата центровете, в ръчен режим и автоматично, за да поправят хиляди сървъри.
Ние направихме изводи. За да не се повтаря подобно, проведохме и продължаваме да провеждаме обширни работи до днес.
Какви са основните разлики между настоящата авария и 404?
- Имаме „План за действие при авария“. На всеки тримесечие провеждаме учения - разиграваме аварийна ситуация, която група администратори (всички по ред) трябва да отстранят, използвайки „План за действие при авария“. Водещите системни администратори по ред отработват ролята на координатор.
- Всеки тримесечие в тестов режим изолираме дата центровете (всички по ред) по мрежи LAN и WAN, което позволява своевременно откриване на узки места.
- По-малко повредени дискове, защото сме затегнали стандартите: по-малко часово натоварване и по-строги прагова стойности за S.M.A.R.T.
- Напълно се отказахме от BerkeleyDB - стара и нестабилна база данни, която изискваше много време за възстановяване след рестарт на сървъра.
- Намалихме броя на сървърите с MS SQL и намалихме зависимостта от останалите.
- Имаме собствено , в което вече активно мигрираме всички услуги в продължение на две години. Облакът значително опростява целия цикъл на работа с приложението и в случай на авария предлага уникални инструменти, като:
- Коректно спиране на всички приложения с едно кликване;
- Лесна миграция на приложения от повредени сървъри;
- Автоматично стартиране на целия дата център по приоритет на услугите.
Инцидентът, описан в тази статия, стана най-голямият от 404-ия. Разбира се, не всичко мина гладко. Например, по време на недостъпността на повредения дата център, в друг дата център се повреди диск на един от сървърите, поради което остана достъпна само една от трите реплики в кластера на Cassandra, заради което 4,2% от потребителите на мобилни приложения не можеха да влязат. В същото време, вече свързаните потребители продължиха да работят. Общо, в резултат на инцидента, бяха идентифицирани над 30 проблема - от обикновени бъгове до недостатъци в архитектурата на услугите.
Но най-важната разлика между настоящия инцидент и 404-ия е, че докато отстранявахме последиците от пожара, потребителите все още комуникираха и правеха видео обаждания в , играеха игри, слушаха музика, подаряваха си подаръци, гледаха видеа, сериали и канали в , а също така стриймваха в .
Как преминават вашите инциденти?
Източник: habr.com
