

Предговор
Съществува такава проста и много полезна утилита — , и така се случи, че тя отдавна се е утвърдила в нашия производствен процес (за съжаление не успях да инсталирам нейната версия, но тя със сигурност не беше последната налична). Използваме я по предназначение — за изграждане на бинарни пачове. Ако погледнем какво има в репозитория, става малко тъжно: той всъщност е отдавна забравен и много от нещата там са остарели (някога там бяха направени няколко поправки от моя бивш колега, но това беше преди дълго време). Съобщих на себе си, че трябва да възобновя проекта: направих форк, изхвърлих това, което не планирам да използвам, и пренесох проекта на , инлайнвах "горещите" микро функции, премахнах големи масиви от стека (и масиви с променлива дължина, от които откровено "боцка"), стартирах профилировщика отново — и разбрах, че около 40% от времето се изразходва за …
Какво става с fwrite?
В този код fwrite (в моя конкретен тестови случай: изграждане на пач между близки 300 Мб файлове, входните данни са напълно в паметта) се извиква милиони пъти с малък размер на буфера. Очевидно е, че това нещо ще забави, затова исках някак да повлияя на това безобразие. Внедряването на различни източници на данни, асинхронен вход-изход все още не е в плановете ми, исках да намеря по-просто решение. Първото, което ми дойде на ум — да увелича размера на буфера
setvbuf(file, nullptr, _IOFBF, 64* 1024)но значително подобрение на резултата не получих (сега на fwrite се падаше около 37% от времето) — значи става дума не за честа запис на данни на диска. Заглеждайки "под капота" на fwrite, може да се види, че вътрешно се извършва lock/unlock на FILE структурата приблизително така (псевдокод, целият анализ беше проведен под Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Ако се вярва на профилировщика, на _fwrite_nolock се пада само 6% от времето, останалото е оверхед. В моя конкретен случай потокобезопасността е явно излишество, на което ще се жертвам, заменяйки извикването на fwrite с — дори с аргументи не трябва да се лъжем. В крайна сметка: тази проста манипулация значително намали разходите за запис на резултата, които в първоначалната версия съставляваха почти половината от времевите разходи. Между другото, в света на POSIX има аналогична функция — . Всъщност същото важи и за fread. По този начин с помощта на два #define можем да получим напълно кросплатформено решение без излишни блокировки, ако те не са необходими (което често се случва).
fwrite, _fwrite_nolock, setvbuf
Нека се абстрахираме от оригиналния проект и да се занимаваме с тестването на конкретен случай: запис на голям файл (512 Мб) в изключително малки части — по 1 байт. Тестовата система: AMD Ryzen 7 1700, 16 Гб RAM, HDD 7200 rpm 64 Мб кеш, Windows 10 1809, бинарният файл беше компилиран 32-битов, оптимизациите бяха включени, библиотеката беше статично свързана.
Пример за провеждане на експеримента:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Като променливи ще използваме TEST_BUFFER_SIZE, а също така за двойка случаи ще заменим fwrite_unlocked с fwrite. Нека започнем със случая fwrite без явна настройка на размера на буфера (ще коментираме setvbuf и свързания код): време 27048906 мкс, скорост на запис — 18.93 Мб/с. Сега ще зададем размера на буфера на 64 Кб: време — 25037111 мкс, скорост — 20.44 Мб/с. Сега ще тестваме работата на _fwrite_nolock без извикване на setvbuf: 7262221 мкс, скорост — 70.5 Мб/с!
След това ще експериментираме с размера на буфера (setvbuf):
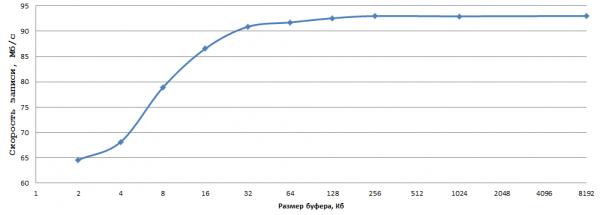
Данните са получени като средно от 5 експеримента, не ми се занимаваше да смятам грешките. Според мен, 93 Мб/с при запис по 1 байт на обикновен HDD — това е много добър резултат, просто трябва да изберем оптимален размер на буфера (в моя случай 256 Кб — идеален е) и да заменим fwrite с _fwrite_nolock/fwrite_unlocked (в случай, че потоковата безопасност не е необходима, разбира се).
Аналогично с fread в подобни условия. Тъй като нямам „желязна“ машина с linux на разположение (едноплатните не се считат), реших да проведа ограничен експеримент на виртуална машина (Hyper-V, OpenSUSE 15, GCC 8.3.1) — закономерността, в принцип, е същата: „чистият“ fwrite 20 Мб/с, fwrite + буфер от 256 Кб даде 23 Мб/с, fwrite_unlocked с такъв буфер — 35 Мб/с (бинарен файл 64-битов, компилиран с g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Следсловие
Целта на написването на тази статия беше да опиша един прост и ефективен приращение, който в много случаи може да бъде полезен (функциите _fwrite_nolock/fwrite_unlocked не са ми известни, но не е нужно да се подценяват). Не претендирам за новост на материала, но се надявам, че статията ще бъде полезна за общността.
Източник: habr.com
