

В тази статия ще обясня как за 30 минути да настроим среда за машинно обучение, да създадем невронна мрежа за разпознаване на изображения и след това да стартираме същата мрежа на графичен процесор (GPU).
Първо, нека определим какво е невронна мрежа.
В нашия случай това е математически модел, а също и неговото софтуерно или хардуерно представяне, изградена на принципа на организация и функциониране на биологични невронни мрежи — мрежи от нервни клетки на жив организъм. Това понятие възникна при изучаването на процесите, протичащи в мозъка, и при опити за моделиране на тези процеси.
Невронните мрежи не се програмират в обичайния смисъл на думата, те се обучават. Возможността за обучение е едно от основните предимства на невронните мрежи пред традиционните алгоритми. Технически, обучението се състои в намирането на коефициенти на връзките между невроните. В процеса на обучение невронната мрежа е способна да открива сложни зависимости между входните и изходните данни, а също така да извършва обобщаване.
От гледна точка на машинното обучение, невронната мрежа представлява специален случай на методите за разпознаване на образи, дискриминантен анализ, методи за клъстериране и други методи.
Оборудване
Първо, нека разберем оборудването. Необходим ни е сървър с инсталирана операционна система Linux. Оборудването за работа на системите за машинно обучение трябва да бъде доста мощно и следователно скъпо. На тези, които нямат добра машина под ръка, препоръчвам да се насочат към предложения на облачни доставчици. Необходимият сървър може бързо да бъде нает и да се плаща само за времето на използване.
В проекти, където е необходимо създаването на невронни мрежи, аз използвам сървъри на един от руснаците облачни доставчици. Компанията предлага под наем облачни сървъри специално за машинно обучение с мощни графични процесори (GPU) Tesla V100 от NVIDIA. Казано накратко: използването на сървър с GPU може да бъде десетки пъти по-ефективно (бързо) в сравнение с аналогичен по цена сървър, където за изчисленията се използва CPU (познатият централния процесор). Това се постига благодарение на особеностите на архитектурата на GPU, която по-бързо се справя с изчисленията.
За да изпълним примерите, описани по-долу, купихме такъв сървър за няколко дни:
- SSD диск 150 ГБ
- ОЗУ 32 ГБ
- Процесор Tesla V100 16 Gb с 4 ядра
На машината беше инсталиран Ubuntu 18.04.
Инсталираме средата
Сега ще инсталираме всичко необходимо за работа на сървъра. Тъй като статията е предимно за начинаещи, ще говоря за някои моменти, които ще им бъдат полезни.
Много от работата по настройката на средата се извършва чрез командния ред. Повечето потребители използват Windows като работна ОС. Стандартната конзола в тази ОС е недостатъчна. Затова ще използваме удобния инструмент . Свали мини версията и стартирай Cmder.exe. След това е необходимо да се свържем към сървъра по SSH протокол:
ssh root@server-ip-or-hostnameВместо server-ip-or-hostname посочете IP адреса или DNS името на вашия сървър. След това въведете паролата и при успешно свързване трябва да получим подобно съобщение.
Welcome to Ubuntu 18.04.3 LTS (GNU/Linux 4.15.0-74-generic x86_64)Основният език за разработка на ML модели е Python. Най-популярната платформа за неговото използване в Linux е .
Ще я инсталираме на нашия сървър.
Започваме с обновление на локалния мениджър на пакети:
sudo apt-get updateИнсталираме curl (инструмент за команден ред):
sudo apt-get install curlСваляме последната версия на Anaconda Distribution:
cd /tmp
curl –O https://repo.anaconda.com/archive/Anaconda3-2019.10-Linux-x86_64.sh
Стартиране на инсталацията:
bash Anaconda3-2019.10-Linux-x86_64.shПо време на инсталацията ще трябва да потвърдите лицензионното споразумение. При успешна инсталация ще видите следното:
Thank you for installing Anaconda3!За разработка на ML модели в момента са създадени множество фреймворкове, ние работим с най-популярните: и .
Използването на фреймворк позволява да се увеличи скоростта на разработка и да се използват вече готови инструменти за стандартни задачи.
В този пример ще работим с PyTorch. Ще го инсталираме:
conda install pytorch torchvision cudatoolkit=10.1 -c pytorchСега е необходимо да стартираме Jupyter Notebook — популярен инструмент за разработка при ML специалистите. Той позволява да пишете код и веднага да виждате резултатите от изпълнението му. Jupyter Notebook е част от Anaconda и вече е инсталиран на нашия сървър. Необходимо е да се свържем с него от нашата работна система.
За целта първо ще стартираме Jupyter на сървъра, указвайки порт 8080:
jupyter notebook --no-browser --port=8080 --allow-rootСледва да отворим в нашата конзола Cmder още една таб (горно меню — New console dialog) и да се свържем по порт 8080 с сървъра през SSH:
ssh -L 8080:localhost:8080 root@server-ip-or-hostnameПри въвеждане на първата команда ще ни бъдат предложени връзки за отваряне на Jupyter в нашия браузър:
За достъп до ноутбука, отворете този файл в браузър:
        file:///root/.local/share/jupyter/runtime/nbserver-18788-open.html
    Или копирайте и поставете едно от тези URL:
        http://localhost:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
     или http://127.0.0.1:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
Нека използваме връзката за localhost:8080. Копирайте целия път и го поставете в адресната лента на локалния браузър на вашия компютър. Jupyter Notebook ще се отвори.
Ще създадем нов ноутбук: New — Notebook — Python 3.
Нека проверим правилната работа на всички компоненти, които инсталирахме. Въведете в Jupyter примерен код за PyTorch и стартирайте изпълнението (бутон Run):
from __future__ import print_function
import torch
x = torch.rand(5, 3)
print(x)
Резултатът трябва да изглежда приблизително така:
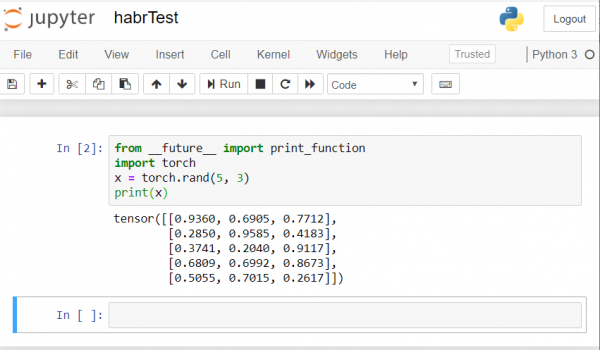
Ако имате аналогичен резултат — значи всичко е конфигурирано правилно и можем да започнем разрабатка на невронна мрежа!
Създаваме невронна мрежа
Ще създадем невронна мрежа за разпознаване на изображения. За основа ще вземем това .
За обучение на мрежата ще използваме публичния набор от данни CIFAR10. Той съдържа класове: „самолет“, „автомобил“, „птица“, „котка“, „олень“, „куче“, „жабка“, „кон“, „кораб“, „камион“. Изображенията в CIFAR10 са с размер 3x32x32, т.е. 3-канални цветни изображения с размер 32×32 пиксела.
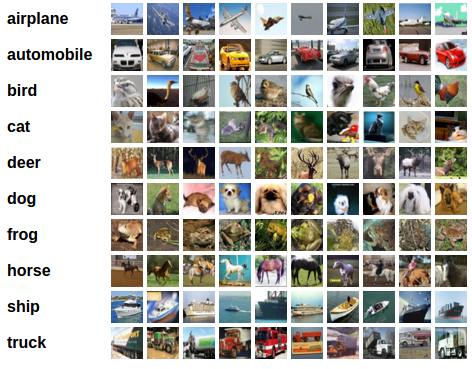
За работа ще използваме създадения пакет на PyTorch за работа с изображения — torchvision.
Ще следваме следните стъпки по ред:
- Зареждане и нормализиране на обучаващите и тестовите набори от данни
- Определяне на невронната мрежа
- Обучение на мрежата с обучаващите данни
- Тестване на мрежата с тестовите данни
- Повтаряме обучението и тестването с използване на GPU
Целият по-долу приведен код ще изпълним в Jupyter Notebook.
Зареждане и нормализиране на CIFAR10
Копирайте и изпълнете в Jupyter следния код:
import torch
import torchvision
import torchvision.transforms as transforms

transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=4,
                                         shuffle=False, num_workers=2)

classes = ('самолет', 'кола', 'птица', 'кот',
           'олень', 'собака', 'лягушка', 'лошадь', 'корабль', 'грузовик')
Отговорът трябва да бъде такъв:
Изтегляне на https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz в ./data/cifar-10-python.tar.gz
Разархивиране на ./data/cifar-10-python.tar.gz в ./data
Файловете вече са изтеглени и проверени
Нека визуализираме няколко тренировъчни образа за проверка:
import matplotlib.pyplot as plt
import numpy as np

# функции за показване на изображение

def imshow(img):
    img = img / 2 + 0.5     # ненормализиране
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()

# вземаме някои случайни тренировъчни изображения
dataiter = iter(trainloader)
images, labels = dataiter.next()

# показваме изображения
imshow(torchvision.utils.make_grid(images))
# печатаме етикети
print(' '.join('%5s' % classes[labels[j]] for j in range(4)))
Определяне на невронната мрежа
Нека първо да разгледаме как работи невронната мрежа за разпознаване на изображения. Това е проста мрежа с пряка връзка. Тя приема входни данни, преминава ги през няколко слоя един след друг, а след това, накрая, извежда изход.
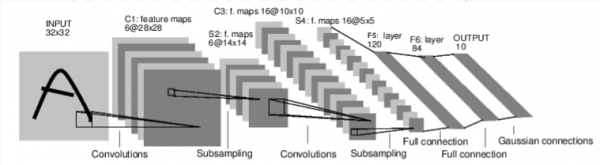
Нека създадем подобна мрежа в нашата среда:
import torch.nn as nn
import torch.nn.functional as F

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

net = Net()
Нека определим и функция за загуба и оптимизатор
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Обучение на мрежата с обучаващите данни
Започваме тренировката на нашата невронна мрежа. Обърнете внимание, че след като стартирате този код, ще трябва да изчакате известно време, за да завърши операцята. При мен отне 5 минути. За обучението на мрежата е необходимо време.
 за епоха в диапазона(2): # цикъл върху набора от данни многократно

 текуща_губа = 0.0
 за i, данни в изброяването(trainloader, 0):
 # получаване на входовете; данните са списък от [входове, етикети]
 входове, етикети = данни

 # нулиране на градиентите на параметрите
 optimizer.zero_grad()

 # напред + назад + оптимизация
 изходи = net(входове)
 загуба = criterion(изходи, етикети)
 загуба.backward()
 optimizer.step()

 # печат на статистики
 текуща_губа += загуба.item()
 ако i % 2000 == 1999: # печат на всеки 2000 мини-пакета
 print('[%d, ] загуба: %.3f' %
 (epoch + 1, i + 1, текуща_губа / 2000))
 текуща_губа = 0.0

print('Обучението приключи')
Ще получим такъв резултат:
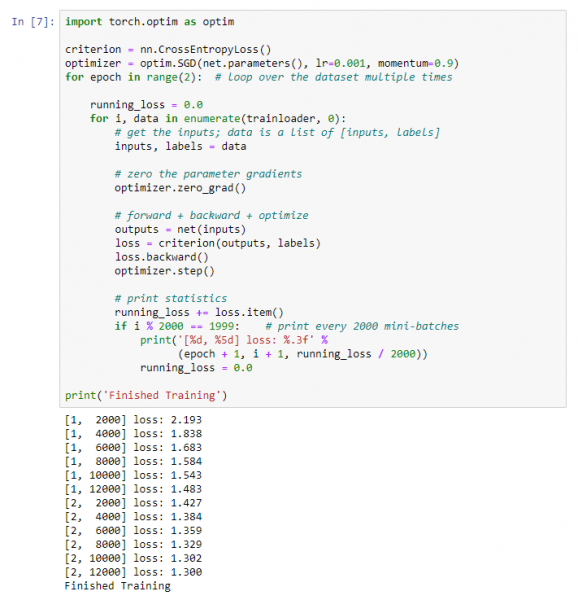
Запазваме нашия обучен модел:
PATH = './cifar_net.pth'
torch.save(net.state_dict(), PATH)
Тестване на мрежата с тестовите данни
Ние обучихме мрежата, използвайки набор от обучаващи данни. Но трябва да проверим дали мрежата всъщност е научила нещо.
Ще проверим това, като предскажем етикета на класа, който изходи невронната мрежа, и я проверим за истинност. Ако прогнозата е вярна, добавяме образеца в списъка на правилните прогнози.
Нека да покажем изображение от тестовия набор:
dataiter = iter(testloader)
изображения, етикети = dataiter.next()

# отпечатваме изображения
imshow(torchvision.utils.make_grid(изображения))
print('ИстинскаИстина: ', ' '.join('%5s' % classes[етикети[j]] за j в обхвата(4))) 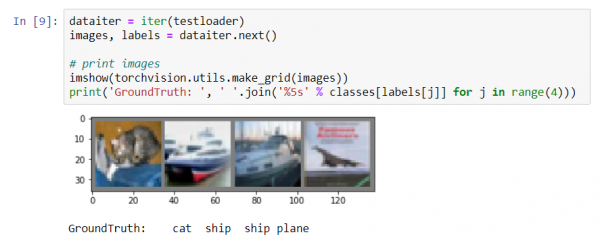
Сега да помолим невронната мрежа да ни каже какво е на тези картинки:
net = Net()
net.load_state_dict(torch.load(PATH))

изходи = net(изображения)

_, предсказано = torch.max(изходи, 1)

print('Предсказано: ', ' '.join('%5s' % classes[предсказано[j]]
                              за j в обхвата(4)))
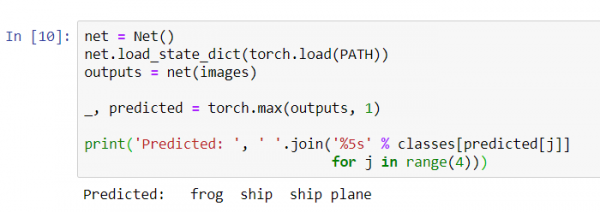
Резултатите изглеждат доста добри: мрежата правилно определи три картинки от четирите.
Нека да видим как мрежата работи върху целия набор от данни.
правилно = 0
общо = 0
с torch.no_grad():
    за данни в testloader:
        изображения, етикети = данни
        изходи = net(изображения)
        _, предсказано = torch.max(изходи.data, 1)
        общо += етикети.size(0)
        правилно += (предсказано == етикети).sum().item()

print('Точността на мрежата върху 10000 тестови изображения: %d %%' % (
100 * правилно / общо)) 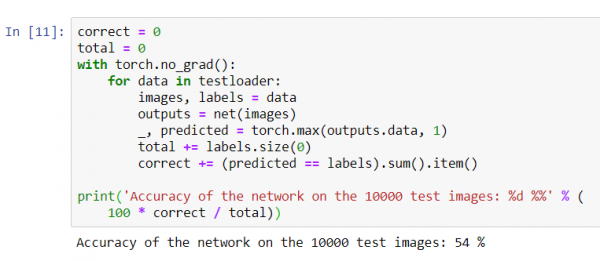
Изглежда, че мрежата знае нещо и функционира. Ако тя класифицираше класовете на случаен принцип, точността щеше да е 10%.
Сега да видим кои класове мрежата определя по-добре:
class_correct = list(0. for i in range(10))
class_total = list(0. for i in range(10))
с с torch.no_grad():
 за данни в testloader:
 изображения, етикети = данни
 изходи = net(изображения)
 _, предсказано = torch.max(изходи, 1)
 c = (предсказано == етикети).squeeze()
 за i в диапазона(4):
 етикет = етикети[i]
 class_correct[етикет] += c[i].item()
 class_total[етикет] += 1


за i в диапазона(10):
 print('Точност на %5s : %%' % (
класове[i], 100 * class_correct[i] / class_total[i])) 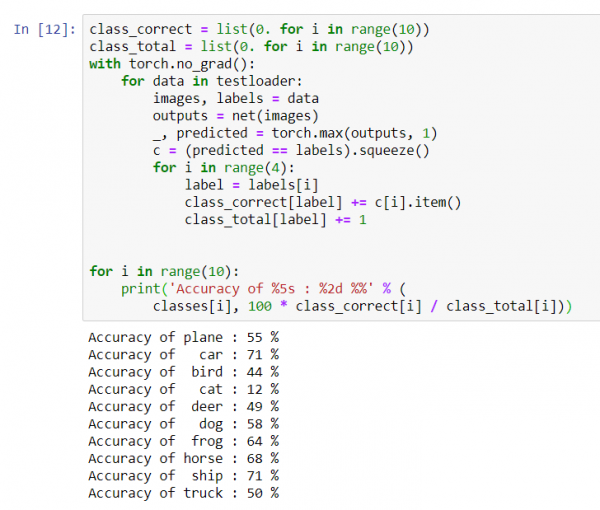
Изглежда, че мрежата определя най-добре автомобили и кораби: 71% точност.
Така че мрежата работи. Сега да опитаме да пренесем нейното функциониране на графичния процесор (GPU) и да видим какво ще се променя.
Обучение на невронна мрежа на GPU
Първо, нека да обясня накратко какво е CUDA. CUDA (Compute Unified Device Architecture) е платформа за паралелни изчисления, разработена от NVIDIA, за общи изчисления на графични процесори (GPU). С помощта на CUDA разработчиците могат значително да ускорят изчислителните приложения, използвайки възможностите на графичните процесори. На нашия сървър, който закупихме, тази платформа вече е инсталирана.
Нека първо определим нашия GPU като първо видимо устройство cuda.
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
# Примерно, ако сме на CUDA машина, това трябва да отпечата устройство CUDA:
print(device) 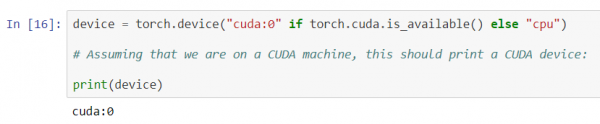
Изпращаме мрежата на GPU:
net.to(device)Също така ще трябва да изпращаме входовете и целите на всяка стъпка и в GPU:
inputs, labels = data[0].to(device), data[1].to(device)Да стартираме повторно обучението на мрежата вече на GPU:
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
за епоха в диапазона(2): # цикъл върху набора от данни многократно

 текуща_губа = 0.0
 за i, данни в изброяването(trainloader, 0):
 # получаване на входовете; данните са списък от [входове, етикети]
 входове, етикети = данни[0].to(device), данни[1].to(device)

 # нулиране на градиентите на параметрите
 optimizer.zero_grad()

 # напред + назад + оптимизация
 изходи = net(входове)
 загуба = criterion(изходи, етикети)
 загуба.backward()
 optimizer.step()

 # печат на статистики
 текуща_губа += загуба.item()
 ако i % 2000 == 1999: # печат на всеки 2000 мини-пакета
 print('[%d, ] загуба: %.3f' %
 (epoch + 1, i + 1, текуща_губа / 2000))
 текуща_губа = 0.0

print('Обучението приключи')
Този път обучението на мрежата продължи около 3 минути. Напомняме, че същият етап на обикновен процесор отне 5 минути. Разликата не е съществени, това се случва, защото нашата мрежа не е толкова голяма. При използване на големи масиви за обучение разликата в скоростта между GPU и традиционен процессор ще нараства.
На този етап изглежда всичко. Какво успяхме да постигнем:
- Разгледахме какво е GPU и избрахме сървър, на който е инсталиран;
- Настроихме софтуерната среда за създаване на невронна мрежа;
- Създадохме невронна мрежа за разпознаване на изображения и я обучихме;
- Повторихме обучението на мрежата с използване на GPU и получихме увеличение на скоростта.
Ще се радвам да отговоря на въпросите в коментарите.
Източник: habr.com
