

Здравейте на всички, споделяме с вас втората част на публикацията "Виртуални файлови системи в Linux: защо са необходими и как работят?" Първата част може да бъде прочетена . Напомняме, че тази серия публикации е посветена на старта на нов поток по курса , който започва съвсем скоро.
Как да наблюдаваме VFS с помощта на инструменти eBPF и bcc
Най-лесният начин да разберем как ядрото работи с файловете sysfs – е да го наблюдаваме на практика, а най-лесният начин да наблюдаваме ARM64 е да използваме eBPF. eBPF (съкратено от Berkeley Packet Filter) се състои от виртуална машина, работеща в , която привилегированите потребители могат да заявяват (query) от командния ред. Източниците на ядрото информират читателя какво може да направи ядрото; стартирането на инструментите eBPF в натоварена система показва какво всъщност прави ядрото.
За щастие, започването на работа с eBPF е доста лесно с помощта на инструментите , които са налични като пакети от общия дистрибутив и са подробно документирани . Инструментите bcc са скриптове на Python с малки вмъквания на C код, което означава, че всеки, който е запознат с двата езика, може лесно да ги модифицира. В bcc/tools има 80 Python скрипта, а това означава, че вероятно разработчикът или системният администратор може да намери нещо подходящо за решаване на задачата.
За да получите поне повърхностно разбиране за това каква работа вършат VFS в работещата система, опитайте vfscount или vfsstat. Това ще покаже, например, че десетки извиквания vfs_open() и "неговите приятели" се случват буквално всяка секунда.
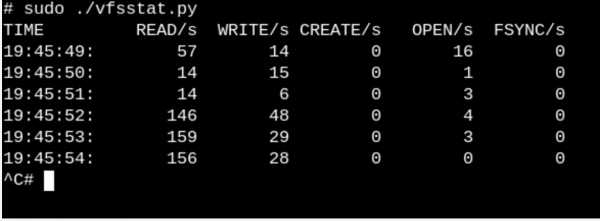
vfsstat.pyе скрипт на Python, с вмъквания на C код, който просто брои извикванията на функциите на VFS.
Нека дадем един по-тривиален пример и видим какво се случва, когато включим USB флаш памет в компютъра и системата я открива.
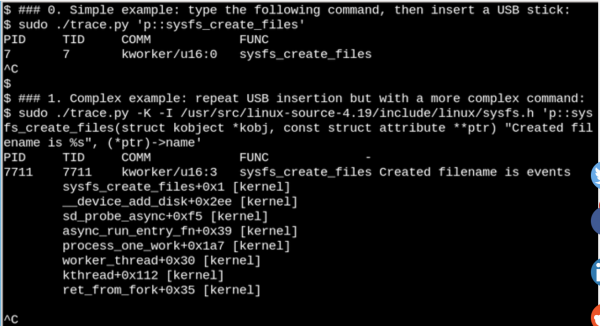
С помощта на eBPF можем да видим какво се случва в
/sys, когато е включена USB флаш памет. Тук е показан прост и сложен пример.
В примера, показан по-горе, bcc инструментът извежда съобщение, когато се стартира командата sysfs_create_files(). Виждаме, че sysfs_create_files() е стартирано с помощта на kworker потока в отговор на това, че флашката е включена, но какъв файл е създаден при това? Вторият пример показва цялата мощ на eBPF. Тук trace.py извежда обратен трасировъчен контекст на ядрото (kernel backtrace) (опция -K) и името на файла, който е бил създаден sysfs_create_files(). Вмъкването в единични изрази – това е код на C, включващ лесно разпознаваема форматна низ, осигурена от Python скрипт, който стартира LLVM just-in-time компилатор. Този низ той компилира и изпълнява във виртуална машина вътре в ядрото. Пълната сигнатура на функцията sysfs_create_files () трябва да бъде възпроизведена во втората команда, за да може форматовият низ да се отнася за един от параметрите. Грешките в този фрагмент от код на C водят до разпознаваеми грешки на компилатора на C. Например, ако параметърът -l бъде пропуснат, ще видите "Failed to compile BPF text." Разработчиците, които са добре запознати с C и Python, ще намерят инструментите bcc лесни за разширяване и изменение.
Когато USB устройство е включено, обратният трасировъчен контекст на ядрото ще покаже, че PID 7711 – това е поток kworker, който е съ創ил файла "events" в sysfs. Съответно, извикването с sysfs_remove_files() ще покаже, че изтеглянето на устройството е довело до изтриването на файла events, което съответства на общата концепция за броене на референции. В този случай прегледът sysfs_create_link () с eBPF по време на включване на USB устройство ще покаже, че са създадени най-малко 48 символни връзки.
Какъв е смисълът на файла events? Използването на за търсене на , показва, че тя извиква disk_add_events (), и или "media_change", или "eject_request" могат да бъдат записани в файл събития. Тук блоковият слой на ядрото информира потребителското пространство за появата и извличането на "диск". Обърнете внимание колко информативен е този метод на разследване на примера на включване на USB устройство в сравнение с опити за разбиране как всичко работи, единствено от изходния код.
Кореновите файлови системи само за четене правят възможни вградените устройства
Разбира се, никой не изключва сървъра или компютъра си, изтегляйки щепсела от контакта. Но защо? Всичко е заради това, че монтираните файлови системи на физически устройства за съхранение може да имат отложени записи, а структурите от данни, записващи състоянието им, може да не се синхронизират с записите в хранилището. Когато това се случи, собствениците на системи трябва да изчакат следващото зареждане, за да стартират утилитата fsck filesystem-recovery и, в най-лошия случай, да загубят данни.
Все знаем, что много IoT устройства, както и рутери, термостати и автомобили, сега работят с Linux. Много от тези устройства практически нямат потребителски интерфейс и няма начин да ги изключите "чисто". Представете си запалването на автомобил с изтощена батерия, когато захранването на управляващото устройство постоянно скача нагоре-надолу. Как се случва, че системата се зарежда без дълго fsck, когато двигателят най-накрая започне да работи? Отговорът е прост. Вградените устройства разчитат на кореновата файлова система (съкращение ro-rootfs (read-only root filesystem).
ro-rootfs предлагат множество предимства, които са по-малко очевидни от оригиналността. Едно от предимствата е, че зловредният софтуер не може да записва в /usr или /lib, ако никакъв процес на Linux не може да пише там. Друго е, че до голяма степен неизменяемата файлова система е от решаващо значение за полевата поддръжка на отдалечени устройства, тъй като помощният персонал използва локални системи, които на практика са идентични на системите на място. Може би най-важното (но и най-коварното) предимство е, че ro-rootfs принуждава разработчиците да решават кои системни обекти ще останат неизменяеми, още на етапа на проектиране на системата. Работата с ro-rootfs може да бъде неудобна и болезнена, както често се случва с променливите const в програмните езици, но предимствата им лесно покриват допълнителните разходи.
Създаване rootfs само за четене изисква известни допълнителни усилия от разработчиците на вградени системи и тук на сцената излиза VFS. Linux изисква файловете в /var да бъдат достъпни за запис и освен това, много популярни приложения, които стартират вградени системи, ще се опитат да създадат конфигурационни dot-files в $HOME. Едно от решенията за конфигурационните файлове в домашната директория обикновено е тяхната предварителна генерация и изграждане в rootfs. За /var един от възможните подходи е да го монтирате в отделен дял, достъпен за запис, докато самият / монтира се само за четене. Друга популярна алтернатива е използването на свързващи или наслагващи монти (bind or overlay mounts).
Свързващи и наслагващи монти, използвани от контейнери
Изпълнение на командата man mount – най-добрият начин да научите за свързващите и наслагващите монти, които позволяват на разработчиците и системните администратори да създадат файлова система на един път и след това да предоставят на приложенията в друг. За вградени системи това означава възможността да съхранявате файлове в /var флаш памет, достъпна само за четене, но наслагвано или свързващо монтиране на пътя от tmpfs в /var по време на зареждане ще позволи на приложенията да записват бележки. При следващото включване промените в /var ще бъдат изгубени. Наслагванието създава обединение между tmpfs и долната файлова система и позволява да се правят видими предполагаеми промени в съществуващите файлове в ro-tootf докато свързващото монтиране може да направи нови празни tmpfs папки видими като достъпни за запис в ro-rootfs пътища. Докато overlayfs е правилния (proper) тип файлова система, свързващото монтиране е реализирано в .
На базата на описанието на наслагването и свързващото монтиране, никой не е изненадан, че активно ги използват. Нека наблюдаваме какво се случва, когато използваме за стартиране на контейнера, използвайки инструмента mountsnoop. от bcc.
Извикването system-nspawn стартира контейнера по време на работа mountsnoop.py..
Нека видим какво се получи:
Стартирането mountsnoop. по време на 'зареждането' на контейнера показва, че средата за изпълнение на контейнера е изключително зависима от свързващото монтиране (показва се само началото на дългия изход).
Тук systemd-nspawn предоставя избрани файлове в procfs и sysfs на хоста в контейнера като пътища в неговия rootfs. Освен MS_BIND флага, който установява свързващото монтиране, някои други флагове в монтираната система определят взаимовръзката между промените в пространството на имената на хоста и контейнера. Например, свързващото монтиране може или да пропусне измененията в /proc и /sys в контейнера, или да ги скрие в зависимост от извикването.
Заключение
Разбирането на вътрешната структура на Linux може да изглежда като непосилна задача, тъй като самото ядро съдържа огромно количество код, оставяйки настрана приложенията на потребителското пространство на Linux и интерфейсите за системни повици в библиотеките на C, като glibc. Един от начините да постигнете напредък е да прочетете изходния код на една подсистема на ядрото с акцент върху разбирането на системните повици и заглавията, насочени към потребителското пространство, както и основните вътрешни интерфейси на ядрото, например таблицата file_operations. Операциите с файлове осигуряват принципа „всичко е файл“, затова управлението им е особено приятно. Изходните файлове на ядрото на C в директорията на най-високо ниво fs/ представят реализация на виртуални файлови системи, които са слой обвивка, осигуряващ широка и сравнително лесна съвместимост на популярни файлови системи и устройства за съхранение. Монтирането чрез свързване и налагане през имената на пространствата на Linux е магията на VFS, която прави възможно създаването на контейнери и коренови файлови системи само за четене. В съчетание с изучаването на изходния код, инструментът за ядрото eBPF и неговия интерфейс bcc
правят изследването на ядрото по-лесно от всякога.
Приятели, пишете дали тази статия беше полезна за вас? Може би имате коментари или забележки? А за тези, които се интересуват от курса „Администратор Linux“, каним ви на , който ще се проведе на 18 април.
Източник: habr.com
