

Написването на тази статия беше предизвикано от многото материали за статичен анализ, които все по-често ми попадаха на очите. На първо място, това е , който активно се промотира в Хабра с рецензии на грешки, открити от техния инструмент в проекти с отворен код. Н Recent PVS-studio реализираха , и, разбира се, разработчиците на IntelliJ IDEA, чийто вграден анализатор е, вероятно, най-напредналият за Java в момента, .
При четене на такива рецензии се получава усещането, че става въпрос за вълшебен еликсир: натисни бутона и ето го — списъкът с дефекти пред очите ти. Изглежда, че с усъвършенстването на анализаторите все повече и повече бъгове автоматично ще бъдат откривани, а продуктите, сканирани от тези роботи, ще стават все по-добри, без никакви усилия от наша страна.
Но вълшебни еликсири не съществуват. Бих искал да говоря за неща, които обикновено не се обсъждат в постове от типа "ето какво може да намери нашият робот": какво не могат анализаторите, каква е тяхната реална роля и място в процеса на предоставяне на софтуер и как да ги внедряваме правилно.
Патент (източник: ).
) Какво никога не могат статичните анализатори
Какво представлява анализът на изходния код от практическа гледна точка? Подаваме определени изходни кодове и в кратък срок (значително по-кратък от изпълнението на тестовете) получаваме определена информация за нашата система. Принципното и математически непреодолимо ограничение е, че по този начин можем да получим само доста тесен клас информация.
Най-известният пример за задача, която не може да бъде решена с помощта на статичен анализ — : това е теорема, която доказва, че не е възможно да се разработи общ алгоритъм, който по изходния код на програмата да определи дали тя ще влезе в безкраен цикъл или ще завърши за краен период от време. Разширение на тази теорема е , която, за всяко нетривиално свойство на изчислимите функции, определява дали произволна програма изчислява функция с такова свойство, е алгоритмично неразрешима задача. Например, невъзможно е да се напише анализатор, който, по произволен изходен код, определя дали анализираната програма е имплементация на алгоритъм, който изчислява, да речем, повдигането на цяло число на квадрат.
Следователно, функционалността на статичните анализатори има непреминаеми ограничения. Статичният анализатор никога не може във всички случаи да определи такива неща, като например възникването на «null pointer exception» в езици, допускащи стойност null, или във всички случаи да определи възникването на «attribute not found» в езици с динамична типизация. Всичко, което може най-съвършеният статичен анализатор, е да открива частни случаи, които са капка в морето в сравнение с всички възможни проблеми с вашия изходен код.
Статичният анализ не е търсене на грешки
От горепосоченото следва извод: статичният анализ не е средство за намаляване на броя на дефектите в програмата. Рискувам да твърдя: когато бъде приложен за първи път към вашия проект, той ще намери „интересни“ места в кода, но най-вероятно няма да открие никакви дефекти, влияещи на качеството на работата на вашата програма.
Примери за дефекти, автоматично открити от анализаторите, впечетляват, но не трябва да забравяме, че тези примери са намерени чрез сканиране на голям набор от големи кодови бази. По същия принцип хакерите, имайки възможност да проверят няколко прости пароли на много акаунти, в крайна сметка откриват акаунти с прости пароли.
Дали това означава, че не трябва да прилагаме статичен анализ? Разбира се, че не! И точно по същата причина, поради която е добре да проверявате всяка нова парола за попадения в черен списък с «прости» пароли.
Статичният анализ е повече от търсене на грешки
Всъщност, практически решаемите задачи, анализирани с помощта на статичен анализ, са много по-широки. Накратко, статичният анализ е всяка проверка на изходния код, извършвана преди стартирането му. Ето някои неща, които можете да правите:
- Проверка на стилове кодиране в най-широкия смисъл на термина. Включва както проверка на форматирането, така и търсене на ненужни скоби, задаване на прагови стойности за метрики като брой редове или цикломатична сложност на метода и т.н. — всичко, което потенциално затруднява четимостта и поддръжката на кода. В Java такъв инструмент е Checkstyle, а в Python — flake8. Програмите от този род обикновено се наричат „линтери“.
- Не само изпълняемият код може да бъде анализиран. Ресурсни файлове, като JSON, YAML, XML, .properties, могат (и трябва!) да бъдат автоматично проверявани за валидност. Все пак, по-добре е да разбереш, че структурата на JSON е нарушена заради някои непарни кавички на ранен етап от автоматичната проверка на Pull Request, отколкото при изпълнението на тестове или в Run time? Налице са съответните инструменти: например, , .
- Компилирането (или парсингът за динамични езици за програмиране) също е вид статичен анализ. Обикновено компилаторите могат да дават предупреждения, сигнализиращи за проблеми с качеството на изходния код, и не бива да се игнорират.
- Понякога компилирането не е само компилиране на изпълняемия код. Например, ако имате документация в формат , то в момента на трансформирането ѝ в HTML/PDF, обработчикът AsciiDoctor () може да дава предупреждения, например за нарушени вътрешни линкове. И това е съществена причина да не бъде приет Pull Request с изменения в документацията.
- Проверка на правописа също е вид статичен анализ. Утилитата може да проверява правописа не само в документацията, но и в изходния код на програмите (коментарите и литералите) на различни езици за програмиране, включително C/C++, Java и Python. Грешка в правописа в потребителския интерфейс или документацията също е дефект!
- Конфигурационните тестове (за това какво е това — вижте и доклади), макар и да се изпълняват в среда на модули за тестване като pytest, всъщност също представляват вид статичен анализ, тъй като не изпълняват изходния код по време на своето изпълнение.
Както виждаме, търсенето на бъгове в този списък заема най-малко важна роля, докато всичко останало е достъпно чрез използването на безплатни open source инструменти.
Кои от тези типове статичен анализ трябва да се прилагат във вашия проект? Разбира се, всички, колкото повече - толкова по-добре! Най-важното е да го внедрите правилно, за което ще говорим по-нататък.
Доставъчният канал като многостепенен филтър и статичният анализ като неговия първи каскад.
Класическата метафора за непрекъснатата интеграция е тръбопровод (pipeline), през който преминават промените - от промяната на изходния код до доставката в production. Стандартната последователност от етапи на този конвейер изглежда така:
- статичен анализ
- компилация
- модулни тестове
- интеграционни тестове
- UI тестове
- ръчна проверка
Промените, отхвърлени на N-ия етап на конвейера, не преминават на етап N+1.
Защо точно така, а не иначе? В тази част от конвейера, която касае тестването, тестерите се запознават с широко известната пирамида на тестването.
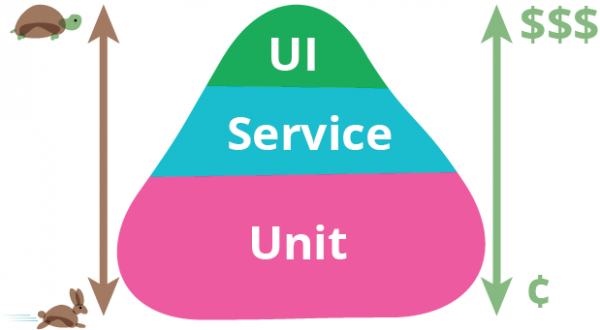
Тестова пирамида. Източник: Мартин Фаулър.
В долната част на тази пирамида се разполагат тестовете, които са по-лесни за писане, които се изпълняват по-бързо и нямат тенденция за фалшиви сработвания. Поради това те трябва да бъдат повече, да покриват повече код и да се изпълняват първи. В горната част на пирамидата всичко е обратно, затова броят на интеграционните и UI тестове трябва да бъде намален до необходимия минимум. Човекът в тази верига е най-скъпият, бавен и ненадежден ресурс, затова той е накрая и извършва работа само ако предишните етапи не са открили никакви дефекти. Въпреки това, по същите принципи се изгражда конвейерът и в части, които не са директно свързани с тестването!
Искам да предложа аналогия под формата на многокаскадна система за филтриране на вода. На входа постъпва мръсна вода (промени с дефекти), а на изхода трябва да получим чиста вода, от която са отстранени всички нежелани замърсявания.
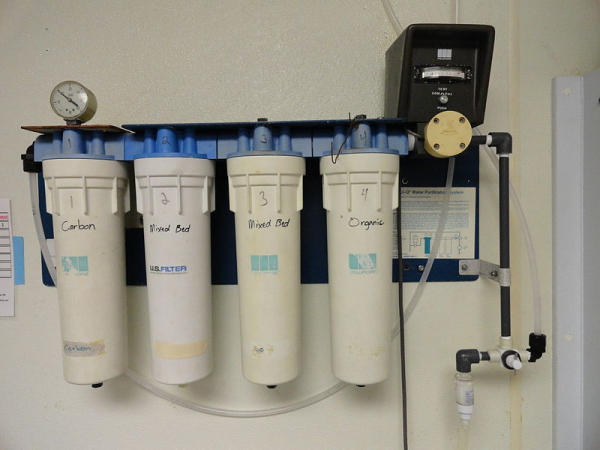
Многостепенен филтър. Източник:
Както е известно, почистващите филтри са проектирани така, че всеки следващ каскад може да премахне все по-малки частици замърсявания. При това, каскадите за груба обработка имат по-голям капацитет и по-ниска цена. В нашата аналогия това означава, че входните quality gates имат по-висока производителност, изискват по-малко усилия за стартиране и сами по себе си са по-малко взискателни в работата — и точно в такава последователност са подредени. Ролята на статичния анализ, който, както сега разбираме, може да отстранява само най-грубите дефекти — е ролята на решетката-„мръсотия“ в самото начало на каскада от филтри.
Статичният анализ сам по себе си не подобрява качеството на крайния продукт, както „мръсотията“ не прави водата питейна. И въпреки това, в общата връзка с другите елементи на конвейера, неговата важност е очевидна. Въпреки че в многокаскадния филтър изходните каскади потенциално могат да уловят всичко, което и входните — е ясно какви последици ще доведе опитът за справяне само с каскади за финно почистване, без входните каскади.
Целта на „мръсотията“ е да облекчи последващите каскади от улавяне на съвсем груби дефекти. Например, поне човекът, извършващ code review, не трябва да се отклонява от неправилно форматирания код и нарушаването на установените правила за кодиране (като например излишни скоби или твърде дълбоки вложени условия). Бъгове като NPE трябва да се уловят от модулните тестове, но ако още преди теста анализаторът ни посочи, че бъгът неминуемо ще се случи — това значително ще ускори неговото поправяне.
Предполагам, сега е ясно защо статичният анализ не подобрява качеството на продукта, ако се прилага епизодично, и трябва да се прилага постоянно за отстраняване на промените с груби дефекти. Въпросът дали ще подобри качеството на вашия продукт прилагането на статичен анализатор е приблизително равен на въпроса „ще се подобри ли питейното качество на водата, взета от мръсен водоем, ако я пропуснем през цедка?“
Внедряване в наследствени проекти
Важен практически въпрос: как да внедрим статичен анализ в процеса на непрекъсната интеграция като „quality gate“? Що се отнася до автоматизирани тестове, всичко е очевидно: има набор от тестове, провалянето на който и да е от тях е достатъчно основание да се счита, че сборката не е преминала quality gate. Опитите да се установи gate по резултатите от статичния анализ не дават резултати: на legacy-кода предупрежденията от анализа са твърде много, не искаме да ги игнорираме напълно, но също така е невъзможно да спрем доставката на продукта само защото в него има предупреждения от анализатора.
Когато бъде приложен за първи път, на който и да е проект, анализаторът издава огромно количество предупреждения, като подавляващото мнозинство от тях нямат отношение към правилното функциониране на продукта. Не е възможно веднага да се коригират всички тези забележки, а много от тях не са и нужни. В крайна сметка, ние знаем, че нашият продукт по принцип работи, и преди внедряването на статичен анализ!
В крайна сметка, много хора се ограничават до епизодично използване на статичен анализ, или го използват само в режим на информираност, когато при сборка просто се издава отчет на анализатора. Това е еквивалентно на отсъствието на всякакъв анализ, защото ако вече имаме множество предупреждения, то появата на още едно (колкото и сериозно да е) при промяна на кода остава незабелязано.
Известни са следните методи за въвеждане на quality gates:
- Настройване на лимит на общия брой предупреждения или броя на предупрежденията, разделен на броя редове код. Това не работи добре, тъй като такъв gate лесно допуска промени с нови дефекти, докато не бъде надвишен техният лимит.
- Фиксирането на всички стари предупреждения в кода като игнорирани в определен момент и отказът на сборката при възникване на нови предупреждения. Тази функционалност предоставя PVS-studio и някои онлайн ресурси, например Codacy. Не съм работил с PVS-studio, но що се отнася до опита ми с Codacy, основната им проблема е, че определянето на това коя е "стара" и коя "нова" грешка е доста сложно и не винаги работи правилно, особено ако файловете са силно променени или преименувани. Спомням си, че Codacy можеше да пропуска нови предупреждения в pull request, докато същевременно не допускаше pull request заради предупреждения, които не са свързани с промените в кода на този PR.
- На мое мнение, най-ефективното решение е описано в книгата "методът на зъбно колело" ("ratcheting"). Основната идея е, че свойството на всяко издание е броят на предупрежденията от статичен анализ и се допуска само такива промени, които не увеличават общия брой предупреждения.
Зъбно колело
Работи по следния начин:
- В началния етап се реализира запис в метаданните за изданието на броя предупреждения в кода, открити от анализаторите. По този начин, при сборката на основния клон във вашия мениджър на хранилища не се записва просто "издание 7.0.2", а "издание 7.0.2, съдържащо 100500 предупреждения от Checkstyle". Ако използвате напреднал мениджър на хранилища (като Artifactory), записването на такива метаданни за вашето издание е лесно.
- Сега всеки pull request при сборка сравнява броя на получените предупреждения с текущия брой в изданието. Ако PR води до увеличаване на това число, кодът не преминава quality gate по статичен анализ. Ако броят на предупрежденията намалява или остава същият — то преминава.
- При следващото издание, отново записаното количество предупреждения ще бъде записано в метаданните на изданието.
С постепенно, но неуклонно (подобно работе храповика), количество предупреждений будет стремиться к нулю. Конечно, систему можно обмануть, установив новое предупреждение, но исправив чужое. Это нормально, поскольку на длинной дистанции этот подход приносит результаты: предупреждения обычно исправляются не по одному, а сразу одной группой определённого типа, и все легко устраняемые предупреждения довольно быстро исчезают.
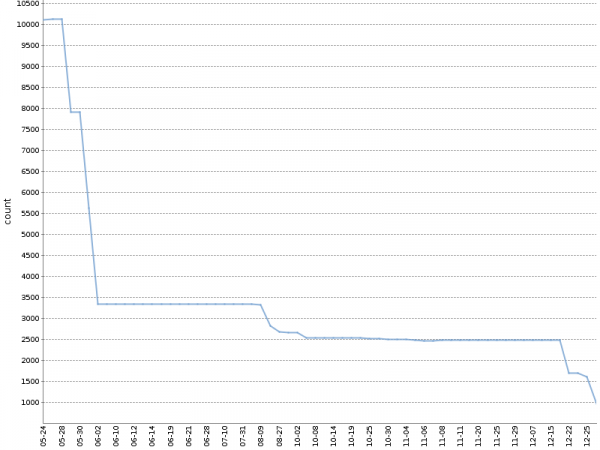
На этом графике представлено общее количество предупреждений Checkstyle за полгода работы такого «храповика» на Количество предупреждений уменьшилось в 10 раз, и это произошло естественным образом, параллельно с разработкой продукта!
Я использую модифицированную версию этого метода, отдельно подсчитывая предупреждения по модулям проекта и инструментам анализа. Формируемый при этом YAML-файл с метаданными о сборке выглядит примерно следующим образом:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
В любой продвинутой CI-системе «храповик» можно реализовать для любых инструментов статического анализа, не полагаясь на плагины и сторонние утилиты. Каждый из анализаторов выдаёт свой отчёт в простом текстовом или XML формате, который легко поддаётся анализу. Остаётся лишь прописать необходимую логику в CI-скрипте. Посмотреть, как это реализовано в наших open source проектах на базе Jenkins и Artifactory, можно или . Оба примера зависят от библиотеки : метод countWarnings() обычным образом подсчитывает xml-тэги в файлах, создаваемых Checkstyle и Spotbugs, а compareWarningMaps() реализует тот самый храповик, выбрасывая ошибку в случае, если количество предупреждений в какой-либо категории увеличивается.
Интересен вариант на реализация на „храповик“, който може да се използва за анализ на правописа на коментари, текстови литерали и документация с помощта на aspell. Както е известно, при проверка на правописа не всички непознати на стандартния речник думи са неправилни, те могат да бъдат добавени в потребителския речник. Ако направите потребителския речник част от изходния код на проекта, то quality gate по правописа може да бъде формулиран по следния начин: изпълнение на aspell с стандартен и потребителски речник. да открива никакви грешки в правописа.
За важността на фиксирането на версията на анализатора
В заключение, трябва да се отбележи следното: какъвто и начин да внедрите анализа в конвейера за доставка, версията на анализатора трябва да бъде фиксирана. Ако позволите самопроизвольно обновление на анализатора, при изграждане на следващия pull request могат да „изплупват“ нови дефекти, които не са свързани с промяната на кода, а с това, че новият анализатор просто може да открива повече дефекти — и това ще провали процеса на приемане на pull request-ите. Актуализацията на анализатора трябва да бъде осъзнато действие. Въпреки това, стриктното фиксиране на версията на всеки компонент на сборката е общо изискване и тема за отделен разговор.
Изводи
- Статичният анализ няма да намери бъгове и няма да подобри качеството на продукта ви при еднократно приложение. Положителният ефект за качеството идва единствено от постоянното му прилагане в процеса на доставка.
- Откриването на бъгове всъщност не е основна задача на анализа, огромното мнозинство от полезните функции са налични в opensource инструменти.
- Внедрявайте quality gates на база резултатите от статичния анализ още в самото начало на конвейера за доставка, използвайки „храповик“ за legacy код.
Връзки
- доклад за различни методи на анализ на кода (не само статичен!)
Източник: habr.com
