

Тази бележка ще бъде интересна за онези, които използват библиотеката за обработка на таблични данни за R — data.table, и може би ще се радват да видят гъвкавостта на нейното приложение на различни примери.
Вдъхновен от добър пример , и надявайки се, че вече сте прочели неговата статия, предлагам да задълбочим темата за оптимизация на кода и производителността на базата на data.table.
Въведение: откъде идва data.table?
Най-добре е да започнем запознанството си с библиотеката отдалеч, а именно от структурите данни, от които може да бъде произведен обект data.table (по-нататък, ДТ).
Масив
Код
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Една от тези структури е масив (?base::array). Както и в другите езици, масивите тук са многомерни. Въпреки това, интересното е, че например двумерният масив започва да наследява свойства от класа на матрицата (?base::matrix), а едномерният масив, което също е важно, не наследява от вектор (?base::vector).
При това трябва да се разбира, че типът данни, съдържащи се в някакъв обект, трябва да се проверява с функцията base::typeof, която връща вътрешното описание на типа според R Internals — общият протокол на езика, свързан с първоначалния C.
Още една команда, за определяне на класа на обекта, base::class, връща в случай на вектори векторния тип (той се различава по наименование от вътрешния, но също така позволява да се разбере типът данни).
Списък
От двумерния масив, той също така е матрица, можем да преминем към списък (?base::list).
Код
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
При това се случват няколко неща наведнъж:
- Второто измерение на матрицата се свива, тоест получаваме едновременно и списък, и вектор.
- Списъкът, така, наследява от тези класове. Трябва да имате предвид, че на елемент от списъка ще отговаря една (скаларна) стойност от клетката на матрицата-масив.
Благодарение на това, че списъкът е също и вектор, към него могат да се прилагат някои функции за вектори.
Датафрейм
От списък, матрица или вектор можем да преминем към датафрейм (?base::data.frame).
Код
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Какво е интересно в него: датафреймът наследява от списък! Колоните на датафрейма са клетки на списъка. Това ще бъде важно по-късно, когато започнем да използваме функции, приложими към списъци.
data.table
Получаването на ДТ (?data.table::data.table) може да бъде от датафрейм, списък, вектор или матрица. Например, по следния начин (in place).
Код
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Полезно е, че, както и датафреймът, ДТ наследява свойствата на списъка.
ДТ и паметта
В отличие от всех остальных объектов в R base, ДТ се предават по референция. Ако трябва да направите копие в нова област за памет, е необходима функция data.table::copy или е необходимо да се направи избор от стария обект.
Код
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
С това въведението приключва. ДТ е продължение на развитието на структурите от данни в R, което главно се извършва чрез разширяване и ускоряване на операциите, които се извършват над обектите от клас датафрейм. При това се запазва наследството от други примитиви.
Някои примери за използване на свойствата на data.table
Като списък…
Итерацията по редовете на датафрейм или ДТ не е най-добрата идея, тъй като кодът на цикъла на езика R е значително по-бавен C, но преминаването в цикъл по колоните, които обикновено са значително по-малко, е напълно възможно. Когато преминаваме по колоните, помним, че всяка колона е елемент от списъка, който обикновено съдържа вектор. А операциите върху векторите са добре векторизирани в основните функции на езика. Може също да се използват оператори за избор, характерни за списъците и векторите: `[[`, `$`.
Код
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Векторизация
Ако е необходимо да преминете по редовете на голям ДТ, най-доброто решение е да напишете функция с векторизация. Но ако това не е възможно, трябва да помним, че цикъла вътре ДТ все пак е по-бърз от цикъла в R, тъй като се изпълнява на C.
Нека опитаме с по-голям пример с 100К реда. Ще извлечем първата буква от думите, включени в вектор-колона w.
Updated
Код
library(magrittr)
library(microbenchmark)

## По-голям пример ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# векторизация

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# втори

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# трети

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Първи опит с итерация по редовете:
Unit: milliseconds
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Вторият цикъл, в който векторизацията става чрез преобразуване на списък в матрица и вземане на елементи от среза с индекс 1 (последното е собствено векторизация). Ще се поправя: векторизация на ниво функция strsplit, който може да приема вектор за вход. Оказва се, че процедурата за преобразуване на списък в матрица е много по-тежка от самата векторизация, но и в този случай е много по-бърза от невекторизирания вариант.
Unit: milliseconds
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Ускорението по медиана е 3 пъти.
Третият цикъл, в който схемата за преобразуване в матрица е променена.
Unit: milliseconds
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Ускорението по медиана е 13 пъти.
С това трябва да се експериментира, колкото повече — толкова по-добре.
Още един пример с векторизация, където също има текст, но е приближен до реални условия: различна дължина на думите, различен брой думи. Необходимо е да се извлекат първите 3 думи. Ето как:
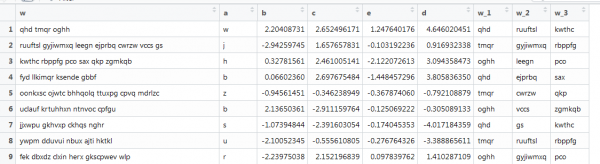
Тук предишната функция вече не работи, тъй като векторите са с различна дължина, а ние задавахме размер на матрицата. Нека преработим това, като се поровим в интернет.
Код
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unit: milliseconds
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Скриптът работи със средна скорост от 1 секунда. Не е зле.
Свързани с една верига...
С обектите DT може да се работи, използвайки свързване. Изглежда като прикрепяне на синтаксиса на скобите отдясно, по същество, захар.
Код
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Тече през тръбите...
Същите операции могат да се направят и чрез piping, изглежда подобно, но е функционално по-богато, тъй като може да се използват всякакви методи, а не само DT. Ще изведем коефициентите на логистичната регресия за нашите синтетични данни с редица филтри на DT.
Код
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Статистика, машинно обучение и други вътре в DT
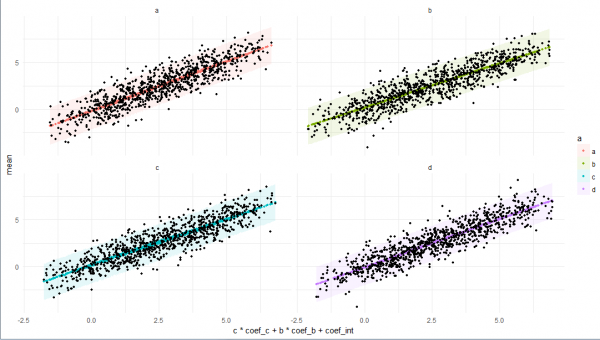
Може да се използват lambda функции, но понякога е по-добре да ги създадете отделно, да напишете целия пайплайн за анализ на данни и напред — те работят вътре в DT. Примерът е обогатен с всички по-горе изброени функции, плюс няколко полезни неща от арсенала на DT (такива като достъп до самия DT вътре в DT по линк, понякога вложени не последователно, но за да има).
Код
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Заключение
Надявам се, че успях да създам цялостна, но, разбира се, не пълна, картина на обекта data.table, започвайки от неговите свойства, свързани с наследяването от класовете на R, и стигайки до собствените му особености и средата от елементи на tidyverse. Надявам се, че това ще ви помогне да изучавате и прилагате по-добре тази библиотека за работа и развлечение.
Благодаря!
Пълен код
Код
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Източник: habr.com
