

Здравейте, и първо малко лирика. Понякога завиждам на колегите, които работят отдалечено — наистина е прекрасно да имаш възможност да работиш от всяка точка на света, свързана с Интернет, да имаш ваканции когато пожелаеш, отговорност за проектите и сроковете, а не да си в офиса от 8 до 17. Моята позиция и работни задължения почти изключват възможността за дълго отсъствие от дата центъра. Въпреки това — понякога се случват интересни ситуации, подобни на описаната по-долу — и разбирам, че има малко позиции, където има такова пространство за творческо изразяване на вътрешния troubleshooter.
Няколко думи за предупреждение — в момента на написването на статията случаят не е напълно решен, но като се имат предвид бързината на отговорите от доставчиците, пълното решение може да отнеме още месеци, а искам вече да споделя находките си. Надявам се, уважаеми читатели, да ми простите за тази прибързаност. Но достатъчно за това — какво се случва със случая?
Първо, кратко въведение: има компания (в която работя като мрежов инженер), която хоства клиентски решения в частно облако VMWare. Повечето нови решения се свързват с VXLAN сегменти, управлявани от NSX-V — няма да оценявам колко време ми спести това решение, накратко казано — много. Успях дори да обуча колеги как да конфигурират NSX ESG и малки клиентски решения се разгръщат без моето участие. Важно уточнение — control plane при нас е с unicast репликация. Хипервизорите са свързани излишно с два интерфейса към различни физически комутатори Juniper QFX5100 (сглобени във Virtual Chassis) и политиката на синхронизация е route based on originating virtual port — това е за пълната картина.
Клиентските решения са много разнообразни: от Windows IIS, където всички компоненти на уеб сървъра са инсталирани на една машина, до доста големи — например load-balanced Apache уеб фронтове + LB MariaDB в Galera + сървъри за споделяне, синхронизирани с помощта на GlusterFS. Практически всеки сървър трябва да се наблюдава отделно, а публичните адреси не са налични за всички компоненти — ако сте се сблъсквали с тази задача и имате по-елегантно решение, бих се радвал на съвета ви.
Моето решение за мониторинг включва "включването" на фаервола (Fortigate) към всяка вътрешна клиентска мрежа (+SNAT и, разбира се, строги ограничения по типа разрешен трафик) и наблюдение на вътрешните адреси — по този начин се постига известна унификация и опростяване на мониторинга. Самият мониторинг се извършва от клъстър от сървъри PRTG. Схемата на мониторинга е приблизително такава:
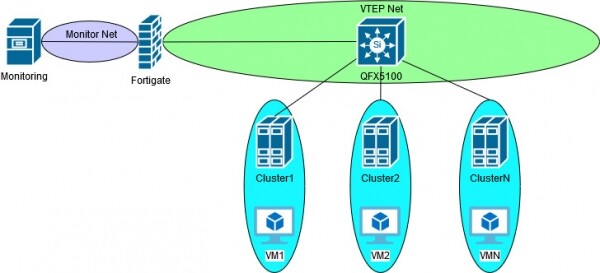
Докато работехме само с VLAN, всичко беше напълно обичайно и предсказуемо, работеше като часовник. След внедряването на NSX-V и VXLAN се сблъскахме с въпроса — може ли да продължим мониторинга по стария начин? В момента на този въпрос най-бързото решение беше да развернем NSX ESG и да свържем VXLAN trunk-интерфейс в VTEP мрежата. Бързо в кавички — тъй като използването на GUI за настройка на клиентските мрежи, SNAT и правила на фаервола може да унифицира управлението в един и същи интерфейс vSphere, но по мое мнение е доста тромаво и освен всичко друго ограничава набора от инструменти за решаване на проблеми. Тези, които са използвали NSX ESG като заместител на "истински" фаервол, сигурно ще се съгласят. Въпреки това, може би такова решение би било по-стабилно — защото всичко се случва в рамките на един и същи вендор.
Друго решение е да се използва NSX DLR в режим на мост между VLAN и VXLAN. Тук смятам, че всичко е ясно — просто се губи предимството от използването на VXLAN — защото в този случай все пак трябва да се прокарва VLAN до инсталацията за наблюдение. Между другото, по време на разработването на това решение се сблъсках с проблема, когато DLR мостът не изпращаше пакети на виртуалната машина, с която беше на един и същи хост. Знам, знам — в книгите и ръководствата за NSX-V е казано, че за NSX Edge трябва да бъде отделен кластер, но това е в книгите... Така или иначе, след няколко месеца работа със съпорта не успяхме да решим проблема. В принципе, логиката на действието ми стана ясна — модулът на ядрото на хипервизора, отговорен за инкапсулацията на VXLAN не беше задействан, ако DLR и наблюдаваният сървър бяха на един и същи хост, тъй като трафикът не напуска хоста и по логика трябва да бъде свързан с VXLAN сегмента — инкапсулация не е нужна. Със съпорта стигнахме до виртуалния интерфейс vdrPort, който логически обединява uplinks и осъществява мостовата/инкапсулацията — там беше забелязано несъответствие в входящия трафик, което взех за анализ в текущия случай. Но както беше казано, до края не довърших този случай, тъй като бях пренасочен към друг проект и освен това клонът първоначално беше безизходен и нямаше желание да го развивам особено. Ако не се лъжа, проблемът се наблюдаваше в версиите NSX 6.1.4 и 6.2.
И тук — бинго! Fortinet анонсира нативна . И не само point-to-point или VXLAN-over-IPSec, не софтуерен мост между VLAN-VXLAN — всичко това започна да се внедрява още от версия 5.4 (и е представено при други ), а настоящата поддръжка на unicast control plane. При внедряването на решението се сблъсках с още един проблем — проверените сървъри периодично «изчезваха» и се появяваха в мониторинга, въпреки че самата виртуална машина беше жива. Причината, както се оказа, беше, че забравих да разреша Ping на VXLAN интерфейса. В процеса на ребалансировка на кластерите, виртуалките се преместваха, а Ping’ът завършваше vMotion, за да обозначи новия ESXI хост, на който се е преместила машината. Глупост моя, но този проблем отново подкашва доверието към поддръжката на производителя — в този случай Fortinet. Да не споменавам, че всеки случай, свързан с VXLAN започва с въпрос «а къде имате в настройките софтуерния комутатор VLAN-VXLAN?» Този път ми посочиха да променя MTU — това за Ping-а, който е 32 байта. После «поекспериментирай» с tcp-send-mss и tcp-receive-mss в политиката — за VXLAN, който се инкапсулира в UDP. Уф, извинете — накипело ми е. В общи линии реших този проблем сам.
След успешно тестване на трафика решихме да внедрим това решение. И в продукция се оказа, че след ден-два постепенно всичко, което се мониторира през VXLAN, започва да отпадат. Деактивацията/активацията на интерфейса помагаше, но само за кратко. Помнейки за бавното действие на поддръжката на производителя, започнах самостоятелно да се занимавам с отстраняване на проблемите — все пак моята компания, моята мрежа — моя отговорност.
Под спойлера е ходът на трубалшутинга. Който е уморен от букви и бахвалство — пропускайте и преминавайте към постанализата.
Ход на трубалшутингаБлагодаря, че продължихте да четете — продължаваме!
Така, мониторингът работи известно време, след което се самоизключва. Значи в политиките на фаервола вероятно нямаме проблеми. Въпреки това, тъй като съм се сблъсквал с проблеми с зависващи системни процеси във Fortigate версии 5.6+, първо поглеждаме «diagnose debug flow» — както се очаква, трафикът се разрешава и напуска интерфейса, а очаквано нищо не идва в отговор. Значи копаем по-нататък в стека. За съжаление, ще се наложи да скрия адресите, дори и RFC1918, но се надявам да опиша процеса достатъчно за разбиране. Сървърът вътре в VXLAN има адрес х.х.х.15, интерфейсът на Fortigate х.х.х.254, а всичките останали адреси принадлежат на мрежата VTEP.
За успешното предаване на VXLAN капсулирани пакети е необходимо наличието на коректна информация в няколко таблици. За overlay това са ARP и OVSDB, а за underlay ARP и CAM. В случая на Fortigate VXLAN FDB е именно OVSDB. Там и ще започнем:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Тук всичко е доста просто — MAC адресът на виртуалната машина трябва да се намира на VTEP с адрес у.у.у.47. Следвайки съдържанието и настройките на ESXI клъстера, откривам, че MAC на виртуалната машина е верен, а адресът на VTEP също. Проверявам CAM/ARP таблицата на Fortigate — отново всичко съвпада с настройките на ESXI хоста:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
Таблиците са верни и трафикът излиза — може би проблемът не е на Fortigate? Умишлено пропуснах анализа на комутацията на трафика на Juniper — логично следва да се реализира следващата стъпка в отстраняването на проблеми там, но мрежата ми е проста — само един VLAN за VTEP и всички компоненти са свързани директно. Освен това си спомням случая с DLR-бриджа, VDR и изчезващия трафик — отивам да снифя на ESXI хост, междувременно създавам случай вече и за VMWare. По-долу MAC «97:6e» принадлежи на Fortigate, vmnic1 — това е интерфейсът, който има VTEP с адрес у.у.у.47, снифя в двете посоки "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
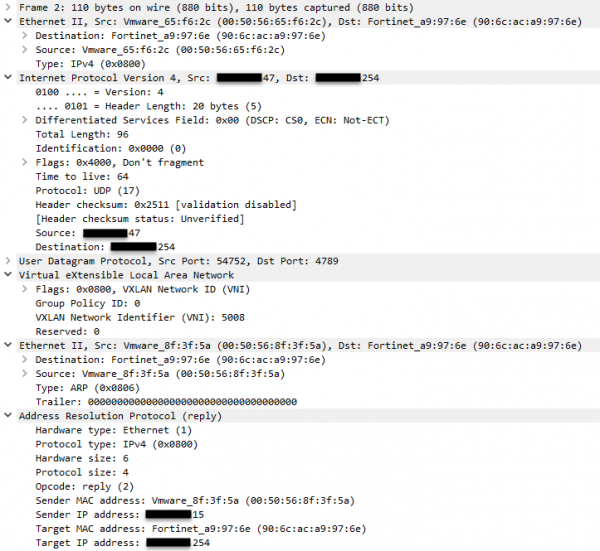
Напредък — в снифа виждам ARP запитване и постъпващ отговор. Давам само ARP отговора и там всичко е верно. Не споменах, но през цялото това време мониторинг сървърът пингва адрес х.х.х.15 — къде е ICMP трафикът? Спомням си, че имам два аплинка. Тук може да се спори и да се каже, че виртуалният порт на източника е един и същ (моята политика за обединяване), тоест за същата vNIC трябва да се избира един и същ аплинк, но тъй като съм на хоста, проверки на другия аплинк не е проблем:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
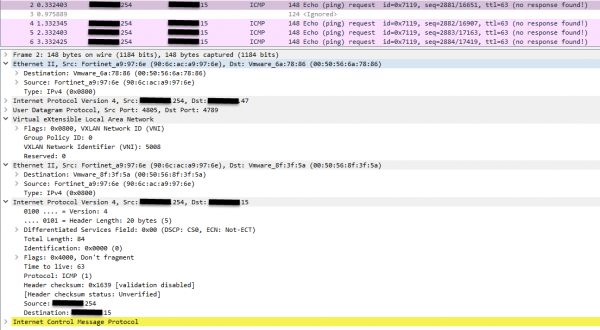
Получавам заявки от Fortigate, но отговори няма. Тоест, проблемата не е във Fortigate. Хм, мисля си — отново същият проблем с изчезващия трафик на VDR, отново ще трябва да управлявам дело в правилната посока в продължение на месеци. След няколко дни, охладен и не желаещ да се примиря с неразрешеното, реших да събера още снифове за поддръжката, за да ускоря процеса. И тук „случайно” погледът ми пада на Ethernet инкапсулацията underlay. Царят не е истински и MAC адресът на VTEP не съвпада с неговия IP. Нулирам, снифя, ровя — вярно е, че не е вярно. Ще добавя ARP таблицата до вас, за да е по-удобно за сравнение. Обърнете внимание на първата Ethernet инкапсулация на картинката отгоре:
fortigate (root) #get sys arp | grep х.х.х.47
х.х.х.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep х.х.х.42
х.х.х.42 0 00:50:56:6a:78:86 dmz
И така, какво имаме в крайна сметка — след миграцията на виртуалната машина, Fortigate се опитва да изпрати трафик на VTEP от (коректната) VXLAN FDB, но използва неправилен DST MAC и трафикът естествено се отблъсква от интерфейса на хипервизора, който го получава. В едно от четирите случая този MAC принадлежеше на оригиналния хипервизор, от който започнахме миграцията на машината.
Вчера получих имейл от техническата поддръжка на Fortinet — по моя случай е открит бъг 615586. Направо не знам дали да се радвам или да тъгувам: от една страна — проблемът не е в настройките, от друга — фикса ще дойде само с обновлението на фърмуера, в най-добрия случай следващото. Чувството за собствено значение също се подстрекава от друг бъг, който открих миналия месец, въпреки че този път в HTML5 GUI vSphere. Направо локален QA отдел на вендорите...
Рискувам да предположа следното:
1 — контролният план за multicast вероятно няма да бъде подложен на описания проблем — все пак MAC адресите на VTEP се получават от IP адреса на групата, на която интерфейсът е абониран.
2 — вероятно проблемът с Fortigate е в офлоуда на сесиите на Network Processor (приблизително аналог на CEF) — ако пропускаме всеки пакет през CPU, ще се използват таблици, съдържащи вярна — поне визуално — информация. В подкрепа на това предположение отива факта, че помага да затворим/отворим интерфейса или да изчакаме известно време — повече от 5 минути.
3 — промяната на политиката за teaming, например на explicit failover, или внедряването на LAG няма да реши проблема, тъй като наблюдаваше „застрягане“ на MAC на оригиналния хипервизор в инкапсулираните пакети.
В светлината на това мога да споделя, че наскоро открих за себе си , където в една от статиите се твърдеше, че stateful фаерволите и кешираните методи за предаване на данни са просто заобиколни решения. Е, не съм достатъчно опитен в IT, за да твърдя нещо такова, а и не съм напълно съгласен с всички твърдения в блоговете. Все пак нещо ми подсказва, че в думите на Иван има част от истината.
Благодаря за вниманието! Ще се радвам да отговоря на въпросите и да чуя конструктивна критика.
Източник: habr.com
