

Здравейте на всички. По-долу е представено резюме .
– система за мониторинг на различни системи и услуги, която позволява на системните администратори да събират информация за текущите параметри на системите и да настроят известия за получаване на уведомления за отклонения в работата на системите.
В доклада ще бъде направено сравнение и – на проекти за дългосрочно съхранение на метрики Prometheus.
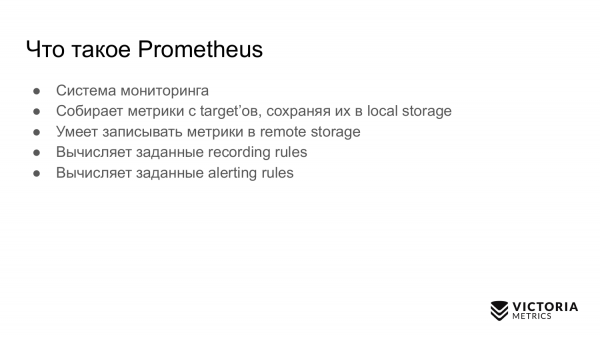
Първо ще разкажа за Prometheus. Това е система за мониторинг, която събира метрики от зададени target’и и ги съхранява в локално хранилище. Prometheus може да записва метрики в дистанционно хранилище, да генерира alert’и и recording rules.
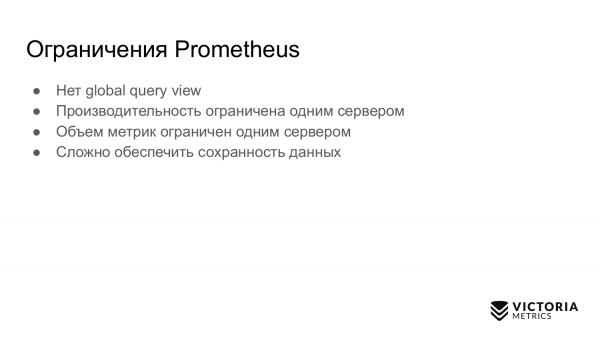
Ограничения на Prometheus:
- Няма global query view. Това е, когато имате няколко независими инстанции на Prometheus. Те събират метрики и вие искате да направите заявка върху всички тези метрики, събрани от различни инстанции на Prometheus. Prometheus не позволява това.
- Производителността на Prometheus е ограничена само от един сървър. Prometheus автоматично не може да се мащабира на няколко сървъра. Можете само ръчно да разделите вашите target’и между различни Prometheus инстанции.
- Обемът на метриките в Prometheus е ограничен само от един сървър по същата причина, поради която не може автоматично да се мащабира на няколко сървъра.
- В Prometheus не е лесно да се организира съхранението на данни.
Какви решения на тези проблеми/задачи?
Решенията са такива:
Всички тези решения са за дистанционно съхранение на данни, събрани от Prometheus. Те решават проблема с remote storage от предишния слайд по различен начин. В тази презентация ще говоря само за първите две решения: и .
За първи път информацията за появи по . Там е описана архитектурата и как работи.
Thanos взема данните, които Prometheus е запазил на локалния диск, и ги копира в S3, в или в друго object storage.
По този начин Thanos осигурява global query view. Можете да запитвате данни, запазени в object storage от няколко инстанции на Prometheus.
Thanos поддържа PromQL и .
Thanos използва кода на Prometheus за съхранение на данни.
Thanos е разработен от същите разработчици, които разработват и Prometheus.
За . Ето , където за първи път разказахме за .
VictoriaMetrics получава данни от няколко Prometheus чрез протокол, поддържан от Prometheus.
VictoriaMetrics предоставя глобален изглед за запитвания, тъй като множество инстанции на Prometheus могат да записват данни в една VictoriaMetrics. Съответно, можете да правите запитвания по тези данни.

VictoriaMetrics също така поддържа, както Thanos — PromQL и Prometheus API за запитвания.
В отличие от Thanos, изходният код на VictoriaMetrics е написан от нуле и е оптимизиран за бързина и използвани ресурси.
VictoriaMetrics, за разлика от Thanos, мащабира и вертикално, и хоризонтално. Има , която се мащабира вертикално. Можете да започнете с един процесор и 1 ГБ памет и постепенно да нараствате до стотици процесори и 1TB памет. VictoriaMetrics може да използва всичките тези ресурси. Нейната производителност ще нарасне около 100 пъти в сравнение с 1-ядрена система.
Историята на Thanos започна през ноември 2017 г., когато се появи първият публичен комит. Преди това Thanos се развиваше вътре в компанията .
През юни 2019 г. имаше важен релийз 0.5.0, в който протокол. Той беше премахнат от Thanos, защото не се представи на добро ниво. Често кластерът Thanos не работеше правилно, нодите се свързваха неправилно поради gossip протокола. Затова решиха да го премахнат. Считам, че това е правилно решение.
През същия юни 2019 г. те подадоха заявка номер в .
И след няколко месеца Thanos беше приет в , която включва Prometheus, Kubernetes и други популярни проекти.
През януари 2018 г. започна разработката на VictoriaMetrics.
През септември 2018 г. за първи път публично споменах VictoriaMetrics.
През декември 2018 г. публикуваха единична версия.
През май 2019 изходниците както на единичната, така и на кластерната версия.
През юни 2019 г., подобно на Thanos, подадохме заявка в CNCF foundation под номер . Подадохме заявката един ден по-рано от Thanos.
Но, за съжаление, все още не сме приети там. Нужна е помощ от общността.
Нека разгледаме най-важните слайдове, показващи архитектурата на Thanos и VictoriaMetrics.
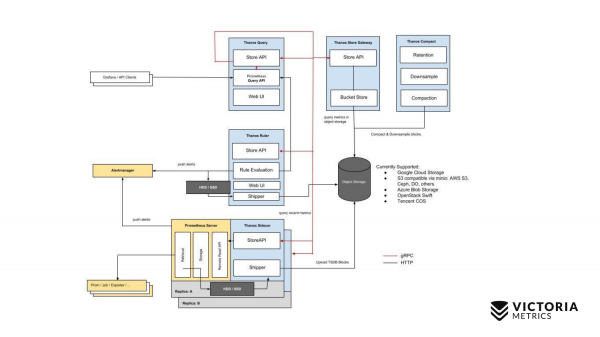
Да започнем с Thanos. Жълтите компоненти — това са компонентите на Prometheus. Всичко останало — това са компонентите на Thanos. Да започнем с най-важния компонент. Thanos Sidecar — това е компонент, който се инсталира до всеки Prometheus. Той отговаря за зареждането на данните на Prometheus от локалното хранилище в S3 или в друг Object Storage.
Има също един компонент, наречен Thanos Store Gateway, който може да прочита тези данни от Object Storage при входящи заявки от Thanos Query. Thanos Query реализира PromQL и Prometheus API. Тоест, отвън той изглежда като Prometheus. Приема PromQL заявки, изпраща ги до Thanos Store Gateway, а Thanos Store Gateway извлича нужните данни от Object Storage и ги изпраща обратно.
Но в нашия Object Storage се съхраняват данни без последните два часа поради особеностите на работата на Thanos Sidecar, който не може да качи последните два часа в Object Storage S3, тъй като за тези два часа Prometheus все още не е създал файлове в локалното хранилище.
Как решихме да заобиколим това? Thanos Query, освен заявките към Thanos Store Gateway, паралелно изпраща заявки и до всеки Thanos Sidecar, който се намира в близост до Prometheus.
А Thanos Sidecar, от своя страна, проксира заявките в Prometheus и извлича данните за последните два часа.
Освен тези компоненти, има още един опционален компонент, без който Thanos ще се чувства зле. Това е Thanos Compact, който се занимава с обединението на малките файлове в Object Storage в по-големи файлове, които са качени там от Thanos Sidecar-ите. Thanos Sidecar качва файлове с данни за последните два часа. Ако тези файлове не се слеят в по-големи единици, тяхното количество може да нарасне значително. Колкото повече такива файлове, толкова повече памет е нужна за Thanos Store Gateway, толкова повече ресурси са нужни за предаване на данни по мрежата, метаданни. Работата на Thanos Store Gateway става неефективна. Затова е наложително да се стартира Thanos Compact, който обединява малките файлове в по-големи, за да има по-малко файлове и да се намали натоварването на Thanos Store Gateway.
Има също един компонент, наречен Thanos Ruler. Той изпълнява правилата за предупреждение на Prometheus и може да изчислява правилата за запис на Prometheus, за да записва данни отново в Object Storage. Но не се препоръчва да се използва този компонент, тъй като той .
Ето каква е простата схема на Thanos.
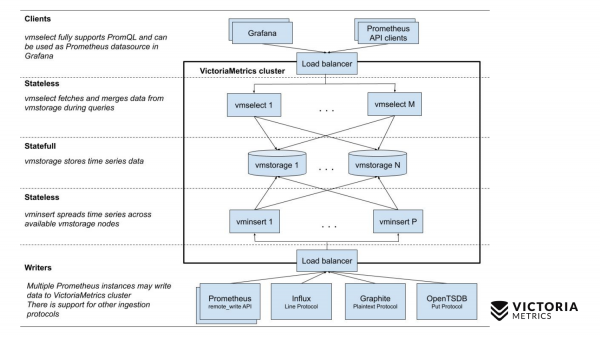
Сега нека сравним с схемата на VictoriaMetrics.
VictoriaMetrics има 2 версии: Еднодискова и клъстерна версия. Еднодисковата версия работи на един компютър. В Еднодисковата версия няма тези компоненти, просто един бинарен файл. Този бинарен файл в слайда изглежда с този квадрат. Всичко, което се намира вътре в квадрата, е съдържанието на бинарния файл за Еднодисковата версия. Не е нужно да знаете за него. Просто стартирайте бинарния файл — и всичко работи.
Кластерната версия е по-сложна. Вътре в нея се намират три различни компонента: vmselect, vminsert и vmstorage. От имената им трябва да е ясно с какво се занимава всеки от тях. Компонентът Insert приема данни в различни формати: от Prometheus remote write API, Influx line протокол, Graphite протокол и от OpenTSDB протокол. Компонентът Insert ги приема, парсва и разпределя между наличните storage компоненти, където данните вече се съхраняват. , както и Prometheus querying API, и може да бъде използван като заместител на Prometheus в Grafana или други клиенти на Prometheus API. Select приема promql запитване, парсва го, чете необходимите данни за изпълнение на това запитване от storage възли, обработва тези данни и връща отговор.
Ще сравним сложността на инсталацията на Thanos и VictoriaMetrics.
Започваме с Thanos. Преди да започнете работа с Thanos, трябва да създадете bucket в Object Storage, като S3 или GCS, за да може Thanos Sidecar да записва данни там.
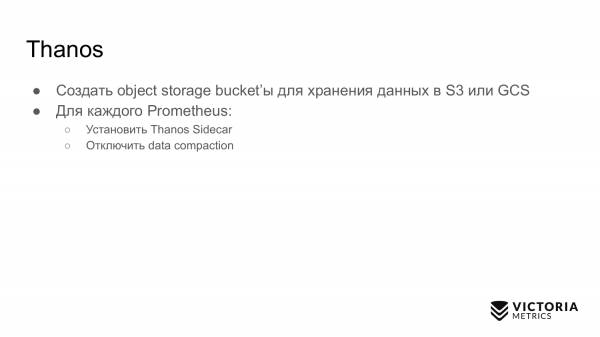
След това за всеки Prometheus трябва да инсталирате Thanos Sidecar. Преди това не забравяйте да изключите data compaction в Prometheus. Data compaction периодично компресира данните в локалното хранилище на Prometheus, за да намали потреблението на ресурси.
Когато инсталирате Thanos Sidecar на вашите Prometheus инстанции, трябва да деактивирате data compaction, тъй като Thanos Sidecar не работи правилно с активиран data compaction. Това означава, че вашият Prometheus започва да съхранява данни на блокове от по два часа и спира да обединява тези блокове в по-големи. Следователно, ако правите запитвания, които надвишават продължителността от последните два часа, те няма да работят толкова ефективно в сравнение с начина, по който биха могли да работят, ако беше включен data compaction.
Затова Thanos препоръчва да се намали времето за съхранение на данните (data retention) в локалното хранилище до 6-8 часа, за да се намали този overhead от много малки блокове.
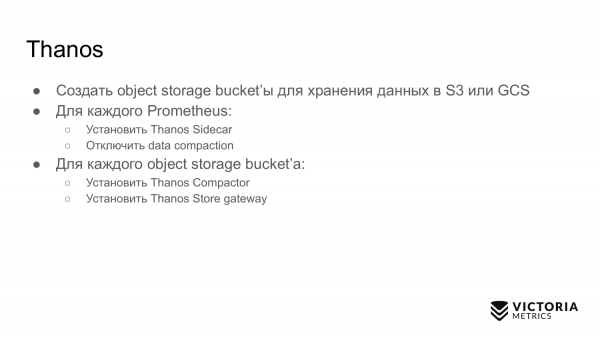
След като инсталирате Thanos Sidecar, трябва да инсталирате два компонента за всеки Object Storage Bucket. Това са Thanos Compactor и Thanos Store Gateway.
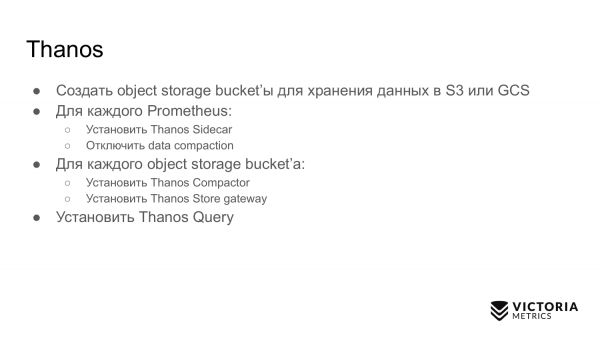
След това трябва да инсталирате Thanos Query и да го конфигурирате, за да може да се свързва с всички Thanos Store Gateway, които имате, и също така да може да се свързва с всички Thanos Sidecar.
Може да се появи малък проблем.
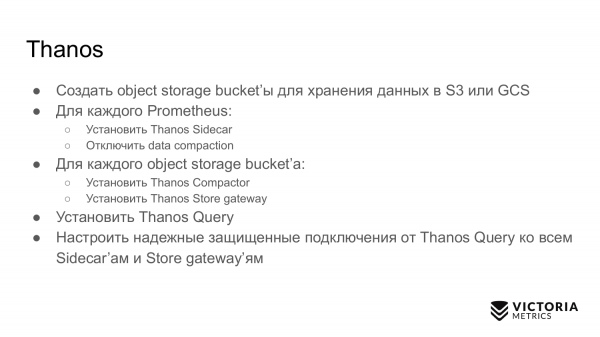
Трябва да настроите надежна и защитена връзка от Thanos Query към тези компоненти. И ако вашите Prometheus са в различни дата центрове или в различни VPC, то свързването отвън е забранено. Но за работата на Thanos Query трябва да настроите връзката и трябва да измислите начин.
Ако имате много такива дата центрове, тогава надеждността на цялата система намалява. Тъй като Thanos Query трябва постоянно да поддържа връзки с всички Thanos Sidecar, разположени в различни дата центрове. При всяка входяща заявка той ще насочва исканията към всички Thanos Sidecar. Ако връзката прекъсне, ще получите или непълен набор от данни, или отговор "клъстерът не работи".
В VictoriaMetrics всичко е малко по-просто. За версията с един възел просто трябва да стартирате един бинарен файл и всичко работи.
При кластерната версия е достатъчно да стартирате всичките три изброени типа компоненти в необходимо от вас количество, или да използвате за автоматизация на стартирането на компонентите в Kubernetes. Още планираме да направим оператор за Kubernetes. Helm chart не покрива някои случаи и позволява да си простреляте крака. Например, позволява да намалите броя на storage node, което ще доведе до загуба на данни.
След като стартирате един бинарен файл или кластерната версия, трябва просто да добавите в конфигурацията на Prometheus , за да започне да записва данни паралелно в локалното хранилище и отдалеченото хранилище. Както забелязахте, такава конфигурация трябва да работи значително по-надеждно в сравнение с конфигурацията Thanos. Не е нужно да поддържаме връзка от VictoriaMetrics към всички Prometheus, защото Prometheus сами се свързват към VictoriaMetrics и предават данни.
Нека разгледаме поддръжката на Thanos и VictoriaMetrics.
Thanos трябва да наблюдава Sidecar, за да не спира зареждането на данни в Object Storage. Те могат да спрат това зареждане поради грешки при зареждане, например, ако имате временно прекъсване на мрежовото свързване с Object Storage или ако Object Storage е временно недостъпен. В този момент Thanos Sidecar ще забележи това, ще докладва за грешка, може да се срине и след това да спре да работи. Ако не го наблюдавате, данните ви ще спрат да се предават в Object Storage. Ако изтече времето на задържане (препоръчително 6-8 часа), ще загубите данни, които не са попаднали в Object Storage.
Thanos компактори могат да спрат да работят поради . Компактори взимат данни от Object Storage и ги сливат в по-големи блокове. Тъй като компакторите не са синхронизирани с Sidecar, може да се случи следното: Sidecar все още не е успял да запише блока, а Компакторът решава, че този блок е напълно записан. Компакторът започва да го чете. Той чете блока не в пълен вид и спира да работи. Вижте подробности .
Store Gateway може да предоставя неконсистентни данни заради състезания между Компактора и Sidecar. Тук е същото, тъй като Store Gateway не е синхронизиран с Компактори и Sidecar. Следователно, могат да възникнат състояния на състезание, при които Store Gateway не вижда част от данните или вижда излишни данни.
Компонентът Query в Thanos по подразбиране предоставя частичен резултат, ако някои Sidecar или Store Gateway не са на разположение в момента. Ще получите част от данните и дори няма да знаете, че не сте получили всичките данни. Това е стандартната му работа. В подобна ситуация VictoriaMetrics връща маркерованите данни като частични.
В отличие от Thanos, VictoriaMetrics рядко губи данни. Дори ако връзката между Prometheus и VictoriaMetrics е прекъсната, това не е проблем, тъй като Prometheus продължава да записва новите данни в Write Ahead Log, чийто размер е 2 часа. Ако в рамките на два часа възстановите връзката с VictoriaMetrics, данните няма да бъдат загубени. Prometheus .
За разлика от Thanos, който записва данни в object storage само след два часа, Prometheus автоматично репликира данни по remote write протокола в remote storage, такъв като VictoriaMetrics. Не трябва да се притеснявате за загубата на local storage в Prometheus. Ако случайно загубите local storage, в най-лошия случай ще загубите последните секунди данни, които не са успели да се запишат в remote storage.
Kubernetes автоматично управлява кластера в разлика от Thanos. Всички компоненти на Thanos е трудно да бъдат поставени в един Kubernetes кластер, за разлика от кластерните компоненти на VictoriaMetrics.
VictoriaMetrics има много лесно обновление към нова версия. Просто спирате VictoriaMetrics, обновявате бинарниците и го стартирате отново. При спиране чрез сигнал SIGINT всички бинарници на VictoriaMetrics извършват graceful shutdown. Те правилно запазват необходимите данни, правилно затварят входящите връзки, за да не загубят нищо. Затова при обновление няма да загубите нищо.
VictoriaMetrics много лесно разширява клъстера. Просто добавяте необходимите компоненти и продължавате да работите.
По подводните камъни в Thanos и VictoriaMetrics.
Thanos има следните подводни камъни. Prometheus трябва да съхранява данни за последните два часа. Ако те се загубят, ще ги загубите напълно, тъй като те все още не са успели да се запишат в Object Storage, такъв като S3.
Компонентът Store Gateway и компонентът компактор може да изискват много памет за работа с голям Object Storage, ако там се съхраняват много малки файлове. Колкото повече са броят и обемът на файловете, толкова повече RAM изискват Store Gateway и компактора за съхранение на метаинформацията. Thanos има много проблеми с това, че .
Thanos се рекламира, че може да се мащабира безкрайно спрямо броя на вашите Prometheus. Всъщност това не е вярно. Тъй като всички заявки минават през компонента Query, който трябва паралелно да опознае всички Store Gateway компоненти и всички Sidecar компоненти, за да изтегли оттам данни и след това да ги предпроцесира. Очевидно е, че скоростта на заявките е ограничена от най-бавния слаб звено, най-бавния Store Gateway или най-бавния Sidecar.
Тези компоненти може да бъдат неравномерно натоварени. Например, имате Prometheus, който събира милиони метрики в секунда. И има Prometheus, в който се събират хиляди метрики в секунда. Prometheus, в който се събират милиони метрики в секунда, натоварва значително повече сървъра, на който работи. Следователно Sidecar там работи по-бавно. И всичко там работи по-бавно. И компонентът Query ще извлича данни оттам много бавно. Следователно производителността на целия ви кластер ще бъде ограничена от този бавен Sidecar.
По подразбиране Thanos подава частични данни, ако някои Sidecar-и или Store Gateway не са налични. Например, ако имате Sidecar-и разпръснати по целия свят в различни дата центрове, вероятността за прекъсване на връзката и недостъпност на компонентите значително нараства. Следователно, в повечето случаи ще получавате частични данни, дори без да знаете за това.
VictoriaMetrics също има свои подводни камъни. Първият подводен камък е опцията, която ограничава обема на оперативната памет, използвана за кеша на VictoriaMetrics. По подразбиране тя е 60% от оперативната памет на машината, на която е стартирана VictoriaMetrics, или 60% от RAM на пода на VictoriaMetrics в Kubernetes.
Ако тази стойност бъде променена неправилно, можно да се влоши производителността на VictoriaMetrics. Например, ако зададете твърде ниска стойност, данните може да спрат да се побират в кеша на VictoriaMetrics. Поради това ще й се наложи да извършва излишна работа и да натоварва процесора с диска. Ако направите тази опция твърде голяма, това повишава, от една страна, вероятността VictoriaMetrics да се срути с грешка out of memory, а от друга страна, това ще доведе до много малко оперативна памет за файловия кеш в операционната система. А VictoriaMetrics разчита на файловия кеш за производителност. Ако той е недостатъчен, натоварването на диска може да се увеличи значително. Затова съвет: не променяйте параметъра без крайна необходимост.
Втората опция е retentionPeriod — периодът, който по подразбиране е зададен на 1 месец. Това е времето, в което VictoriaMetrics съхранява данните. След изтичането на този срок, VictoriaMetrics изтрива данните.
Много хора стартират VictoriaMetrics без този параметър, записват данни в продължение на месец. А после питат: защо данните изчезнаха от предходния месец? Защото retentionPeriod по подразбиране е 1 месец. Следователно е нужно да знаете и да зададете правилния retentionPeriod.
Нека разгледаме уникалните възможности.
Thanos има функция, известна като downsampling: 5-минутни и часови интервали, които често . Ако потърсите в Google и погледнете техните проблеми в GitHub, там има много проблеми, свързани с този downsampling, и той понякога не работи правилно или не работи така, както очакват потребителите.
Thanos предлага дедупликация на данните за Prometheus HA двойки. Когато два Prometheus-а събират същите метрики от едни и същи целеви системи и Thanos ги складира в Object Storage. Thanos може правилно да дедуплицира тези данни, за разлика от VictoriaMetrics.
Thanos разполага с alert компонент, който беше показан в схемата на Thanos. Но .
Thanos има предимство, че кодът на Thanos и Prometheus е общ. Thanos и Prometheus са разработени от едни и същи разработчици. При подобрения в Thanos, Prometheus също печели.
Основната функция на VictoriaMetrics е MetricsQL. Това е разширение на VictoriaMetrics за PromQL, за което говорих на предходния голям мониторинг среща.
VictoriaMetrics поддържа запис на данни чрез множество различни протоколи. VictoriaMetrics не само може да приема данни от Prometheus, но и през протоколите Influx, OpenTSDB и Graphite.
Данните на VictoriaMetrics заемат значително по-малко пространство в сравнение с Thanos и Prometheus.
Ако записвате реални данни, потребителите съобщават за 2-5 кратно намаляване на размера на данните на диска в сравнение с Prometheus и Thanos.
Още едно предимство на VictoriaMetrics е, че тя е оптимизирана за скорост.
Нека видим разходите за инфраструктурата.
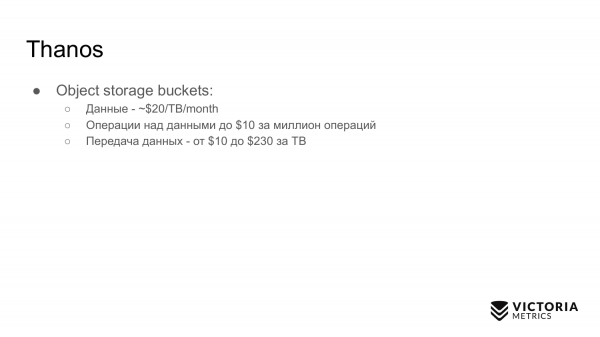
Едно от предимствата на Thanos е, че той съхранява данните в object storage, който е сравнително евтин.
Когато съхранявате данни в object storage, вие трябва да плащате за операции по запис и четене на данни (10 долара за един милион операции). Когато записвате данни в object storage, плащате за разходите на вашето хостинг за качване на данни в интернет, ако вашият клъстер не е в AWS — там е безплатно. Когато четете данни, плащате от 10 до 230 долара за 1TB. Това може да бъде значимо, ако често искате исторически данни от клъстера на Thanos.
За Thanos клъстера е необходимо да се заплащат сървъри за компонентите Compact, Store Gateway и Query, които изискват много памет и ЦПУ за големи обеми данни.
Разходите за VictoriaMetrics са такива. Ако се съхраняват данни на GCE HDD дискове, то излиза $40 за 1ТБ. За VictoriaMetrics са достатъчни обикновени HDD дискове, не са необходими SSD, които струват пет пъти повече. VictoriaMetrics е оптимизирана за HDD.
За VictoriaMetrics са нужни сървъри за компонентите: или Single-node, или за клъстерни компоненти, които, за разлика от Thanos компонентите, изискват значително по-малко ЦПУ и ОЗУ — съответно ще бъде по-евтино.
Примери за внедряване.
Пример за внедряване на Thanos е Gitlab. Gitlab работи напълно на Thanos. Но не всичко е толкова гладко. Ако погледнем техния , можем да видим, че постоянно се появяват някакви : не достига памет за компонентите Store Gateway или Query. Те постоянно трябва да увеличават обема на паметта.
Това увеличава разходите за решаване на тези проблеми.
Второто внедряване, което може да бъде по-успешно, е компанията Improbable, която започна разработка на Thanos. Те публикуваха изходния код на Thanos. Improbable е компания, която се занимава с разработка на игрални платформи.
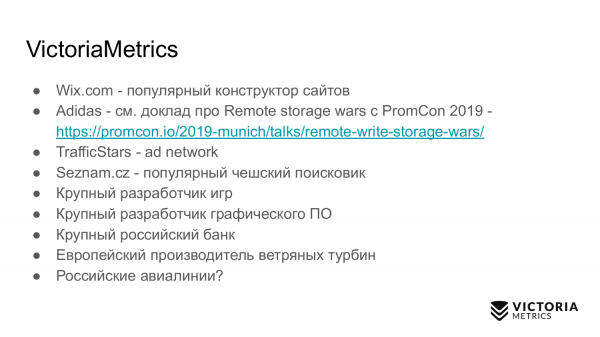
Публични примери за внедряване на VictoriaMetrics са:
- wix.com конструктор за уебсайтове
- Adidas внедрява VictoriaMetrics и дори направи доклад на последния PromCon 2019
- TrafficStars — рекламна мрежа
- Seznam.cz — популярен чешки търсач.
А следват ноунейм компании, които не мога да назова в момента. Те не дадоха съгласие.
- Един голям разработчик на игри. По-голям, отколкото Improbable.
- Голям разработчик на софтуер за графика.
- Голям руски банк.
- Европейски производител на вятърни турбини, който успешно тества VictoriaMetrics. Този производител внедрява VictoriaMetrics за мониторинг на данни, получени от вятърни турбини с честота от 50 сэмпла в секунда на всеки сензор. Във всяка вятърна турбина има по няколко стотин сензора. Те имат няколко стотин вятърни турбини.
- Руски авиолинии, които искат да внедрят VictoriaMetrics, но все още не могат. Ние сме на етап договаряне с тях.
 Изводи.
VictoriaMetrics и Thanos решават подобни задачи, но по различни начини:
- Глобален преглед на заявките
- хоризонтално мащабиране
- произволен retention
Благодаря.
Очакваме ви в нашия .
Само регистрирани потребители могат да участват в анкетата. , моля.
Какво използвате за long term storage за Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%друго4
Гласували 17 потребители. Въздържали се 16 потребители.
Източник: habr.com
