

VictoriaMetrics, TimescaleDB и InfluxDB бяха сравнени в за набор от данни с милиард точки данни, принадлежащи на 40K уникални времеви редове.
Няколко години назад имаше епохата на Zabbix. Всеки bare metal сървър имаше не повече от няколко показатели – употреба на процесор, употреба на оперативна памет, употреба на диска и употреба на мрежата. По този начин метриките от хиляди сървъри могат да се вместят в 40 хиляди уникални времеви редове, а Zabbix може да използва MySQL като бекенд за данните от времевите редове 🙂
В момента един с конфигурации по подразбиране предоставя над 500 метрики на среден хост. Съществуват множество за различни бази данни, уеб сървъри, хардуерни системи и т.н. Всички те предоставят множество полезни показатели. Всички започват да извеждат различни показатели за себе си. Съществува Kubernetes с клъстери и pod-ове, разкриващи множество метрики. Това води до факта, че сървърите извеждат хиляди уникални метрики на хост. По този начин уникален времеви ред от 40K вече не е висока мощност. Той става основен поток, който трябва да бъде лесно обработен от всяка модерна TSDB на един сървър.
Какво представлява голямо количество уникални времеви редове в момента? Вероятно 400K или 4M? Или 40M? Нека сравним съвременните TSDBs с тези цифри.
Настройка на бенчмарка
е отличен инструмент за бенчмаркинг за TSDBs. Той позволява генерирането на произволен брой метрики, предавайки необходимото количество времеви редове, разделени на 10 — флаг (бивш -scale-var). 10 е броят на измерванията (метрики), генерирани на всеки хост, сървър. Следващите набори от данни бяха създадени с помощта на TSBS за бенчмарка:
- 400K уникален времеви ред, 60 секунди интервал между точките данни, данните обхващат пълни 3 дни, ~1.7B общ брой точки данни.
- 4M уникален времеви ред, интервал от 600 секунди, данните обхващат пълни 3 дни, ~1.7B общ брой точки данни.
- 40M уникален времеви ред, интервал от 1 час, данните обхващат пълни 3 дни, ~2.8B общ брой точки данни.
Клиентът и сървърът бяха стартирани на отделни инстанции в облака Google. Тези инстанции имаха следните конфигурации:
- vCPUs: 16
- RAM: 60GB
- Съхранение: стандартен твърд диск с капацитет 1 ТБ. Той предлага честота на четене/запис от 120 Мбит/с, 750 операции четене в секунда и 1,5К операции запис в секунда.
TSDBs бяха извлечени от официалните образи на docker и стартирани в docker с следните конфигурации:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsСтойностите на InfluxDB (-e са необходими за поддръжка на висока мощност. Подробности вижте в ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (конфигурацията беше приета от файл):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Loaderът на данни беше стартиран с 16 паралелни потока.
Тази статия съдържа само резултати от контролни показатели за вмъкване. Резултатите от изборен бенчмарк ще бъдат публикувани в отделна статия.
400К уникални времеви реда
Нека започнем с лесни елементи — 400К. Резултати от бенчмарка:
- VictoriaMetrics: 2,6М точки данни в секунда; използване на памет: 3 ГБ; окончателен размер на данните на диска: 965 МБ
- InfluxDB: 1.2M точки данни в секунда; използване на памет: 8.5 GB; окончателен размер на данните на диска: 1.6 GB
- Timescale: 849K точки данни в секунда; използване на памет: 2,5 ГБ; окончателен размер на данните на диска: 50 ГБ
Както можете да видите от горепосочените резултати, VictoriaMetrics печели в производителността на вмъкване и степен на компресия. Времевата линия печели в използването на памет, но използва много дисково пространство — 29 байта на точка данни.
По-долу са графиките на използването на процесора (CPU) за всеки от TSDBs по време на бенчмарка:
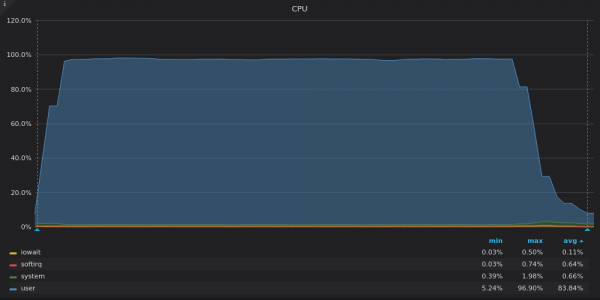
По-горе скрийншот: VictoriaMetrics — натоварване на CPU при тест за вмъкване за уникална метрика 400K.
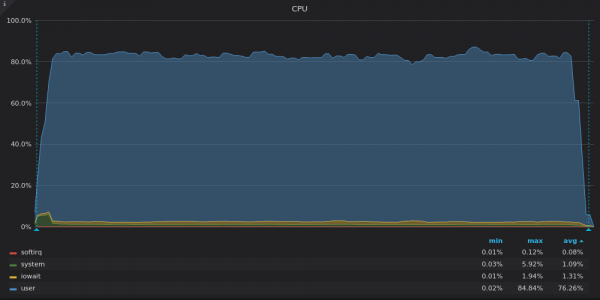
По-горе скрийншот: InfluxDB — натоварване на CPU при тест за вмъкване за уникална метрика 400K.
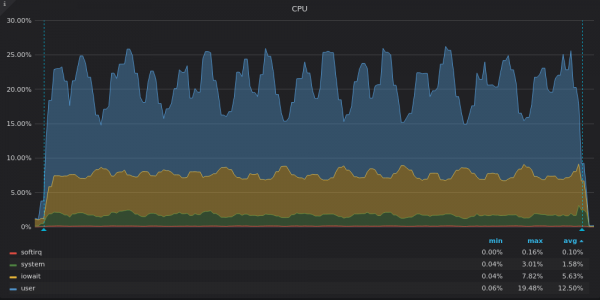
По-горе скрийншот: TimescaleDB — натоварване на CPU при тест за вмъкване за уникална метрика 400K.
VictoriaMetrics използва всичките налични vCPUs, докато InfluxDB не използва достатъчно ~2 от 16 vCPUs.
Timescale използва само 3-4 от 16 vCPUs. Високият дял iowait и system на графиката на TimescaleDB показва тясно място в подсистемата за вход-изход (I/O). Нека да разгледаме графиките за използване на дисковата пропускателна способност:
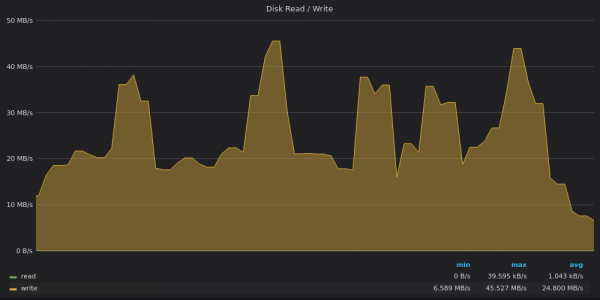
По-горе е скрийншот: VictoriaMetrics — Използване на пропускателната способност на диска при теста за вмъкване на уникални метрики 400K.
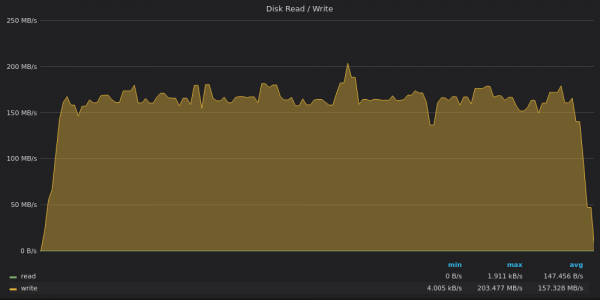
По-горе е скрийншот: InfluxDB — Използване на пропускателната способност на диска при теста за вмъкване на уникални метрики 400K.
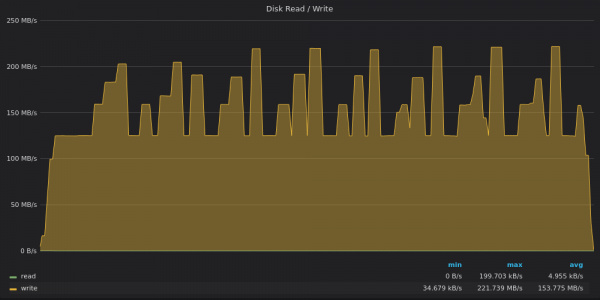
По-горе е скрийншот: TimescaleDB — Използване на пропускателната способност на диска при теста за вмъкване на уникални метрики 400K.
VictoriaMetrics записва данни със скорост 20 Мбит/с с пикове до 45 Мбит/с. Пиковете съответстват на големи частични слияния в дървото. .
InfluxDB записва данни със скорост 160 MB/с, докато 1 TB диск с пропускателна способност на записа 120 MB/с.
TimescaleDB е ограничен с пропускателна способност на записа от 120 Мбит/с, но понякога преминава това ограничение и достига 220 Мбит/с в пикови стойности. Тези пикове съответстват на пропуснати CPU цикли на предишната графика.
Нека да разгледаме графиките за използване на вход-изход (I/O):
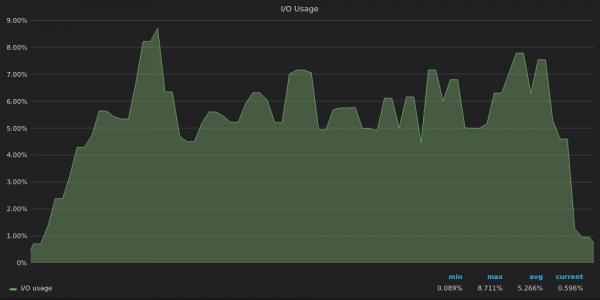
По-горе е скрийншот: VictoriaMetrics — Използване на входа и изхода при теста за вмъкване на 400K уникални метрики.
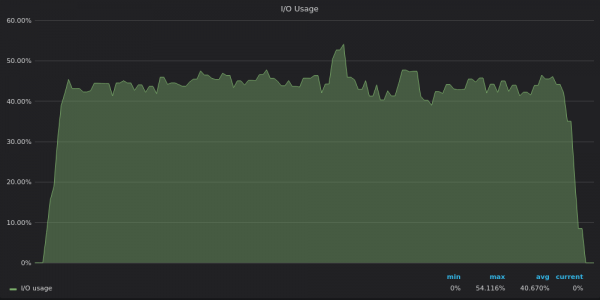
По-горе е скрийншот: InfluxDB — Използване на входа и изхода при теста за вмъкване на 400K уникални метрики.
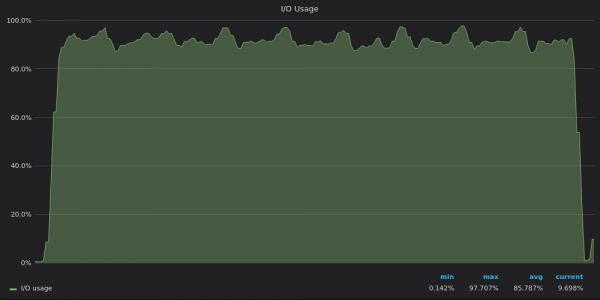
По-горе е скрийншот: TimescaleDB — Използване на входа и изхода при теста за вмъкване на 400K уникални метрики.
Сега е ясно, че TimescaleDB достига лимита на входа и изхода, затова не може да използва оставащите 12 vCPUs.
4M уникални времеви редове
4M времеви редове изглеждат малко предизвикателно. Но нашите конкуренти успешно преминават този тест. Резултати от бенчмарка:
- VictoriaMetrics: 2,2M точки данни в секунда; използване на оперативна памет: 6 GB; окончателен размер на данните на диска: 3 GB.
- InfluxDB: 330K точки данни в секунда; използване на оперативна памет: 20,5 GB; окончателен размер на данните на диска: 18,4 GB.
- TimescaleDB: 480K точки данни в секунда; използване на оперативна памет: 2,5 GB; окончателен размер на данните на диска: 52 GB.
Производителността на InfluxDB спадна от 1,2 милиона точки данни в секунда за 400K времеви ред до 330 хиляди точки данни в секунда за 4M времеви ред. Това е значителна загуба на производителност в сравнение с другите конкуренти. Нека да разгледаме графиките на използването на процесора, за да разберем първопричината за тази загуба:
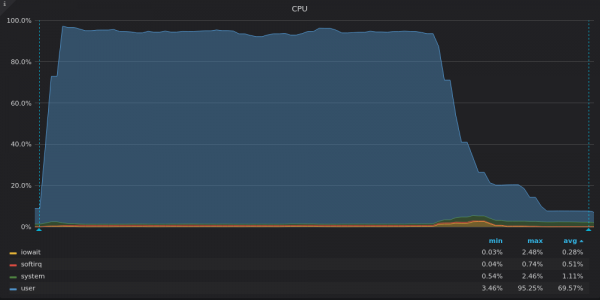
По-горе скрийншот: VictoriaMetrics — Използване на CPU при тест за вмъкване за уникален времеви ред 4M.
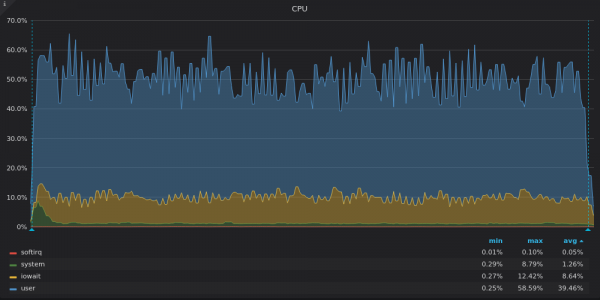
По-горе скрийншот: InfluxDB — Използване на CPU при тест за вмъкване за уникален времеви ред 4M.
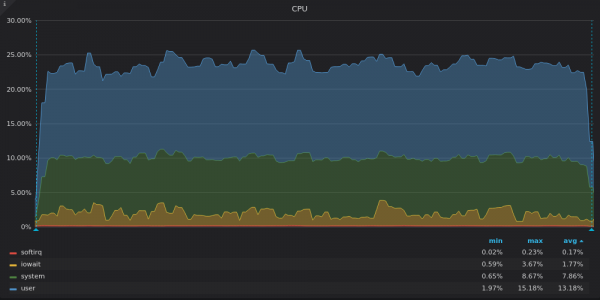
По-горе скрийншот: TimescaleDB — Използване на CPU при тест за вмъкване за уникален времеви ред 4M.
VictoriaMetrics използва почти целия капацитет на процесора (CPU). Спадът в края съответства на останалите LSM сливане след вмъкването на всички данни.
InfluxDB използва само 8 от 16 vCPUs, докато TimescaleDB използва 4 от 16 vCPUs. Какво е общото между техните графики? Висок дял iowait, което отново показва на тясното място при вход-изход.
TimescaleDB има висок дял system. Предполагаме, че високата мощност е довела до много системни повиквания или до множество .
Нека да разгледаме графиките на пропускателната способност на диска:
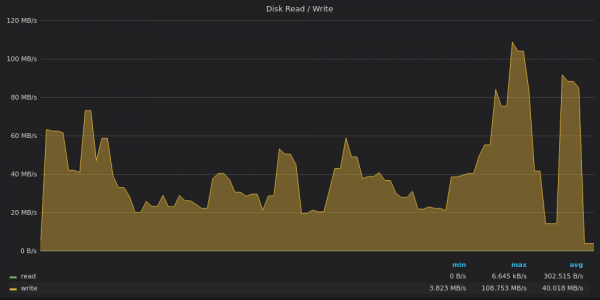
По-горе скрийншот: VictoriaMetrics — Използване на пропускателната способност на диска за вмъкване на 4M уникални метрики.
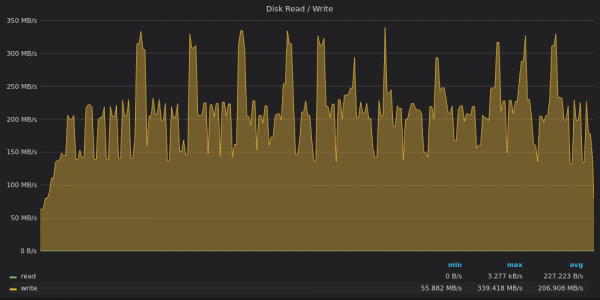
По-горе скрийншот: InfluxDB — Използване на пропускателната способност на диска за вмъкване на 4M уникални метрики.
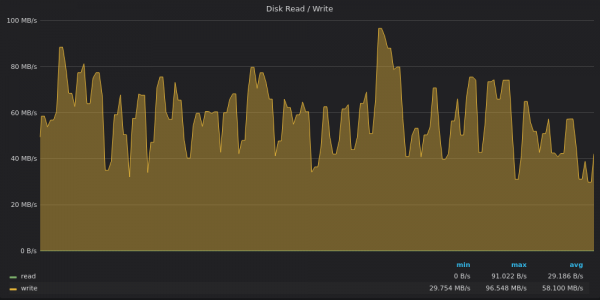
По-горе скрийншот: TimescaleDB — Използване на пропускателната способност на диска за вмъкване на 4M уникални метрики.
VictoriaMetrics достига предел от 120 MB/s при пик, докато средната скорост на запис е 40 MB/s. Вероятно по време на пика е извършено няколко тежки сливане на LSM.
InfluxDB отново извлича средна пропускателна способност на записа от 200 MB/s с пикове до 340 MB/s на диск с ограничение на записа 120 MB/s 🙂
TimescaleDB вече не е ограничена от диска. Изглежда, че е ограничена от нещо друго, свързано с високия дял на системните натоварвания на CPU.
Нека да разгледаме графиките на използването на IO:
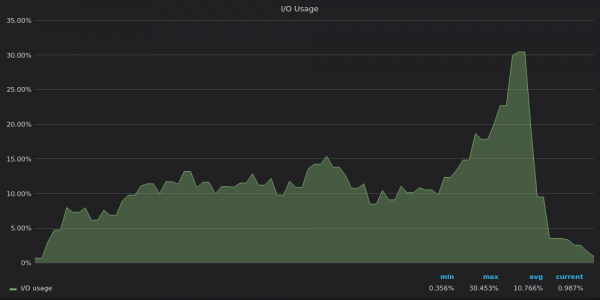
По-горе скрийншот: VictoriaMetrics — Използване на вход-изход по време на теста за вмъкване на уникален времеви ред 4M.
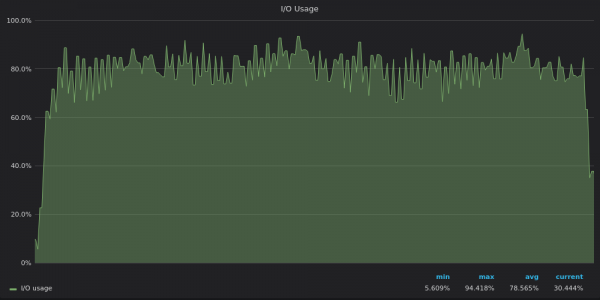
По-горе скрийншот: InfluxDB — Използване на вход-изход по време на теста за вмъкване на уникален времеви ред 4M.
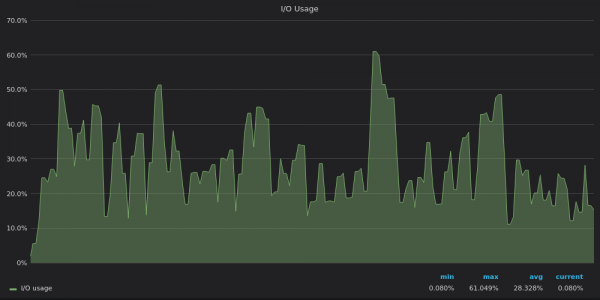
По-горе скрийншот: TimescaleDB — Използване на вход-изход по време на теста за вмъкване на уникален времеви ред 4M.
Графиците на използване на IO повтарят графиците на използване на дисковата честотна лента — InfluxDB е ограничен в IO, докато VictoriaMetrics и TimescaleDB имат излишни ресурси за входно-изходни операции.
40М уникални времеви серии
40М уникални времеви редове бяха твърде големи за InfluxDB 🙁
Резултати от бенчмарка:
- VictoriaMetrics: 1,7М точки данни в секунда; използване на оперативна памет: 29 ГБ; използване на дисково пространство: 17 ГБ.
- InfluxDB: не завърши, защото изискваше над 60 ГБ оперативна памет.
- TimescaleDB: 330К точки данни в секунда, използване на оперативна памет: 2,5 ГБ; използване на дисково пространство: 84GB.
TimescaleDB показва изключително ниско и стабилно използване на оперативна памет – 2,5 ГБ — толкова, колкото и за уникалните метрики от 4M и 400K.
VictoriaMetrics бавно увеличаваше скоростта до 100 хиляди точки данни в секунда, докато не бяха обработени всички 40М имената на метрики с тагове. След това достигна стабилна скорост на вмъкване от 1,5-2,0М точки данни в секунда, така че крайният резултат беше 1,7М точки данни в секунда.
Графиците за 40М уникални времеви редове са сходни с графиците за 4М уникални времеви редове, така че да ги пропуснем.
Изводи
- Съвременните TSDBs могат да обработват вмъквания за милиони уникални времеви редове на един сървър. В следващата статия ще проверим колко добре TSDBs извършват запитвания по милиони уникални времеви редове.
- Недостатъчната натовареност на процесора обикновено показва тясно място в входно-изходните операции. Освен това това може да укаже на прекалено груба блокировка, когато само няколко потока могат да работят едновременно.
- Тясното място в IO наистина съществува, особено в хранилища без SSD, като виртуализирани блокови устройства на облачните доставчици.
- VictoriaMetrics предлага най-добрата оптимизация за бавни хранилища с ниско входно-изходни операции. Той осигурява най-добрата скорост и най-добрата степен на компресия.
Изтеглете и го опитайте с вашите данни. Съответният статичен двоичен файл е наличен на .
Повече за VictoriaMetrics прочетете в тази .
Актуализация: публикувана с възпроизводими резултати.
Актуализация#2: Четете също .
Актуализация #3: !
Чат в Телеграм:
Източник: habr.com
