

Представям ви разшифровка на доклада от началото на 2020 година на Георги Рилов "WAL-G: нови възможности и разширяване на общността"
При поддържачите на open-source възникват много проблеми с растежа им. Как да пишем все повече изисквани функции, да оправяме все повече проблеми и да успяваме да разглеждаме все повече pull request'ове? С примера на WAL-G (инструмент за резервно копиране на PostgreSQL) ще разкажа как решихме тези проблеми, стартирайки курс по Open-source разработка в университета, какво постигнахме и накъде ще се движим напред.
Здравейте отново! Аз съм разработчик в Яндекс от Екатеринбург. И днес ще ви разкажа за WAL-G.
В заглавието на доклада не беше казано, че става дума за резервни копия. Някой не знае какво е WAL-G? Или всички знаят? Вдигнете ръка, ако не знаете. Невероятно, дошли сте на доклад и не знаете за какво става дума.
Нека ви разкажа какво ще има днес. Случи се така, че нашият екип се занимава с резервно копиране от доста време. И това е друг доклад в серия, в която разказваме как съхраняваме данни безопасно, надеждно, удобно и ефективно.
В предишните серии имаше много доклади на Андрей Бородин, Владимир Лесков. Бяхме много. И всички ние разказвахме за WAL-G вече много години.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Този доклад ще се различава малко от останалите, тъй като там беше в голяма степен за техническата част, а тук ще разкажа за това как се сблъскахме с проблемите, свързани с растежа на общността. И как изобретихме малка идея, която ни помага да се справим с това.
Преди няколко години WAL-G беше доста малък проект, който наследихме от Citus Data. И ние просто го взехме. И го разработваше един човек.
И само в WAL-G нямаше:
- Резервно копие от реплика.
- Нямаше инкрементални резервни копия.
- Нямаше WAL-Delta резервни копия.
- И още куп неща, които ги нямаше.
За тези няколко години WAL-G значително нарасна.
И до 2020 година всичко изброено вече беше налично. И към това се добави още:
- Повече от 1 000 звезди в GitHub.
- 150 форка.
- Около 15 отворени PR.
- И още много контрибутори.
- И отворени проблеми постоянно. И това при положение, че ние влизаме там буквално всеки ден и правим нещо с това.
И стигнахме до заключението, че този проект изисква повече наше внимание, дори когато не ни е необходимо да реализираме нещо за нашия сервис Managed Databases в Яндекс.
И някъде през есента на 2018 г. ни хрумна идеята. Обикновено екипът има няколко начина за разработване на функции или отстраняване на грешки, когато не разполага с достатъчно хора. Например, можете да наемете още един разработчик и да му плащате. Или можете да вземете стажант за определен период и също да му плащате заплата. Но има и доста голяма група от хора, част от които вече наистина умеят да пишат код. Просто не винаги знаете какво качество е този код.
Помислихме и решихме да опитаме да привлечем студенти. Но студентите няма да участват във всичко. Те ще извършват само част от работата. Например, ще пишат тестове, ще отстраняват грешки, ще реализират функции, които не засягат основната функционалност. Основната функционалност е създаването на резервни копия и възстановяването им. Ако допуснем грешка при създаването на резервно копие, можем да загубим данни. И, разбира се, никой не иска това. Всички искат всичко да е много надеждно. Затова кодът, на който се доверяваме по-малко от на собствения си, разбира се, не искаме да се допуска. Т.е. всеки некритичен код е това, което бихме искали да получим от нашите допълнителни работни ръце.
При какви условия се приема PR от студент
- Те са задължени да покриват кода си с тестове. Всичко трябва да премине в CI.
- Също така преминаваме през 2 ревюта. Едно от Андрей Бордин и едно от мен.
- Допълнително, за да проверя, че това няма да счупи нищо в нашия сервис, отделно качвам сборка с този комит. И проверяваме в end-to-end тестовете, че нищо не се срива.
Специален курс по Open Source
Някои неща защо е нужно това и защо ми се струва, че е готина идея.
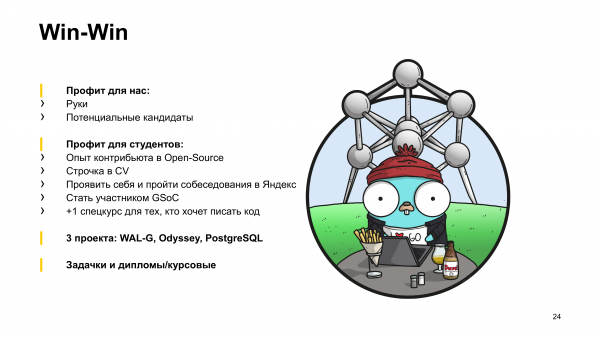
За нас ползата е очевидна:
- Получаваме допълнителни ръце.
- И търсим кандидати за екипа сред способни студенти, които пишат качествен код.
Каква е ползата за студентите?
Те могат да бъдат по-малко очевидни, защото студентите, най-малкo, не получават пари за кода, който пишат, а получават само оценки в зачетката.
Попитах ги за това. И според техните думи:
- Опит на контрибутор в Open Source.
- Да получат ред в CV-то си.
- Да се проявят и да преминат интервю в Яндекс.
- Да станат участници в GSoC.
- +1 специален курс за тези, които искат да пишат код.
Няма да разказвам как бе организиран курсът. Само ще кажа, че WAL-G беше основният проект. Включихме и проекти като Odyssey, PostgreSQL и ClickHouse.
И задаваха задачи не само в този курс, но също така раздаваха дипломи и курсови работи.
А каква е ползата за потребителите?
Сега да преминем към частта, която вероятно ви интересува. Каква е ползата за вас? Ползата е, че студентите поправиха много бъгове. И направиха заявки за функции, които ни поискахте.
И нека да ви разкажа за нещата, които отдавна искате и които бяха реализирани.
Поддръжка на tablespaces. Tablespaces в WAL-G се очакваха, вероятно от момента на пускането на WAL-G, тъй като WAL-G е наследник на друг инструмент за резервно копиране WAL-E, където бяха поддържани резервни копия на бази данни с tablespaces.
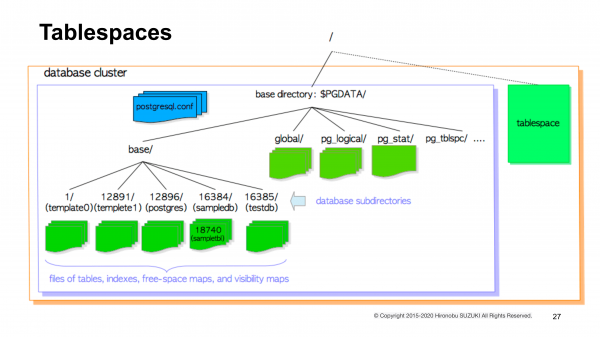
Накратко, ще припомня какво е това и защо е необходимо. Обикновено, всичките ви данни на Postgres занимават една директория в файловата система, наречена основна. И тази директория вече съдържа всички файлове и поддиректории, необходими на Postgres.
Tablespaces са директории, в които се съхраняват данни на Postgres, но те не лежат извън основната директория. На слайда е видно, че tablespaces са извън основната директория.
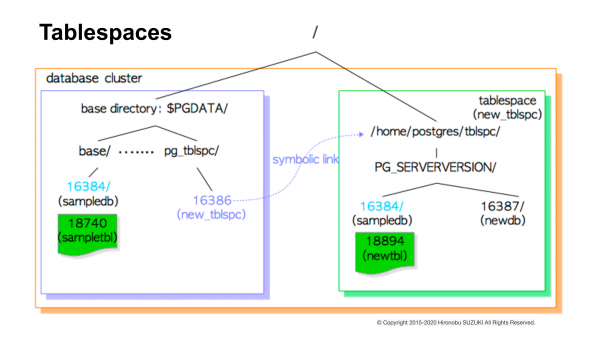
Как изглежда това за самия Postgres? В основната директория има отделна поддиректория pg_tblspc. И в нея са симлинкове към директории, в които реално лежат данните на Postgres извън основната директория.
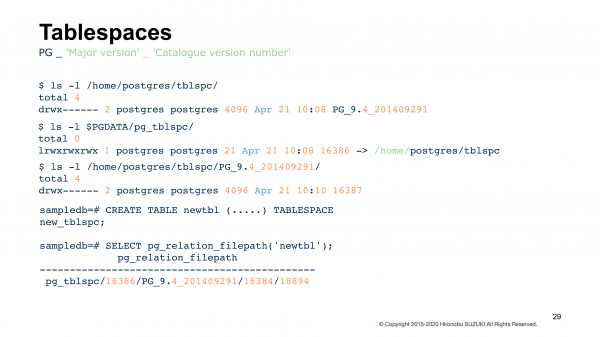
Когато ползвате всичко това, командите за вас могат да изглеждат по този начин. Т.е. създавате таблица в указан tablespace и гледате къде се намира в момента. Тези две последни реда, последните извикани команди. И там е видно, че има някакъв път. Но всъщност – това не е истинският път. Това е път с префикс от основната директория към tablespace. И оттам е свързан чрез симлинк, който води до вашите реални данни.
При нас всичко това не се използва в нашия екип, но много други потребители на WAL-E го използваха, които ни писаха, че искат да преминат на WAL-G, но това им пречеше. Сега това се поддържа.
Друга функция, която ни донесе нашият специализиран курс, е catchup. За catchup знаят хора, които, вероятно, повече са работили с Oracle, отколкото с Postgres.
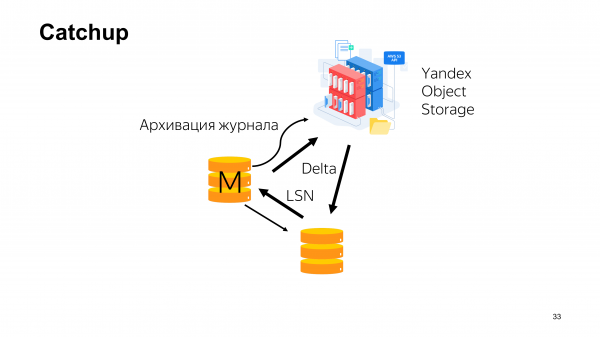
Накратко за това какво е. Възможно е топологията на клъстера в нашия сервис да изглежда по този начин. Имаме мастер. Има реплика, която стриймва от него write-ahead log. Репликата казва на мастера на какво LSN се намира в момента. Паралелно с това може да се архивира журналът. Освен архивирането на журнала, в облака се изпращат резервни копия. Изпращат се и дельта резервни копия.
Какви могат да бъдат проблемите? Когато имате доста голяма база данни, може да се получи така, че репликата да започне да изостава значително от мастера. И тя изостава толкова много, че никога не може да го настигне. Този проблем обикновено трябва да се решава по някакъв начин.
Най-простият начин е да премахнете репликата и да я налеете наново, защото тя никога няма да настигне, а трябва да се реши проблема. Но това е доста дълго, защото възстановяването на цял резервен копие на база от 10 TB е много, много бавно. Искаме да направим всичко възможно по-бързо, ако се появят такива проблеми. И именно за това е предназначен catchup.
Catchup позволява използването на дельта резервни копия, които се запазват в облака по този начин. Вие казвате на какво LSN се намира в момента изоставащата реплика и го указвате в командата catchup, за да създадете дельта резервно копие между това LSN и LSN, на което в момента се намира вашият клъстер. А след това възстановявате това резервно копие на изоставащата реплика.
Други бази
Освен това студентите ни донесоха много функции. Тъй като в Yandex работим не само с Postgres, имаме и MySQL, MongoDB, Redis, ClickHouse, в определен момент ни беше необходимо да можем да правим резервни копия с възможност за възстановяване в определен момент за MySQL и да имаме възможността да ги качваме в облака.
Искахме да направим това по начин, подобен на WAL-G. Решихме да експериментираме и да видим как ще изглежда всичко.
Първоначално без да разделяме тази логика в форка написахме код. Установихме, че имаме работна модел и това може да проработи. След това помислихме, че нашата основна общност е postgres любители, които използват WAL-G. И затова трябваше да разделим тези части. Тоест, когато поправяме кода за Postgres, не счупваме MySQL, а когато поправяме MySQL, не счупваме Postgres.
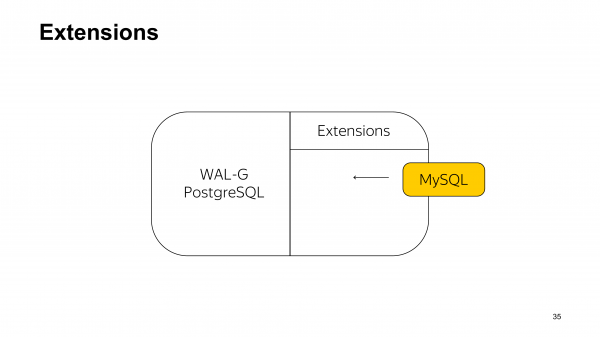
Първата идея за разделяне на това беше да се използва същият подход, който се прилага в разширенията на PostgreSQL. И всъщност, за да направите резервно копие на MySQL, трябваше да инсталирате някаква динамична библиотека.
Но тук веднага се вижда асиметрията на този подход. Когато резервирате Postgres, просто инсталирате нормален резервен инструмент за Postgres и всичко е наред. А при MySQL извежда, че инсталирате резервен инструмент за Postgres и още за него поставяте динамична библиотека за MySQL. Звучи някак странно. И ние също така си помислихме и решихме, че това не е решението, от което имаме нужда.
Различни сборки за Postgres, MySQL, MongoDB, Redis
Но това ни позволи, според нас, да стигнем до правилното решение - да се отделят различни сборки за различни бази данни. Това позволяваше да се изолира логиката, свързана с резервните копия на различните бази данни, които ще използват общ API, реализиран от WAL-G.
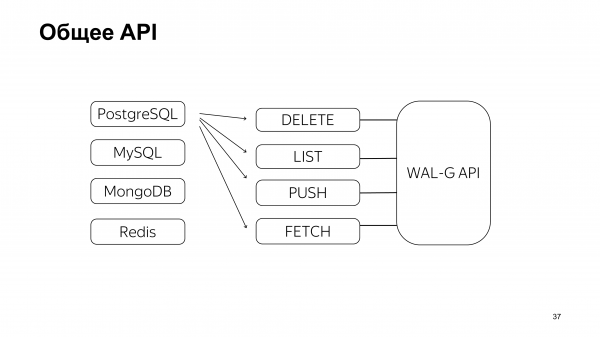
Това е частта, която написахме сами - преди да дадем задачи на студентите. Тоест, това е именно частта, в която те могат да направят нещо неправилно, затова решихме, че е по-добре да направим нещо сами и всичко ще бъде отлично.
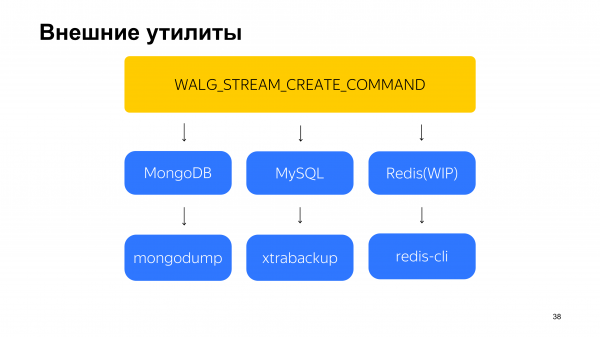
След това издадохме задачи. Те веднага бяха разбрани. От студентите се изискваше да поддържат три бази.
Това е MySQL, която резервираме с помощта на WAL-G по този начин вече повече от година.
И вече MongoDB наближава до продукция, там я доизкусуряват. По същество, конструкцията за всичко това я написахме ние. След това студентите написаха някакви работещи неща. И след това ние ги довеждаме до състояние, което можем да приемем в нашата продукция.
Тези задачи не изглеждаха така, че студентите да трябва да напишат цялостни инструменти за резервно копие за всяка от тези бази. Ние не допускахме такава проблема. Нашата задача беше, че искахме възстановяване точка-в-структура и искахме да резервираме в облака. И помолихме студентите да напишат код, който ще реши това. Студентите използваха вече съществуващи инструменти за резервно копие, които по някакъв начин правят резервни копия, а след това ги свързваха с WAL-G, който прехвърляше всичко това в облака. Те също така добавяха възстановяване точка-в-структура.
Какво още донесоха студентите? Те донесоха в WAL-G поддръжка на шифроване с Libsodium.
Също така се появиха политики за съхранение на резервни копия. Сега резервните копия могат да бъдат маркирани като перманентни. И по-удобно е за вашата услуга да автоматизира процеса на тяхното съхранение.
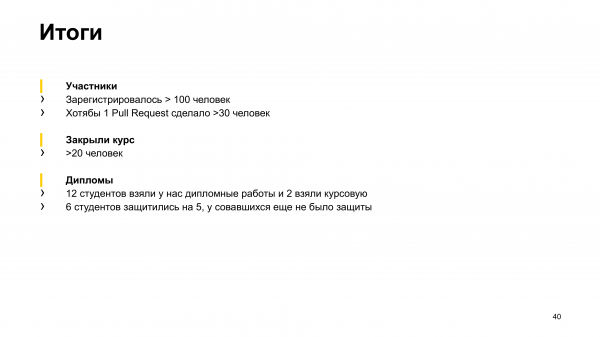
Какви са резултатите от този експеримент?
Първоначално над 100 души се регистрираха за курса. В началото не споменах, че университетът в Екатеринбург е Уралският федерален университет. Там анонсирахме всичко. 100 души се регистрираха. Всъщност много по-малко започнаха да работят, около 30 души.
Още по-малко хора завършиха курса, тъй като трябваше да напишат тестове за вече съществуващия код. Трябваше също така да поправят бъг или да реализират някаква функция. Някои студенти все пак завършиха курса.
В момента за този курс студентите поправиха около 14 проблеми и реализираха 10 функции с различен размер. И, според мен, това е равностойно на един-два разработчици.
Освен всичко друго, издадохме дипломи и курсови работи. 12 души взеха дипломи. 6 от тях вече защитиха на "5". У останалите все още не е имало защити, но смятам, че и при тях всичко ще е добре.
Планове за бъдещето
Какви са плановете ни за бъдещето?
Понеже вече чухме искания за функции от потребителите, които искаме да реализираме. Те са:
- Проследяване на коректността на таймлайна в архива на резервните копия на HA-кластера. С помощта на WAL-G това е възможно. И мисля, че ще намерим студенти, които биха се заели с това.
- Ние вече имаме отговорен човек за преноса на резервните копия и WAL между облаците.
- Скоро публикувахме идеята, че можем да ускорим WAL-G още повече чрез разопаковане на инкрементални резервни копия без презаписване на страниците и оптимизация на архивите, които изпращаме.
Можете да ги споделите тук
За какво беше тази презентация? За това, че в момента, освен нас четиримата, които поддържат този проект, имаме дополнителни ръце, доста много. Особено ако им пишете на лични съобщения. И ако правите резервни копия на данните си и използвате WAL-G или искате да преминете на WAL-G, вашите желания можем да вземем предвид доста лесно.
Това е QR код и линк. Можете да ги използвате, за да споделите всичките си желания. Например, ако имаме бъг, който не поправяме. Или функция, която много искате, но за някаква причина не я има в нито един резервен софтуер, включително и в нашия. Задължително ни пишете за това.
Въпроси
Здравейте! Благодаря за доклада! Въпрос относно WAL-G, но не за Postgres. WAL-G прави бекап на MySQL и извиква екстра-бекап. Ако вземем съвременни инсталации на CentOS и ако направите yum install MySQL, ще се инсталира MariaDB. От версия 10.3 екстра-бекап не се поддържа, поддържа се MariaDB-бекап. Как е при вас с това?
В момента не сме опитвали да правим бекап на MariaDB. Имахме запитвания за поддръжка на FoundationDB, но в крайна сметка, ако има такова запитване, можем да намерим хора, които да го направят. Не е толкова дълго и не е толкова сложно, колкото ми се струва.
Добър ден! Благодаря за доклада! Въпрос относно потенциално нови функции. Готови ли сте да накарате WAL-G да работи с ленти, за да можем да правим бекап на ленти?
Има предвид бекап на лентово хранилище, нали?
Да.
Там е Андрей Борисов, който може да отговори на този въпрос по-добре от мен.
(Андрей) Да, благодаря за въпроса! Имахме запитване за пренос на бекап на лента от облачно хранилище. И за това пренос между облаци. Защото преносът между облаците е някаква обобщена версия на преноса на лента. Освен това, имаме разширима архитектура в частта хранилища. Между другото, много хранилища бяха написани от студенти. И ако напишете хранилище за ленти, то ще бъде поддържано. Готови сме да разгледаме pull request. Необходимо е да запишете файл, да прочетете файл. Ако тези неща се направят на Go, обикновено излиза около 50 реда код. Тогава ще се поддържа лента в WAL-G.
Благодаря за доклада! Интересен процес на разработка. Бекапът е сериозна част от функционалността, която трябва да бъде добре покрита с тестове. Когато реализирахте функционалността за нови бази, тестовете пишеха ли също студенти или вие сами написахте тестовете и после предоставихте реализирането на студентите?
Тестовете също бяха написани от студенти. Но студентите пишеха повече за такива функции като нови бази. Те пишеха интеграционни тестове. И писаха unit-тестове. Ако интеграционните преминават, т.е. в момента – това е сценарий, който изпълнявате на ръка или това го прави cron, например. Т.е. там сценарият е много ясен.
Студентите нямат много опит. Колко време отнема прегледа?
Да, на ревю отнема доста време. А това означава, че обикновено, когато дойдат няколко комитери и казват, че аз направих това, аз направих онова, трябва да се помисли и да се отдели половин ден, за да се разбере какво са написали. Защото кодът трябва да се чете внимателно. Те не преминават интервю и не ги знаем много добре, затова отнема значително време.
Благодаря за доклада! По-рано Андрей Бородин заявяваше, че archive_command в WAL-G трябва да бъде извикван директно. Но в случай на какъвто и да е патронен кластер, ни е необходима допълнителна логика за определяне на нодата, към която да изпращаме вали. Как вие решавате този проблем?
В какво се състои вашият проблем? Да кажем, че имате синхронна реплика, от която правите резервно копие? Или какво?
(Андрей) Работата е там, че наистина WAL-G предвижда използване без обвързване с shell-скриптове. Ако нещо липсва, да добавим логиката, която трябва да бъде в WAL-G. Що се отнася до начина, по който трябва да се правят архиви, считаме, че архивирането трябва да бъде от текущия майстор в клъстера. Архивиране от реплика е лоша идея. Там може да се появят различни сценарии с проблеми. По-специално, проблеми с архивирането на времеви линии и всякаква допълнителна информация. Благодаря за въпроса!
(Уточнение: От обвързването с shell-скриптове се освободихме) )
Добър вечер! Благодаря за доклада! Заинтересува ме функцията catchup, за която обяснихте. Столквали ли сте се със ситуация на отставяне на реплика, която не можеше да догони? И не намерих описание на тази функция в документацията на WAL-G.
Catchup се появи буквално в края на януари 2020 година. Може би е добре да поработим малко по-добре с документацията. Ние сами я пишем и не правим това отлично. И може би е добре да започнем да изискваме от студентите да я пишат.
Тя вече ли е в реализация?
Pull заявката вече е merged, т.е. проверих я. Опитах това на тестовия кластер. Още нямаме ситуация, в която да можем да проверим това на реален пример.
Кога да очакваме?
Не знам. Изчакайте месец, а ние ще проверим.
Източник: habr.com
