

Логовете са важна част от системата, която позволява да разберем дали тя функционира (или не функционира) както се очаква. При условията на микросервисна архитектура работата с логовете става отделна дисциплина на специална олимпиада. Нужно е да се решат веднага куп въпроси:
- как да се пишат логове от приложението;
- къде да се пишат логове;
- как да се доставят логове за съхранение и обработка;
- как да се обработват и съхраняват логовете.
Прилагането на популярни в момента технологии за контейнеризация добавя песъчливост върху граблите на полето с решения на задачата.
Това е в същността на доклада на Юрий Бушмелев „Карта на граблите на полето за събиране и доставка на логове“
На когото му е интересно, моля под кат.
Казвам се Юрий Бушмелев. Работя в Lazada. Днес ще говоря за това как изградихме нашите логове, как ги събирахме и какво записваме в тях.
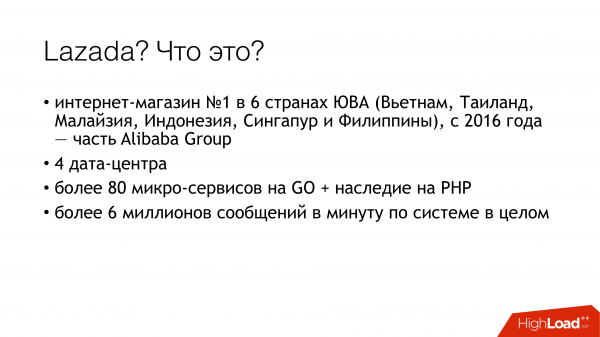
Откъде сме? Кои сме ние? Lazada е интернет магазин №1 в шест страни на Югоизточна Азия. Всички тези страни са разпределени по дата центрове. В момента имаме 4 дата центъра. Защо е важно? Защото някои решения бяха обусловени от факта, че между центровете има много слаб линк. Имаме микросервисна архитектура. Учудих се, че имаме вече 80 микросервиса. Когато започнах с логовете, имаше само 20. Има и доста голямо парче PHP наследство, с което също трябва да живеем и да се примирим. Всичко това в момента генерира над 6 милиона съобщения в минута в системата като цяло. По-долу ще покажа как се опитваме да живеем с това и защо е така.
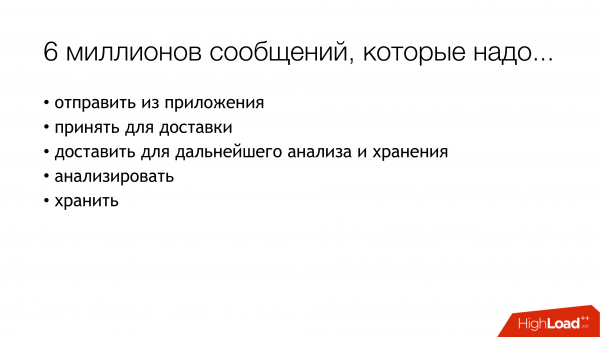
С тези 6 милиона съобщения трябва да живеем по някакъв начин. Какво трябва да направим с тях? 6 милиона съобщения, които трябва да:
- изпратим от приложението
- приемем за доставка
- доставим за анализ и съхранение.
- проанализираме
- по някакъв начин да ги съхраняваме.
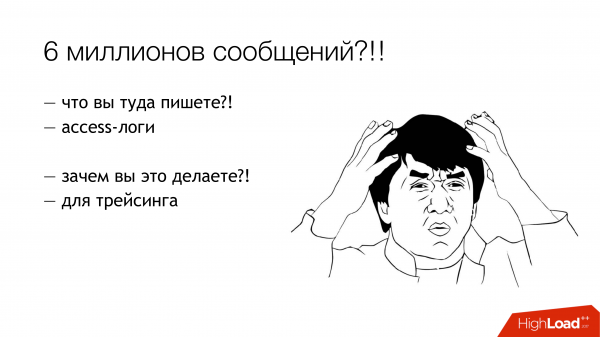
Когато се появиха три милиона съобщения, изглеждах по подобен начин. Защото започнахме с някакви пари. Ясно е, че там се записват логове на приложенията. Например, не успях да се свържа с базата данни, успях да се свържа с базата данни, но не успях да прочета нещо. Но освен това, всеки наш микросервис пише и access лог. Всички заявки, минаващи през микросервиса, попадат в логовете. Защо го правим? Разработчиците искат да имат възможност за трасиране. Във всеки access лог има поле traceid, по което специален интерфейс проследява целия процес и красиво показва трасето. Трасето показва как е преминала заявката и помага на нашите разработчици по-бързо да се справят с всякакви неопознати проблеми.
Как да живеем с това? Сега накратко ще разкажа за вариантите - как се решава проблемът. Как да се реши задачата за събиране, предаване и съхранение на логове.
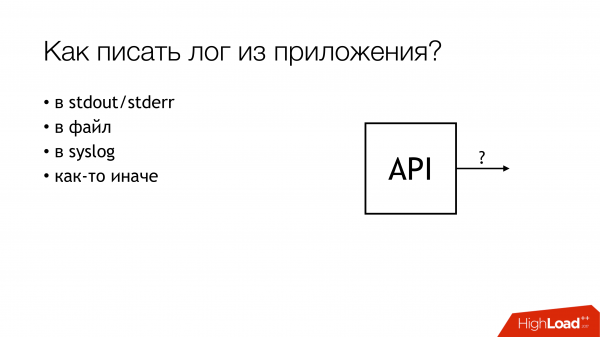
Как да пишем от приложението? Ясно е, че има различни начини. По-специално, има добри практики, как ни разказват модерни експерти. Има старо училище в два варианта, както разказваха дядовците. Има и други начини.
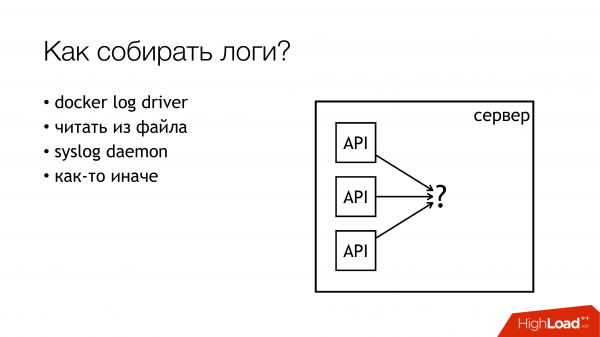
Събирането на логове е горе-долу с подобна ситуация. Вариантите за решаване на тази конкретна част не са много. Има повече, но все още не толкова много.
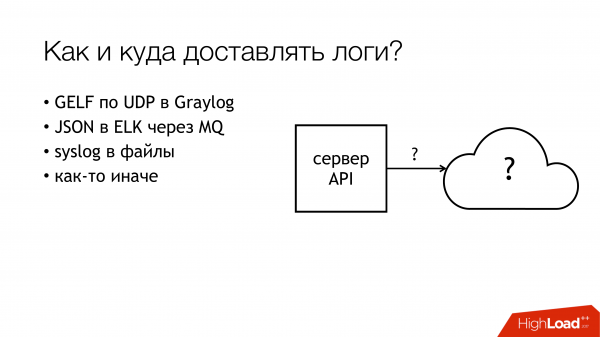
А с доставката и последващия анализ - броят на вариантите започва да нараства експоненциално. Няма да описвам всеки вариант в момента. Мисля, че основните варианти са известни на всички, които се интересуват от темата.
Ще покажа как го направихме в Lazada и как всъщност всичко това започна.
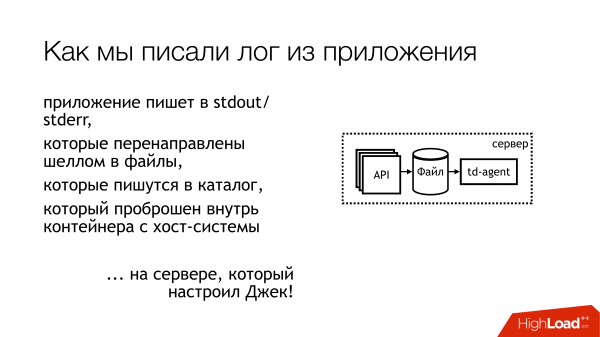
Преди година дойдох в Lazada и бях изпратен на проект за логове. Вече беше горе-долу така. Логовете от приложението се записваха в stdout и stderr. Всички се направиха по модата. Но след това разработчиците ги изхвърлиха от стандартните потоци, а след това инфраструктурните специалисти ще се оправят. Между инфраструктурните специалисти и разработчиците имаше и Release специалисты, които казаха: "еее... добре, нека просто ги опаковаме в файл с shell и толкова". А тъй като всичко това е в контейнер, го опаковахме направо в контейнера, мапирахме директорията и го сложихме там. Мисля, че на всички е приблизително очевидно какво се получи от това.
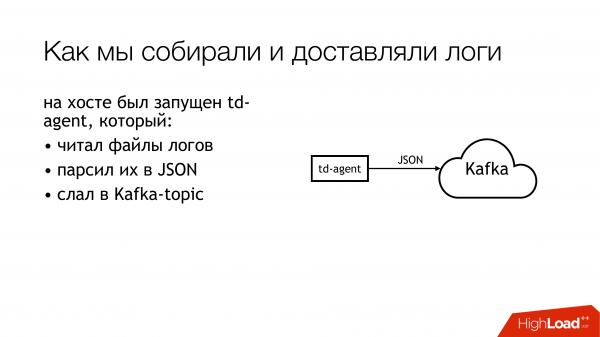
Да видим по-далеч. Как сме тези логове предавахме. Някой избра td-agent, който всъщност е fluentd, но не съвсем fluentd. Все още не разбрах отношенията между тези два проекта, но изглежда, че става дума за едно и също. И този fluentd, написан на Ruby, четеше файловете с логове и ги парсеше в JSON по определени регулярни изрази. След това ги изпращаше в Kafka. И в Kafka за всеки API имахме 4 отделни теми. Защо 4? Защото има live, има staging, и защото има stdout и stderr. Разработчиците ги създават, а инфраструктурните специалисти трябва да ги създават в Kafka. Освен това, Kafka се контролираше от друг отдел. Затова трябваше да създадем тикет, за да създадат там 4 теми за всеки API. Всички за това забравяха. В общи линии, беше хаос и ураган.
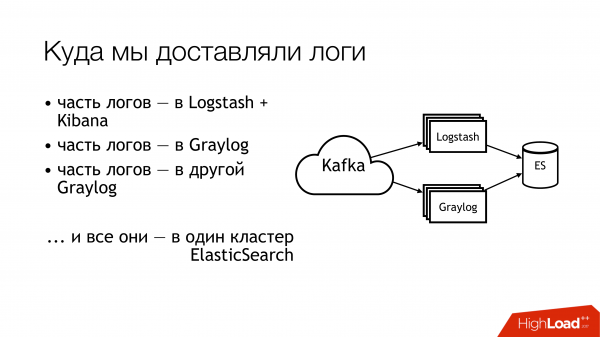
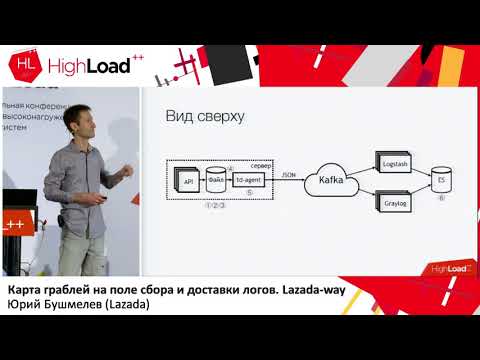
Какво правихме след това? Изпращахме го в Kafka. След това половината логове отиваха в Logstash. Другата половина от логовете беше разделена. Част отиваше в един Graylog, част – в друг Graylog. В крайна сметка всичко това се изпращаше в един кластер Elasticsearch. Тоест, целият този хаос в крайна сметка падаше там. Не трябва да се прави така!
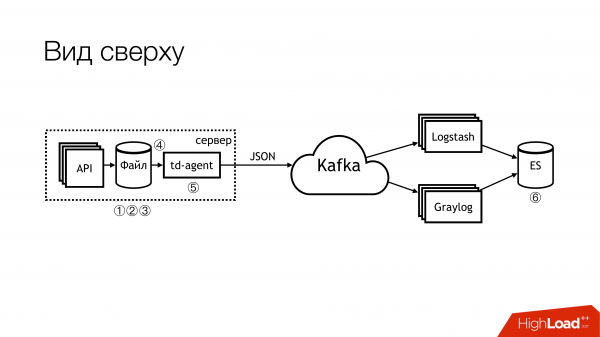
Така изглежда, ако отдалеч погледнете. Не трябва да се прави така! Тук цифрите веднага маркират проблемните места. На практика те са повече, но 6 — това са директно проблемни, с които трябва да се направи нещо. За тях сега ще разкажа отделно.
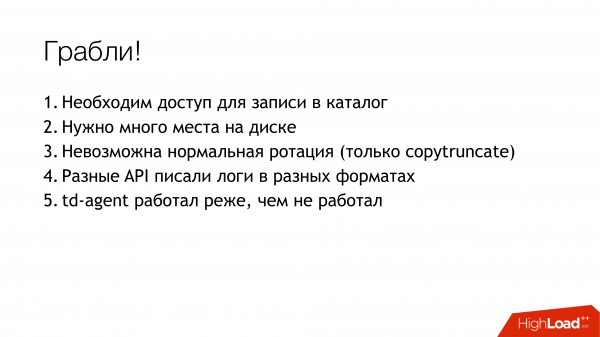
Тук (1,2,3) пишем файлове и, съответно, тук веднага се появяват три капана.
Първото (1) — трябва да ги пишем някъде. Не винаги бихме искали API да има възможност да пише директно в файл. Желателно е API да бъде изолирано в контейнер, а още по-добре – да бъде само за четене. Аз съм системен администратор, така че имам малко алтернативен поглед върху тези неща.
Вторият момент (2,3) — получаваме много заявки в API. API записва много данни във файл. Файловете растат. Трябва да ги ротирани. В противен случай, няма как да стигнем до достатъчно дискове. Ротацията е трудна, защото файловете се пренасочват през shell в директория. Не можем да ги ротираме. Не можем да кажем на приложението да затвори отново дескрипторите. Защото разработчиците ще ни гледат като на глупаци: „Какви дескриптори? Ние записваме директно в stdout“. Инфраструктурният екип направи copytruncate в logrotate, който просто копира файла и преполовява оригинала. Следователно, обикновено между тези процеси на копиране свършва мястото на диска.
(4) Имахме различни формати в различни API. Те леко се различаваха, но трябваше да пишем различни regexp. Тъй като всичко това се управляваше от Puppet, имаше голямо струпване на класове с техните проблеми. Освен това td-agent можеше да консумира голяма част от времето памет, да забавя работата, можеше просто да прави вида, че работи, и да не прави нищо. Отвън беше невъзможно да се разбере, че той не работи. В най-добрия случай, той ще падне и някой ще го възстанови по-късно. По-точно, ще дойде сигнал и някой ръчно ще го възстанови.
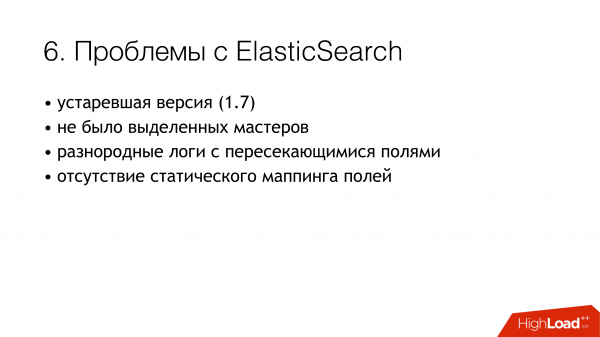
(6) И най-голямата бъркотия — това беше elasticsearch. Защото, това беше стара версия. Нямахме отделни мейстори по това време. Имахме хетерогенни логове, чиито полета можеха да се пресекат. Различни логове от различни приложения можеха да бъдат записвани с еднакви имена на полета, но вътре можеха да имат различни данни. Тоест, един лог идва с Integer в полето, например, level. Друг лог идва с String в полето level. Без статичен мапинг получаваме такава забележителна ситуация. Ако след ротацията на индекса в elasticsearch първото пристигнало съобщение е с низ, то всичко е наред. Но ако първото е с Integer, всички последващи съобщения, които пристигат с низ, просто се отхвърлят. Защото типът на полето не съвпада.
Започнахме да се задаваме тези въпроси. Решихме да не търсим виновни.
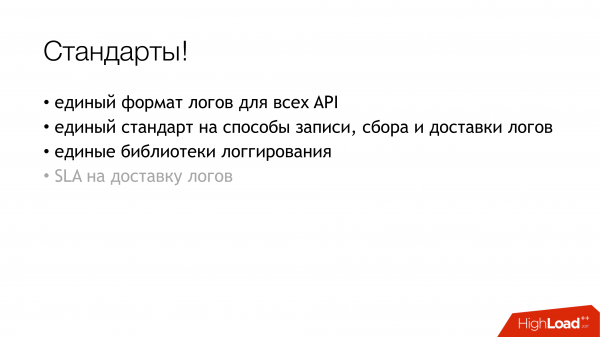
Трябва нещо да се предприеме! Очевидното е, че трябва да се създадат стандарти. Някои стандарти вече съществуваха. Някои бяха въведени по-късно. За щастие, единният формат за логовете на всички API беше вече утвърден до този момент. Той е записан в стандартите за взаимодействие на услугите. Следователно, тези, които искат да получават логове, трябва да ги записват в този формат. Ако някой не записва логове в този формат, значи, не можем да гарантираме нищо.
Следващото, което искам, е да установим единен стандарт за методите на записване, доставка и събиране на логове. Същността е къде да бъдат записвани и с какво да бъдат доставяни. Идеалната ситуация е, когато в проектите се използва една и съща библиотека. Например, има отделна библиотека за логиране за Go и отделна библиотека за PHP. Всички, които имаме, трябва да ги използват. В момента може би около 80% от нас го постигат. Но някои все още ядат кактуси.
И ето там (на слайда) едва-едва започва да се очертава „SLA за доставка на логове“. Все още го няма, но работим по него. Защото е много удобно, когато инфраструктурата казва, че ако пишете в такъв формат на такова място и не повече от N съобщения в секунда, ние с определена вероятност ще ги доставим точно там. Това облекчава много главоболия. Ако SLA съществува, то това е наистина чудесно!
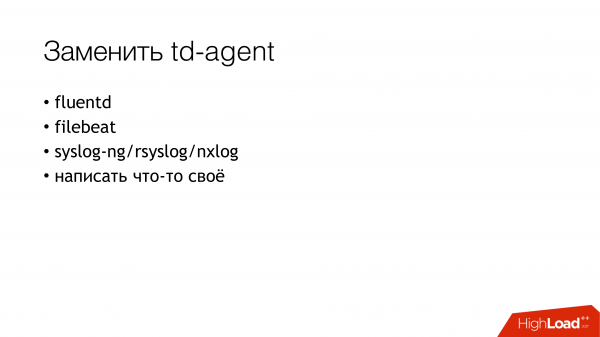
Как започнахме да решаваме проблема? Основната пречка беше с td-agent. Не беше ясно къде изчезват логовете. Доставят ли се? Събират ли се? Къде са изобщо? Затова, на първо място, беше решено да заменим td-agent. Варианти за замяна, накратко, набросих тук.
Fluentd. Първо, срещал съм се с него на предишната работа и там също периодично падаше. Второ, това е същото, но в профил.
Filebeat. Какво беше удобно за нас при него? Той е на Go, а ние имаме голяма експертиза в Go. Следователно, ако нещо се наложи, бихме могли да го адаптираме за нашите нужди. Затова не го избрахме. За да не съществува никакво изкушение да започнем да го преписваме за себе си.
Очевидното решение за системния администратор остават всякакви системни логове в такова количество (syslog-ng/rsyslog/nxlog).
Или да напишем нещо собствено, но това го отхвърлихме, както и filebeat. Ако трябва нещо да пишем, по-добре да е нещо полезно за бизнеса. За доставката на логове е по-добре да се вземе нещо готово.
Следователно, изборът всъщност се свежда до избора между syslog-ng и rsyslog. Наклоних се към rsyslog просто защото в Puppet вече имахме класове за rsyslog, а не намерих очевидна разлика между тях. Както в syslog, така и в rsyslog. Да, при някого документацията е по-лоша, при друг - по-добра. Единият го прави така, а другият - по различен начин.
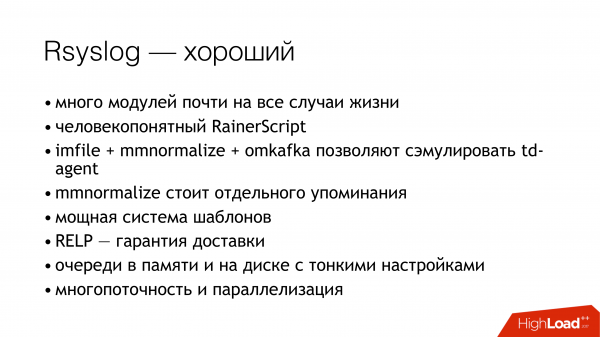
И малко за rsyslog. Първо, той е страхотен, защото има много модули. Има лесен за разбиране RainerScript (съвременен език за конфигурация). Страхотен бонус е, че можехме да емулираме поведението на td-agent с вградените средства и за приложенията не се променя нищо. Тоест, сменяме td-agent с rsyslog, а всичко останало остава непроменено. И веднага получаваме работеща доставка. Освен това, mmnormalize е страхотна функция в rsyslog. Тя позволява анализиране на логове, но не с Grok и regexp. Тя изгражда абстрактно синтактично дърво. Парсира логовете по начина, по който компилаторът парсира изходен код. Това позволява много бърза работа, малко потребление на CPU и всъщност, е наистина страхотна функция. Има много други бонуси. Няма да се спирам на тях.
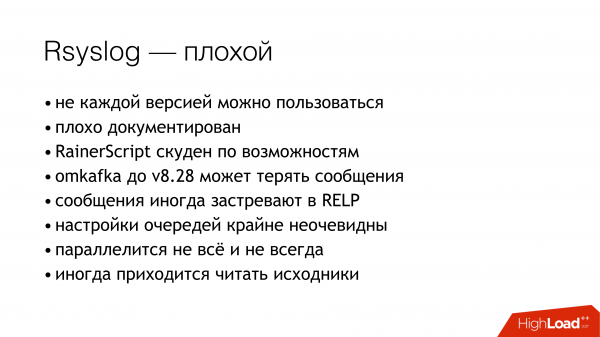
rsyslog има и много недостатъци. Те са приблизително същите като бонусите. Основните проблеми са, че трябва да знаеш как да го настроиш и да избереш правилната версия.
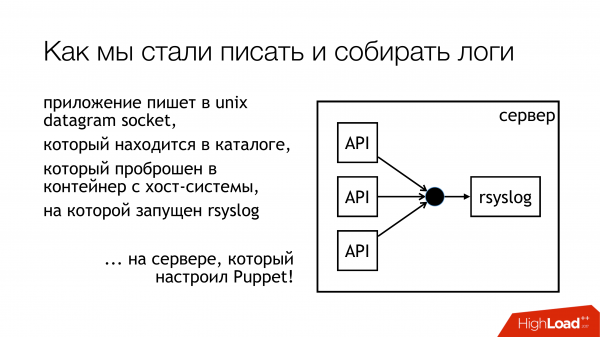
Решихме, че ще пишем логовете в unix сокет. И то не в /dev/log, защото там имаме бъркотия от системни логове, там journald е в този pipeline. Затова дава да пишем в персонализиран сокет. Ще го свържем с отделен ruleset. Няма да смесваме нищо. Всичко ще е прозрачно и ясно. Всъщност така и направихме. Директорията с тези сокети е стандартизирана и се предава на всички контейнери. Контейнерите могат да видят нужния им сокет, да го отворят и да записват в него.
Защо не файл? Защото всички прочетоха , която се опитваше да предаде файл в docker и установи, че след рестарт на rsyslog файловият дескриптор се променя и docker губи този файл. Той държи отворено нещо различно, но вече не е този сокет, в който се записва. Решихме, че ще заобиколим този проблем и, заедно с това, ще заобиколим проблема с блокирането.
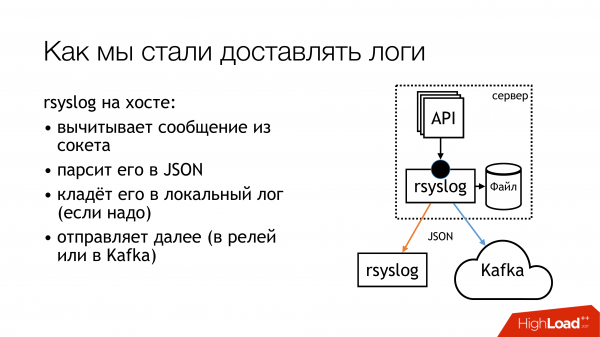
Rsyslog извършва действията, посочени на слайда, и изпраща логовете или в релей, или в Kafka. Kafka съответства на стария метод. Релей - опитах се да използвам чисто rsyslog за доставка на логове. Без Message Queue, със стандартни средства на rsyslog. В принципе, това работи.
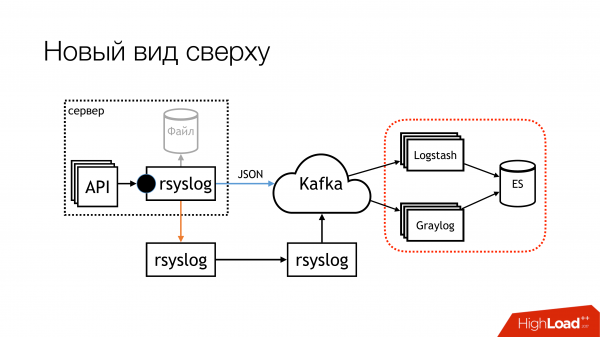
Но има нюанси как да ги вкараме после в тази част (Logstash/Graylog/ES). Тази част (rsyslog-rsyslog) се използва между дата центровете. Има compressed tcp линк, който позволява да спестим bandwidth и, съответно, по някакъв начин да увеличим вероятността да получим някакви логове от друг дата център в условия, когато каналът е задръстен. Защото имаме Индонезия, където всичко е лошо. Там това е постоянен проблем.
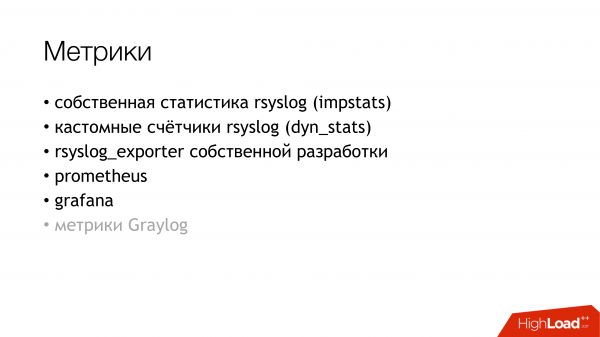
Замислихме се как да мониторим вероятността логовете, които записваме от приложението, да стигнат до края. Решихме да съберем метрики. Rsyslog има собствен модул за събиране на статистики, в който има някакви броячи. Например, той може да ви покаже размера на опашката или колко съобщения са пристигнали в конкретно действие. От тях вече може да се вземе нещо. Плюс това, той има персонализирани броячи, които могат да бъдат настроени, и той ще ви показва, например, броя на съобщенията, които записало някакво API. След това написах rsyslog_exporter на Python, и изпратихме всичко това в Prometheus и построихме графики. Метриките на Graylog много ни интересуваха, но все още не успяхме да ги настроим.
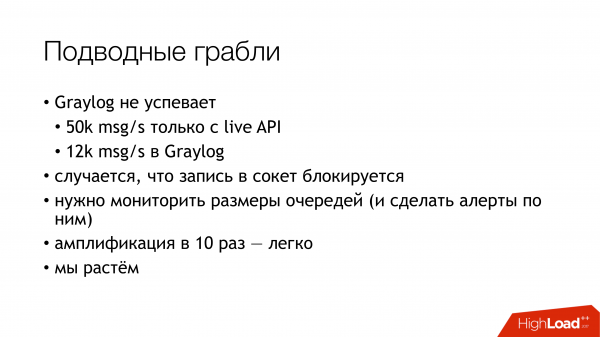
С какви проблеми се сблъскахме? Проблемите възникнаха от факта, че установихме (неочаквано!), че нашите Live API пишат по 50k съобщения в секунда. Това е само Live API без staging. А Graylog ни показва само 12 хиляди съобщения в секунда. И възникна резонен въпрос, а къде са остатъците? От което направихме заключение, че Graylog просто не се справя. Погледнахме, и наистина, Graylog с Elasticsearch не можеха да обслужват този поток.
Наскоро направихме и други открития в процеса.
Записите в сокетите се блокират. Как стана това? Когато използвах rsyslog за доставка, в един момент каналът между дата центровете ни се счупи. Доставката спря на едно място, спря и на друго място. Всичко това стигна до машината с API, които пишат в сокета на rsyslog. Там опашката се запълни. След това се запълни опашката за запис в unix сокет, която по подразбиране е 128 пакета. И следващият write() в приложението се блокира. Когато погледнахме в библиотеката, която използваме в приложенията на Go, беше написано, че записът в сокета става в неблокиращи режим. Бяхме уверени, че нищо не се блокира. Защото четохме. , която го написа. Но има един момент. Около това извикване имаше безкраен цикъл, в който постоянно се опитвахме да запушим съобщение в сокета. Това не го забелязахме. Пришло се наложи да препишем библиотеката. Оттогава тя се промени няколко пъти, но сега сме се отървали от блокировките във всички подсистеми. Затова можем да спрем rsyslog и нищо няма да се срине.
Трябва да следим размера на опашките, което помага да не настъпим тези грабли. Първо, можем да следим, когато започнем да губим съобщения. Второ, можем да следим, че имаме принципно проблеми с доставката.
И още един неприятен момент — амплификацията в 10 пъти в микросервизна архитектура — е много лесна. Нямаме толкова много постъпващи запитвания, но заради графа, по който тичат тези съобщения по-нататък, заради access логовете, всъщност увеличаваме натоварването по логовете около десет пъти. За съжаление не успях да пресметна точните цифри, но микросервизите — те са такива. Трябва да се има предвид. Получава се, че в момента подсистемата за събиране на логове е най-товарената в Lazada.
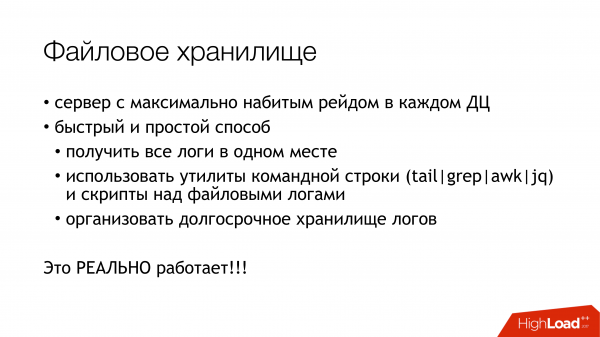
Как да решим проблема с elasticsearch? Ако трябва бързо да получите логовете на едно място, за да не тичате по всички машини и да ги събирате там, използвайте файлово хранилище. Това работи гарантирано. То се прави от всякакъв сървър. Просто трябва да навържете дискове там и да инсталирате syslog. След това ще имате гарантирано всички логове на едно място. После вече можете бавно да настройвате elasticsearch, graylog или нещо друго. Но вече ще имате всички логове, и, между другото, можете да ги съхранявате толкова дълго, колкото позволяват дисковите масиви.
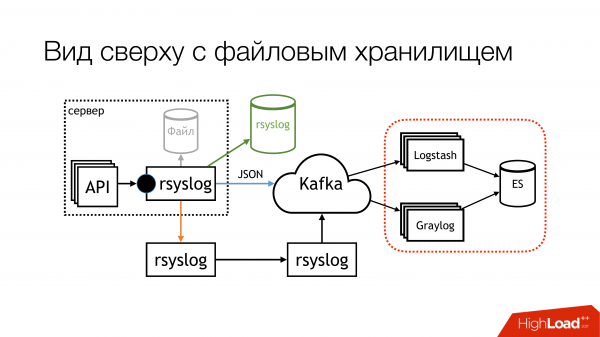
Към момента на моята презентация схемата изглеждаше така. Почти спряхме да пишем във файл. Сега, най-вероятно, ще изключим остатъците. На локалните машини, на които са стартирани API, спираме да пишем във файловете. Първо, има файлово хранилище, което работи много добре. Второ, на тези машини постоянно свършва мястото, трябва постоянно да го следим.
Тази част с Logstash и Graylog наистина е проблематична. Затова трябва да се отървем от нея. Трябва да изберем нещо едно.
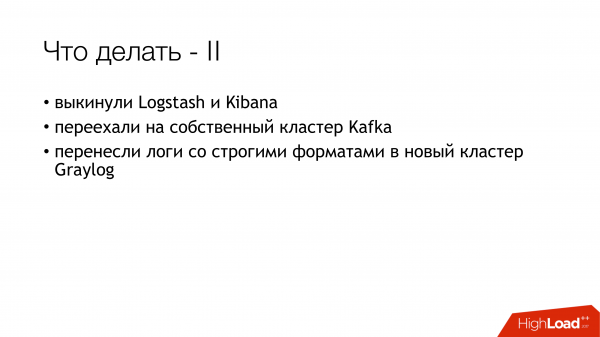
Решихме да изхвърлим Logstash и Kibana. Защото имаме отдел за сигурност. Каква е връзката? Връзката е, че Kibana без X-Pack и без Shield не позволява ограничаване на правата за достъп до логовете. Затова взехме Graylog. Не ми харесва, но работи. Купихме нов хардуер, инсталирахме нов Graylog и прехвърлихме всички логове с точни формати в отделен Graylog. Решихме проблема с различните типове идентични полета организационно.
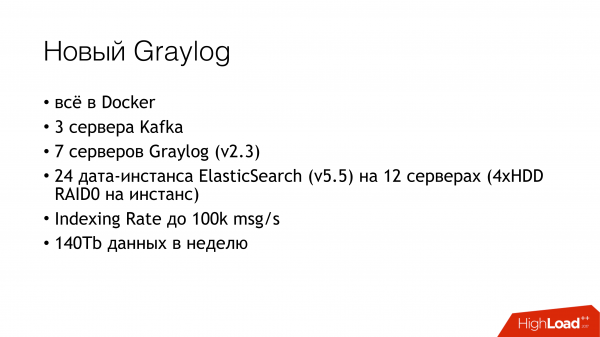
Какво всъщност влиза в новия Graylog? Просто записахме всичко в Docker. Взехме куп сървъри, разгръщахме три инстанса Kafka, 7 сървъра Graylog версия 2.3 (понеже искахме Elasticsearch версия 5). Всичко това е на рейдове от HDD. Видяхме процент на индексиране до 100 хиляди съобщения в секунда. Видяхме цифрата, че имаме 140 терабайта данни на седмица.
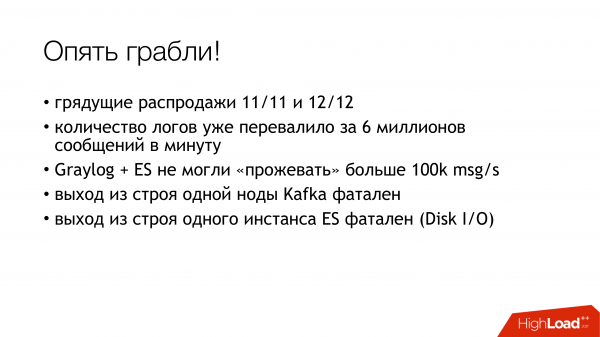
И отново пречките! Очакват ни два разпродажби. Преместихме се с 6 милиона съобщения. Нашият Graylog не успява да обработва навреме. Трябва отново да се справим.
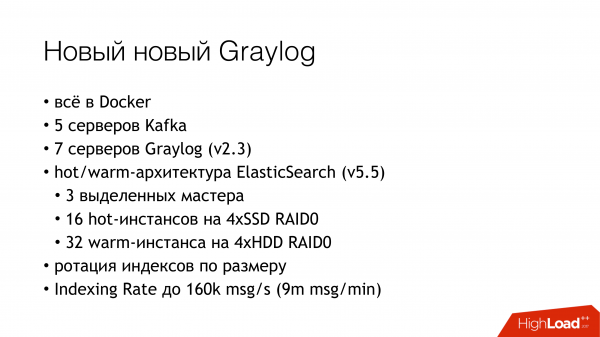
Справихме се по този начин. Добавихме още малко сървъри и SSD. В момента живеем по този начин. Сега обработваме вече 160 хиляди съобщения в секунда. Още не сме стигнали до лимита, така че все още не е ясно колко всъщност можем да извлечем от това.
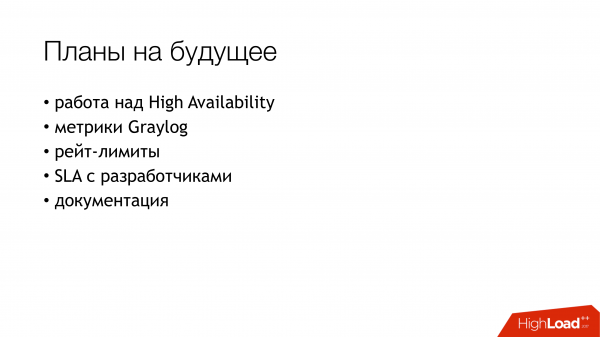
Това са нашите планове за бъдещето. От тях, наистина, най-важното е, вероятно, висока наличност. Все още нямаме такава. Няколко машини са настроени по един и същи начин, но все още всичко минава през една машина. Трябва да отделим време, за да настроим failover между тях.
Събиране на метрики от Graylog.
Да направим rate limit, за да не ни убива една луда API, която да унищожава нашата пропускателна способност и всичко останало.
И накрая, да подпишем някакво SLA с разработчиците, че можем да обслужим толкова много. Ако пишете повече, извинете.
И да напишем документация.
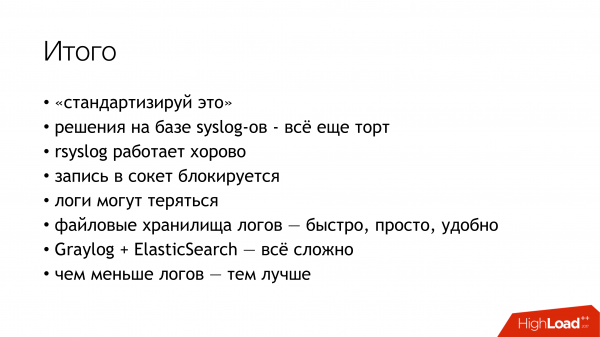
Накратко, резултатите от всичко, което преживяхме. На първо място, стандарти. На второ, syslog — торта. На трето, rsyslog работи така, както е написано на слайда. И да преминем към въпросите.
Въпроси.
Въпрос: Защо все пак решихте да не вземете… (filebeat?)
Отговор: Трябва да пишем в файл. Много не ми се искаше. Когато имаш API, което пише хиляди съобщения в секунда, дори да ротирате на всеки час, това все пак не е вариант. Може да пишете в pipe. На което разработчиците ме попитаха: „Какво ще стане, ако процесът, в който пишем, падне?“ Аз просто не намерих какво да им отговоря и казах: „Добре, да не го правим така“.
Въпрос: Защо не записвате логовете директно в HDFS?
Отговор: Това е следващият етап. Помислихме за него в самото начало, но тъй като в момента няма ресурси да се занимаваме с него, той остава като дългосрочно решение.
Въпрос: Колонният формат би бил по-подходящ.
Отговор: Разбирам всичко. Ние сме "за" с две ръце.
Въпрос: Пишете в rsyslog. Там може да бъде и TCP, и UDP. Но ако е UDP, как гарантирате доставката?
Отговор: Има два момента. Първо, веднага казвам на всички, че не гарантираме доставката на логовете. Защото, когато разработчиците дойдат и кажат: "А да започнем да записваме финансови данни там и вие да ги складите някъде, в случай че нещо се случи", им отговаряме "Отлично! Нека започнем да блокираме записването в сокет и да правим това в транзакции, за да можем гарантирано да получите информация в сокета и да се уверите, че ние сме я получили от другата страна." В този момент на всички им става ненужно. А щом е ненужно, какви въпроси имате към нас? Ако не искате да гарантирате записа в сокета, за какво ни е да гарантираме доставката? Правим най-доброто усилие. Наистина се стараем да доставим колкото се може повече и по-добре, но не даваме 100% гаранция. Затова не трябва да записвате финансови данни там. За това има бази данни с транзакции.
Въпрос: Когато API генерира съобщение в лог и предава управлението на микросервизите, случайно не сте се сблъсквали ли с проблема, че съобщенията от различни микросервизи идват в неправилен ред? Поради това възниква объркване.
Отговор: Нормално е да идват в различен ред. Трябва да се подготвите за това. Защото всяка мрежова доставка не гарантира реда, или трябва да похарчите специално ресурси за това. Ако вземем файловите хранилища, всяко API запазва логовете в своя файл. По-скоро rsyslog ги организира в каталози. Всяко API има свои логове, където можете да отидете и да видите, а след това по времеви марки в този лог можете да ги сопоставите. Ако те отидат да гледат в Graylog, там те ще бъдат сортирани по времеви марки. Всичко ще бъде наред.
Въпрос: Времевата марка може да се различава с милисекунди.
Отговор: Времевата марка се генерира от самото API. В това е всъщност цялата идея. Имаме NTP. API генерира времевата марка вече в самото съобщение. Тя не се добавя от rsyslog.
Въпрос: Не е съвсем ясно взаимодействието между датацентровете. Във рамките на датацентъра е ясно как се събират и обработват логовете. Как става взаимодействието между датацентровете? Или всеки датацентър живее собствен живот?
Отговор: Почти. Всяка страна е в един датацентър. Нямаме в момента разпределение, така че една страна да е разположена в различни датацентрове. Затова не е нужно да ги обединяваме. Вътре в всеки център има Log Relay. Това е Rsyslog сървър. Всъщност две управленски машини. Те са настроени еднакво. Но за момента трафикът минава през една от тях. Тя агрегира всички логове. Има дискова опашка за всеки случай. Тя компресира логовете и ги изпраща в централния датацентър (сингапурския), откъдето по-нататък се изпращат в Graylog. И в всеки датацентър има свое файлово хранилище. В случай, че загубим връзка, имаме всички логове там. Те ще останат там. Те ще бъдат запазени.
Въпрос: При нестандартни ситуации оттам ли получавате логовете?
Отговор: Може да отидете там (в файловото хранилище) и да проверите.
Въпрос: Как следите, че не губите логове?
Отговор: Всъщност ги губим и го мониторим. Мониторингът е стартиран преди месец. В библиотеката, която използва Go API, има метрики. Тя може да брои колко пъти не е могла да запише в сокета. В момента там има умна хевристика. Има буфер. Той се опитва да запише съобщението в сокета от него. Ако буферът прелее, започва да ги изпуска. И брои колко е изпуснал. Ако там започнат да преливат броячите, ние ще разберем. Те в момента идват и в Prometheus и в Grafana може да се видят графиките. Може да се настроят известия. Но все още не е ясно на кого да се изпращат.
Въпрос: В Elasticsearch съхранявате логовете с резервиране. Колко реплики имате?
Отговор: Една реплика.
Въпрос: Това всичко е само една реплика?
Отговор: Това е майстор и реплика. Данните се съхраняват в два екземпляра.
Въпрос: Размерът на буфера на rsyslog ли нагласихте по някакъв начин?
Отговор: Пишем дейтаграми в кастомния unix сокет. Това веднага налага ограничение от 128 килобайта. Не можем да запишем повече от това. Уговорили сме го в стандарта. Който иска да влезе в storage, трябва да пише 128 килобайта. Библиотеките също режат и слагат флаг, че съобщението е орязано. В нашия стандарт на съобщението има специално поле, което показва дали е било орязано при запис или не. Така имаме възможност да проследим и този момент.
Въпрос: Пишете ли повреждени JSON?
Отговор: Повреден JSON ще бъде отхвърлен или по време на relay, защото пакетът е твърде голям. Или ще бъде отхвърлен от Graylog, защото не може да парсне JSON. Но тук има нюанси, които трябва да се коригират, и те са до голяма степен свързани с rsyslog. Вече съм запълнил няколко issue, по които трябва да работим.
Въпрос: Защо Kafka? Пробвали ли сте RabbitMQ? Не работи ли Graylog при такива натоварвания?
Отговор: При нас с Graylog не става. А Graylog при нас се получава. С него наистина е трудно. Това е своеобразно нещо. Всъщност, не е необходимо. Предпочитам да пиша директно от rsyslog в elasticsearch и след това да гледам Kibana. Но трябва да уредим въпроса с безопасността. Това е възможен вариант за нашето развитие, когато изхвърлим Graylog и започнем да използваме Kibana. Няма смисъл да използваме Logstash. Защото мога всичко това да го направя с rsyslog. И той има модул за запис в elasticsearch. С Graylog се опитваме да живеем. Дори малко го настроихме. Но все още има пространство за подобрения.
За Кафка. Исторически сложилось так, что когда аз дойдох, тя вече беше налична и логовете вече се записваха. Просто разположихме нашия кластер и преместихме логовете в него. Ние го управляваме, знаем как се чувства. За RabbitMQ... нещата не сработват с RabbitMQ. Но RabbitMQ с нас сработва. Имаме го в продукция и имаше проблеми с него. Сега, преди разпродажбата, го поправихме и той започна да работи нормално. Но преди това не бях готов да го пусна в продукция. Има още един момент. Graylog може да чете версия AMQP 0.9, а rsyslog може да пише версия AMQP 1.0. И няма нито одно решение, което да може и двете. Има или едното, или другото. Затова в момента само Кафка. Но и там има свои нюанси. Защото omkafka на версията rsyslog, която използваме, може да загуби целия буфер от съобщения, които тя е извлекла от rsyslog. В момента сме принудени да се примирим с това.
Въпрос: Използвате Кафка, защото тя вече беше налична? Не се използва за други цели?
Отговор: Кафка, която имаме, се използва от екипа по данни. Това е съвсем отделен проект, за който, за съжаление, не мога да кажа нищо. Не съм в течение. Тя беше в ръцете на екипа по данни. Когато стартираха логовете, решиха да я използват, за да не се налага да инсталират и своя. Сега обновихме Graylog и загубихме съвместимост, защото там е стара версия на Кафка. Трябваше да създадем своя. Наред с това се избавихме от тези четири теми за всеки API. Направихме една широка тема за всичко live, една широка тема за всичко staging и просто всичко го пускаме там. Graylog всичко това паралелно извлича.
Въпрос: Каква е нуждата от това шаманство с сокетите? Опитвали ли сте да използвате log-драйвера syslog за контейнери?
Отговор: Когато се занимавахме с този въпрос, отношенията ни с Docker бяха напрегнати. Това беше Docker 1.0 или 0.9. Самият Docker беше странен. Второ, ако в него се вкарват и логове… Имам непотвърдено подозрение, че той пропуска всички логове през себе си, през демона на Docker. Ако едно API полудее, останалите API не могат да изпратят stdout и stderr. Не знам до къде ще доведе това. Имам предположение, че не трябва да използваме syslog драйвера на Docker на това място. Нашият отдел за функционално тестване има свой собствен малък клъстър Graylog с логове. Те използват лог драйвери на Docker и всичко там изглежда много добре. Но те веднага пишат GELF в Graylog. В момента, когато започвахме всичко това, просто искахме да работи. Може би по-късно, когато някой дойде и каже, че всичко работи нормално от сто години, ще опитаме.
Въпрос: Доставяте ли между датацентровете с rsyslog? Защо не с Kafka?
Отговор: Правим и двете всъщност. По две причини. Ако каналът е напълно убит, всичките ни логове дори в компресиран вид не преминават. А Kafka позволява просто да ги губим в процеса. Така се избавяме от залепването на тези логове. В такъв случай използваме Kafka директно. Ако каналът е добър и искаме да го освобождаваме, използваме rsyslog. Но в действителност може да бъде настроен така, че сам да дропва това, което не преминава. В момента просто където можем използваме доставка чрез rsyslog директно, а другаде Kafka.
Източник: habr.com
