

Павел Селиванов, архитект на решения Southbridge и преподавател в Слёрма, представи доклад на DevOpsConf 2019. Този доклад е част от една от темите на задълбочения курс по Kubernetes «Слёрм Мега».
провежда се в Москва от 18 до 20 ноември.
— Москва, от 22 до 24 ноември.
са винаги на разположение.
Под кат — транскрипция на доклада.
Добър ден, колеги и симпатизанти. Днес ще говоря за сигурността.
Виждам, че в залата днес има много специалисти по сигурност. Извинявам се предварително, ако термините от света на сигурността, които ще използвам, не са точно така, както е прието у вас.
Така се случи, че преди около половин година ми попадна един публичен кластер Kubernetes. Публичен — означава, че там има определен брой namespaces, а в тези неймспейсове има потребители, изолирани в своите namespaces. Всички тези потребители принадлежат на различни компании. И се предполага, че този кластер трябва да се използва като CDN. Тоест дават ви кластер, дават ви потребител, влизате в своя namespace и деплоите своите фронтове.
В предишната си компания опитаха да продадат такава услуга. И ме помолиха да тествам кластера, за да видя — подходящо ли е такова решение или не.
Влязох в този кластер. Получих ограничени права, ограничен namespace. Там хората знаеха какво е сигурност. Чели са какво е Role-based access control (RBAC) в Kubernetes — и го настроиха така, че не можех да стартирам подове независимо от деплойментите. Не помня задачата, която опитвах да реша, стартирайки под без деплоймент, но много исках да стартирам просто под. Реших за късмет да видя какви права имам в кластера, какво мога и какво не мога, какво са настроили. В същото време ще разкажа какво е неправилно настроено в тяхното RBAC.
Така се случи, че след две минути получих администраторски права в техния кластер, погледнах към всички съседни namespaces и видях там работещи продакшън фронтове на компании, които вече бяха закупили услугата и бяха деплойнирани. Едва се сдържах да не отида при някого на фронта и да не поставя някоя вулгарна дума на главната страница.
Ще разкажа с примери как го направих и как да се предпазим от това.
Но за да започна, ще се представя. Казвам се Павел Селиванов. Аз съм архитект на компанията Southbridge. Разбирам от Kubernetes, DevOps и всякакви модни неща. Ние с инженерите на Southbridge строим всичко това, а аз давам консултации.
Освен основната дейност, наскоро пуснахме проекти, наречени Слёрми. Опитваме се да внесем умението си да работим с Kubernetes в масите, обучавайки и други хора как да работят с К8с.
За какво ще говоря днес. Темата на доклада е ясна — за сигурността на клъстера Kubernetes. Но веднага искам да подчертая, че тази тема е много обширна — и затова искам веднага да уточня, за какво определено няма да говоря. Няма да обсъждам остарели термини, които вече са бисерути в интернет. Всякакви RBAC и сертификати.
Ще говоря за това, което мен и моите колеги тревожи относно сигурността на клъстера Kubernetes. Ние виждаме тези проблеми както при доставчиците, които предлагат клъстери Kubernetes, така и при клиентите, които идват при нас. Дори и при клиентите, които идват при нас от други консултантски администраторски компании. Тоест мащабът на трагедията е наистина огромен.
Само три точки, за които днес ще говоря:
- Права на потребителите vs права на подовете. Правата на потребителите и правата на подовете не са едно и също.
- Събиране на информация за клъстера. Ще покажа как може да се събира всякаква информация от клъстера, без да имате специални права в него.
- DoS-атака срещу клъстера. Ако не можем да съберем информация, можем да сринем клъстера в какъвто и да е случай. Ще говоря за DoS-атаките срещу управляващите елементи на клъстера.
Още нещо общо, което ще спомена — на какво съм тествавал всичко това, на какво мога да кажа, че всичко работи.
Вземаме за основа инсталацията на клъстер Kubernetes с помощта на Kubespray. Ако някой не знае, това е всъщност набор от роли за Ansible. Ние го използваме постоянно в работата си. Добро е, защото може да се приложи навсякъде — както на физически машини, така и в облака. Един метод на инсталация в принципе подхожда за всичко.
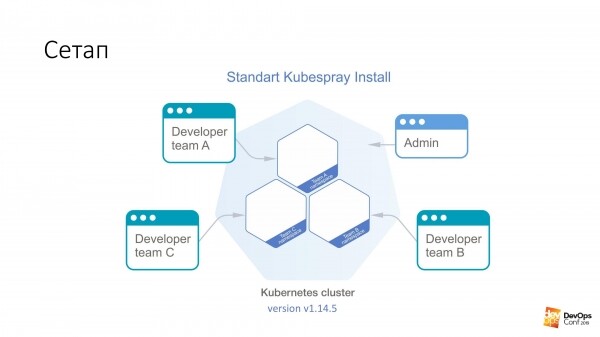
В този клъстер ще имам Kubernetes v1.14.5. Целият клъстер Куба, който ще разгледаме, е разделен на неймспейси, всеки неймспейс принадлежи на отделен екип, а членовете на този екип имат достъп до своя неймспейс. Не могат да влизат в различни неймспейси. Има обаче една администраторска сметка, която има права за целия клъстер.
Обещах, че първото, което ще направим, е да получим администраторски права за клъстера. Нуждаем се от специално подготвен pod, който ще разбие клъстера Kubernetes. Всичко, което трябва да направим, е да го приложим в клъстера Кубернетес.
kubectl apply -f pod.yamlТози pod ще стигне до един от майсторите на клъстера Kubernetes. И след това клъстерът радостно ще ни върне файл с име admin.conf. В Кубата в този файл са съхранени всички сертификати на администратора, а също така е настроен API на клъстера. Така просто можем да получим администраторски достъп, мисля, че до 98% от клъстерите Kubernetes.
Повтарям, този pod е направен от един разработчик във вашия клъстер, който има достъп да деплойва своите предложения в един малък неймспейс, всичко е задръстено с RBAC. Нямаше никакви права. Но въпреки това сертификатът се върна.
А сега за специално подготвения pod. Запускаме на какъвто и да е образ. За пример ще вземем debian:jessie.
Имаме следното:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Какво е toleration? Майсторите в клъстера Kubernetes обикновено са пометени с нещо, което се нарича taint (по английски "зараза"). И същността на тази "зараза" е, че не е позволено на pod-ове да се назначават на майсторски възли. Но никой не пречи в който и да е pod да посочи, че е толерантен към "зараза". Секцията Toleration точно казва, че ако на някой възел е зададен NoSchedule, то нашият pod е толерантен към такава зараза — и няма проблеми.
След това казваме, че нашият pod не е просто толерантен, но и иска специално да попада на майстора. Защото на майсторите се намира най-ценният ресурс, от който се нуждаем — всички сертификати. Затова казваме nodeSelector — и имаме стандартен етикет на майсторите, който позволява да изберем именно тези възли, които са майстори.
С тези две секции pod-ът със сигурност ще пристигне при майстора. И му ще бъде разрешено да живее там.
Но просто да пристигнем на майстора не е достатъчно. Това няма да ни помогне. Затова имаме още две неща:
hostNetwork: true
hostPID: true
Указваме, че нашият под, който стартираме, ще живее в namespace на ядрото, в network namespace и в PID namespace. След като подът стартира на мастера, ще може да вижда всички реални, активни интерфейси на този възел, да слуша целия трафик и да вижда PID на всичките процеси.
Следващата стъпка е малка. Вземате etcd и четете, каквото искате.
Най-интересното е, че тази възможност на Kubernetes е налична по подразбиране.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Същността е, че можем в пода, който стартираме, дори без права върху този кластер, да кажем, че искаме да създадем volume от тип hostPath. Тоест да вземем пътя от хоста, на който ще стартираме — и да го използваме като volume. И след това го наричаме name: host. Целият този hostPath монтираме вътре в пода. В този пример в директорията /host.
Още веднъж ще кажа. Казахме на пода да отиде на мастера, да получи hostNetwork и hostPID — и да монтира целия root на мастера вътре в този под.
Разбирате, че в Debian имаме стартиран bash, и този bash работи с права на root. Тоест току-що получихме root на мастера, без да имаме някакви права в кластера Kubernetes.
Следващата задача е да влезете в пода в директорията /host /etc/kubernetes/pki, ако не се лъжа, да вземете всички мастер сертификати на клъстера и съответно да станете администратор на клъстера.
Ако погледнете, това са едни от най-опасните права в подовете — независимо от правата на потребителя:
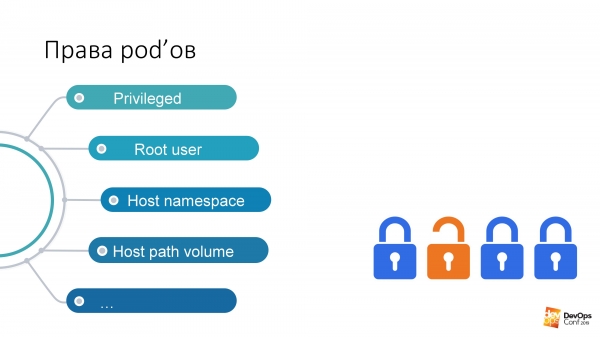
Ако имам права да стартирам под в някакъв namespace на клъстера, тези права важат по подразбиране за този под. Мога да стартирам привилегировани подове, а това е почти всичките права, практически root на възела.
Любимото ми е Root user. А Kubernetes има опция Run As Non-Root. Това е нещо като защита от хакери. Знаете ли какво е „молдавски вирус“? Ако случайно сте хакер и влезете в моя кластер Kubernetes, ние, бедните администратори, молим: „Моля, посочете в своите подове, с които ще хаквате моя кластер, run as non-root. Защото иначе можете да стартирате процес в своя под с права на root и много лесно ще ме хакнете. Моля, защитете се сами от себе си.“
Host path volume — на мен ми се струва, че е най-бързият начин да получите желания резултат от кластера Kubernetes.
Но какво да направим с всичко това?
Мисли, които трябва да идват на всеки нормален администратор, който се среща с Кубернетес: „Аха, казах ли, че Кубернетес не работи. Има дупки. И всичко е глупост.“ Всъщност, има нещо такова като документация, а ако погледнете там, ще видите раздел, .
Това е YAML обект — можем да го създаваме в Кубернетес кластера — който контролира аспектите на сигурността именно в описанието на подовете. Тоест, всъщност контролира правата за използване на hostNetwork, hostPID, определени типове volume, които съществуват в подовете по време на стартиране. С помощта на Политиката за сигурност на пода всичко това може да бъде описано.
Най-интересното в Политиката за сигурност на пода е, че в Кубернетес кластера, за всички инсталации на PSP не са просто описани, те са изключени по подразбиране. Политиката за сигурност на пода се включва с помощта на admission plugin.
Окей, ще внедрим Политиката за сигурност на пода в кластера, да кажем, че имаме служебни подове в неймспейса, до който имат достъп само администратори. Да кажем, в всички останали подове правата са ограничени. Защото вероятно разработчиците не се нуждаят от стартиране на привилегировани подове във вашия кластер.
И изглежда, че всичко е наред. И нашият Кубернетес кластер не може да бъде хакнат за две минути.
Има проблем. Вероятно, ако имате Кубернетес кластер, в него е инсталиран мониторинг. Дори бих предвидил, че ако в кластера ви има мониторинг, той се нарича Prometheus.
Това, което сега ще кажа, ще бъде валидно както за Prometheus оператора, така и за Prometheus, инсталиран в чист вид. Въпросът е, че ако не мога толкова бързо да получа администратор в кластера, то това означава, че трябва да търся повече. А мога да търся с помощта на вашия мониторинг.
Вероятно всички са чели едни и същи статии в Хабър, а мониторингът се намира в неймспейс monitoring. Helm chart-овете на всички се наричат горе-долу еднакво. Предполагам, че ако направите helm install stable/prometheus, ще получите горе-долу еднакви имена. И дори вероятно няма да се наложи да отгатвам DNS името в кластера ви. Защото е стандартно.
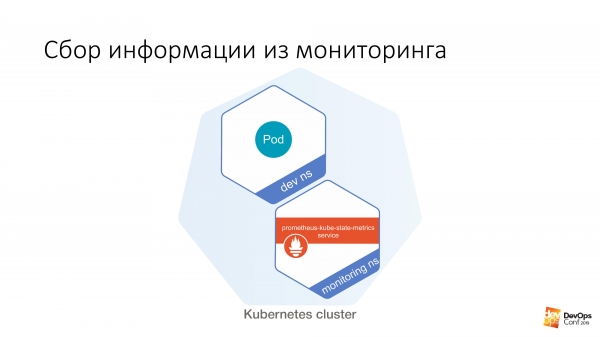
След това имаме некакъв dev ns, в който може да се стартира некакъв под. И след това от този под е много лесно да се направи така:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics е един от експортерите на Prometheus, който събира метрики от API-то на самия Kubernetes. Има много данни за това какво е активно във вашия клъстер, какво е то и какви проблеми имате с него.
Като прост пример:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Изпълнявайки прост CURL запитване от непривилегирован контейнер, можете да получите такава информация. Ако не знаете в коя версия на Kubernetes работите, той лесно ще ви каже.
А най-интересното е, че освен да се обръщате към kube-state-metrics, можете с еднакъв успех да се свържете и директно с Prometheus. Можете да събирате метрики от там. Всъщност можете да изградите метрики от там. Дори теоретично можете да направите такова запитване от клъстера към Prometheus, което просто да го изключи. И вашият мониторинг напълно ще спре да функционира.
И тук вече възниква въпросът, дали някакъв външен мониторинг следи вашия мониторинг. Току що получих възможността да действам в клъстера на Kubernetes без никакви последици за себе си. Дори няма да разберете, че действам там, тъй като мониторинг вече няма.
Също както с PSP, остава впечатлението, че проблемът е в това, че всички тези модни технологии — Kubernetes, Prometheus — просто не работят и са пълни с дупки. Всъщност не е така.
Има такава неща — .
Ако сте нормален администратор, вероятно знаете, че Network Policy е поредният yaml, които в клъстера вече има достатъчно. И Network Policies определено не са нужни. А дори и да сте чели какво е Network Policy, че е yaml-файервол на Kubernetes, който позволява да се ограничават правата на достъп между неймспейсите, между контейнерите, то със сигурност сте решили, че файервол в yaml формат в Kubernetes е поредната абстракция… Не, не. Това определено не е нужно.
Дори ако вашите специалисти по сигурност не са знаели, че с помощта на вашия Кубернетес можете много лесно да изградите защитна стена, която е много детайлна. Ако те все още не знаят това и не ви притискат: „Дайте, дайте…“ То в какъвто и случай Network Policy ви е необходима, за да ограничите достъпа до някои служебни места, до които може да се стигне от вашия клъстер без никаква авторизация.
Както в примера, който посочих, можете да получите kube state metrics от всяко пространство от имена в Кубернетес клъстера, без да имате никакви права. Политиките за мрежата затвориха достъпа от всички други пространства от имена до пространството от имена за мониторинг и, по принцип, това е всичко: няма достъп, няма проблеми. Във всичките графици, които съществуват, както и в стандартния Prometheus, така и в Prometheus, който се намира в оператора, просто в values на Helm има опция просто да активирате политики за мрежата за тях. Нужно е просто да се включи и те ще работят.
Наистина, има една проблематика тук. Будейки нормален бородат администратор, вие вероятно сте решили, че политиките за мрежата не са необходими. И след като прочетете различни статии на ресурси като Хабра, сте решили, че flannel, особено с режим на host-gateway, е най-доброто, което можете да изберете.
Какво да правим?
Можете да опитате да преинсталирате мрежовото решение, което имате в клъстера Кубернетес, и да опитате да го замените с нещо по-функционално. Например с Calico. Но веднага искам да кажа, че задачата да смените мрежовото решение в работещ клъстер Кубернетес е доста нетривиална. Решавал съм я два пъти (и двата пъти, впрочем, теоретично), но дори на събития като Слърм показвахме как да го направите. За нашите обучаеми показвахме как да сменят мрежовото решение в клъстера Кубернетес. По принцип можете да опитате да го направите така, че в продукционния клъстер да няма прекъсване на услугата. Но вероятно няма да успеете.
И наистина, проблемът се решава много просто. В клъстера има сертификати и знаете, че сертификатите ви след година ще изтекат. Обикновено нормалното решение със сертификатите в клъстера е: какво да се притесняваме, просто ще вдигнем нов клъстер, в стария нека да изтече и всичко ще пренастроим. Въпреки че, когато той изтече, ще стои един ден, но затова ще имаме новите клъстър.
Когато вдигате новия клъстер, заедно вставете Calico вместо flannel.
Какво да направите, ако вашите сертификати са издадени за сто години и не планирате да преработвате клъстера? Има нещо, наречено Kube-RBAC-Proxy. Това е много полезно приложение, което позволява да се вградите като sidecar контейнер в който и да е под в клъстера Kubernetes. То всъщност добавя авторизация чрез RBAC на самия Kubernetes към този под.
Има един проблем. По-рано това решение Kube-RBAC-Proxy беше вградено в Prometheus оператора. Но след това изчезна. Сега съвременните версии разчитат на това, че имате network policy и ги използвате за затваряне на достъпа. И затова ще трябва да пренапишете малко чартовете. Всъщност, ако влезете в , там ще намерите примери как да го използвате като sidecars, и чартовете ще трябва да бъдат пренаписани минимално.
Има и още един малък проблем. Не само Prometheus предоставя своите метрики на всеки. Всички компоненти на клъстера Kubernetes също могат да предоставят своите метрики.
Но както споменах, ако нямате достъп до клъстера и не можете да съберете информация, поне можете да навредите.
Така че бързо ще покажа два начина, как можете да повредите здравето на Kubernetes клъстера.
Ще се смеете, когато ви го разкажа, това са два случая от реалния живот.
Първият метод. Изчерпване на ресурсите.
Стартираме още един специален под. Той ще има следната секция.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Както знаете, requests — това е количеството CPU и памет, което се резервира на хоста за конкретни подове с requests. Ако имаме четириядрен хост в клъстера Kubernetes и под с requests четири CPU, то значи, че повече нито един под с requests няма да може да се инсталира на този хост.
Ако стартирам такъв под, след това ще изпълня командата:
$ kubectl scale special-pod --replicas=...То никой повече няма да може да се инсталира в клъстера Kubernetes. Защото на всички нодове ще свършат requests. И така ще спра вашия клъстер Kubernetes. Ако направя това вечер, разпределенията могат да бъдат спрени за доста дълго време.
Ако отново погледнем документацията на Kubernetes, ще видим нещо, наречено Limit Range. То установява ресурси за обекти в кластера. Можете да напишете YAML обект Limit Range, да го приложите в определени имена пространства – и след това в това име пространство можете да зададете, че имате за подовете ресурсите по подразбиране, максимални и минимални.
С помощта на това можем да ограничим потребителите в конкретни продуктов имена пространства в възможностите им да посочват всякакви нежелани подове. Но за съжаление, дори ако кажете на потребителя, че не може да стартира подове с заявки над едно ЦПУ, има такава чудесна команда scale, или през таблото те могат да правят scale.
И оттук произтича вторият начин. Стартираме 11 111 111 111 111 пода. Това са единадесет милиарда. Не е, защото съм измислил такова число, а защото сам го видях.
Истинска история. Късно вечерта бях готов да напусна офиса. Гледам, в ъгъла седи група разработчици и правят нещо трескаво с лаптопите. Приближих се до тях и питам: „Какво се е случило?“
Малко по-рано, около девет часа вечерта, един от разработчиците се готвел да си отиде. И решил: „Аз сега ще скалирам приложението си до единичка“. Натиснал единичката, а интернетът малко забавил. Той натиснал отново на единичката, натиснал я, кликнал Enter. Натискаше всичко, което можа. Тук интернетът оживя – и всичко започна да се скалира до това число.
Истината е, че тази история не се случи на Kubernetes, по онова време беше Nomad. Завърши с това, че след час опити да спрем Nomad от постоянните му опити да се скалира, Nomad отговори, че няма да спре да се скалира и няма да прави нищо друго. „Уморих се, напускам“. И се закри.
Аз естествено опитах да направя същото на Kubernetes. Единадесет милиарда пода не радваха Кубернетес, той каза: „Не мога. Превишава вътрешните лимити“. Но 1 000 000 000 пода успя.
В отговор на един милиард Варианта, Куб тайно се разви. Процесът на скалиране стана все по-задълбочен, с увеличаване на времето, необходимо за създаване на нови подове. Но процесът все пак напредваше. Единствената трудност беше, че при неограничен достъп до създаване на подове в собственото място, дори без изисквания и лимити, можех да пусна такова количество подове, че нодовете да започнат да се затрудняват с паметта и ЦПУ. Когато стартирам толкова много подове, информацията от тях трябва да постъпи в хранилището, т.е. etcd. Но когато там навлезе твърде много информация, хранилището започва да реагира прекалено бавно — и Кубернетес започва да показва затруднения.
Но има и още един проблем… Както знаете, управляващите елементи на Кубернетес не са просто един централен компонент, а множество. Има контролер мениджър, планиращ (scheduler) и така нататък. Всички тези елементи няма да спрат да извършват ненужна и неефективна работа, която с времето ще отнема все повече и повече време. Контролер мениджърът ще създава нови подове. Планиращият ще се опитва да им намери нова нода. Новите нодовете в клъстера ви, най-вероятно, скоро ще свършат. Клъстерът Кубернетес ще започне да работи все по-бавно.
Но реших да отида още по-далеч. Както знаете, в Кубернетес има функция, наречена сервиз. Е, по подразбиране, в клъстерите ви вероятно сервизът работи с IP таблици.
Ако стартирате един милиард подове, например, и след това с помощта на скрипт накарате Кубернетес да създаде нови сервизи:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
На всички нодовете в клъстера приблизително одновременно ще се генерират все нови и нови правила iptables. А за всеки сервиз ще бъдат генерирани по един милиард правила iptables.
Проверявах всичко това на няколко хиляди, до десет. И проблемът е, че вече на този етап свързването по ssh към нода е доста проблематично. Защото пакетите, преминавайки през такова количество вериги, започват да не се справят добре.
И това също се решава с помощта на Kubernetes. Съществува такъв обект, наречен ресурсна квота. Тя определя количеството достъпни ресурси и обекти за namespace в клъстера. Можем да създадем YAML обект във всеки namespace на Kubernetes клъстера. Чрез този обект можем да кажем, че за този namespace е определено определено количество заявки и лимити, а след това можем да заявим, че в този namespace е възможно да се създадат 10 услуги и 10 пода. И разработчикът може да се чувства свободен да експериментира вечер. Kubernetes ще му каже: „Не можете да мащабирате вашите подове до такова количество, защото надвишава ресурсната квота.“ Проблемът е решен. .
Един проблемен момент свързан с това възниква. Чувствате как става сложно да създадете namespace в Kubernetes. За да го създадете, трябва да вземете предвид много неща.
Resource quota + Limit Range + RBAC
• Създаваме namespace
• Създаваме limitrange вътре
• Създаваме resourcequota вътре
• Създаваме serviceaccount за CI
• Създаваме rolebinding за CI и потребители
• По желание стартираме нужните служебни подове
Затова, ползвайки случая, бих искал да споделя своите разработки. Има такова нещо, наречено оператор SDK. Това е начин в клъстера Kubernetes да пишете оператори. Можете да пишете оператори с Ansible.
Първоначално написахме с Ansible, а след това видях, че има оператор SDK и пренаписах ролята на Ansible в оператор. Този оператор позволява да се създаде в клъстера Kubernetes обект, наречен команда. Вътре в командата той позволява да опишете в YAML среда за тази команда. И в средата на командата позволява да опишете, че предоставяме толкова и толкова ресурси.
Малък .
И за заключение. Какво да правим с всичко това?
Първо. Pod Security Policy е добре. И въпреки че нито един от инсталаторите на Kubernetes все още не ги използва, все пак трябва да ги приложите в вашите клъстери.
Network Policy не е просто още едно ненужно нещо. Това е нещо, което наистина е необходимо в клъстера.
LimitRange/ResourceQuota - време е да ги използвате. Вече отдавна започнахме да ги използваме, и дълго време бях убеден, че всички това правят. Оказа се, че е рядкост.
Освен това, което споменах в доклада, има неописани функции, които позволяват атака на клъстера. Наскоро излезе .
Някои неща са толкова тъжни и разочароващи. Както например, при определени условия, kubelet-ите в клъстера Kubernetes могат да предоставят съдържанието на директорията warlocks на неупълномощен потребител.
има инструкции как да възпроизведете всичко, за което говорих. Там има файлове с примери от продукционната среда, как изглеждат ResourceQuota и Pod Security Policy. И всичко това може да бъде изпробвано.
На всички благодаря.
Източник: habr.com
