

Здравей, Хабр!
След новогодишните празници, ние повторно стартирахме катастрофоустойчиво облако базирано на две площадки. Днес ще разкажем как е устроено и ще покажем какво се случва с клиентските виртуални машини при отказ на отделни елементи от клъстера и падане на цяла площадка (спойлер – с тях всичко е наред).
СХД на катастрофоустойчивото облако на площадката OST.
Какво има вътре
Под капака на клъстера са сървърите Cisco UCS с хипервизор VMware ESXi, две СХД INFINIDAT InfiniBox F2240, мрежово оборудване Cisco Nexus, както и SAN превключватели Brocade. Клъстерът е разположен на две площадки – OST и NORD, т.е. във всеки дата център има идентичен набор от оборудване. Именно това го прави катастрофоустойчив.
В рамките на една площадка основните елементи също са дублирани (хостове, SAN превключватели, мрежа).
Двете площадки са свързани с отделни оптични трасета, които също са резервирани.
Няколко думи за СХД. Първоначалният вариант на катастрофоустойчивото облако изградихме на NetApp. Тук избрахме INFINIDAT, и ето защо:
- Опцията Active-Active репликация. Тя позволява на виртуалната машина да остане в работоспособно състояние дори при пълен отказ на едната СХД. За репликацията ще говоря по-подробно по-късно.
- Три дискови контролера за повишаване на отказоустойчивостта на системата. Обикновено ги има само два.
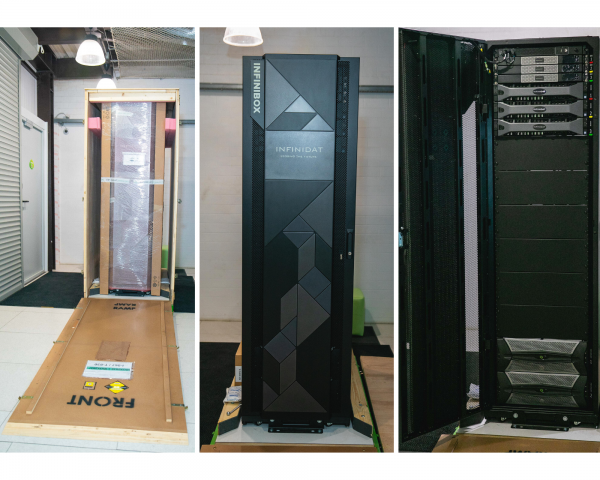
- Готово решение. При нас дойде вече сглобен стелаж, който единствено трябва да се свърже към мрежата и да се настрои.
- Внимателна техническа поддръжка. Инженерите на INFINIDAT постоянно анализират логовете и събитията на СХД, инсталират нови версии в фърмуера, помагат с настройките.
Ето малко снимки от разопаковането:
Как работи
Облако вече е отказоустойчиво вътре в себе си. То защитава клиента от единични хардуерни и софтуерни откази. Катастрофоустойчиво обаче ще помогне да се защити от масови сблъсъци в рамките на една площадка: например, отказ на СХД (или на клъстера SDS, което често се случва 🙂 ), масови грешки в мрежата за съхранение и останалото. И най-важното: такова облако спасява, когато цялата площадка стане недостъпна поради пожар, блек-аут, рейдерски захват или нападение от извънземни.
Във всички тези случаи клиентските виртуални машини продължават да работят, и ето защо.
Кластерната схема е изградена така, че всеки ESXi хост с клиентски виртуални машини може да се свързва към всяка от двете СХД. Ако СХД на площадката OST спре да функционира, виртуалните машини ще продължат да работят: хостовете, на които работят, ще получават данни от СХД на NORD.
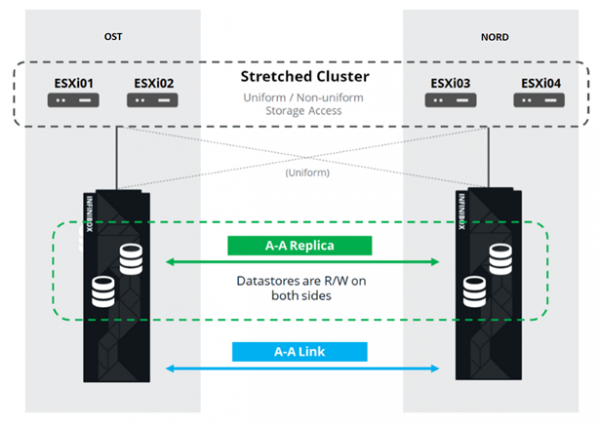
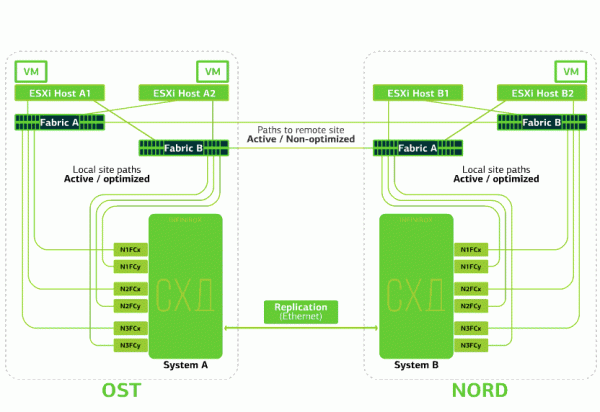
Така изглежда схемата на връзката в клъстера.
Това е възможно благодарение на факта, че между SAN фабриките на двете площадки е настроен Inter-Switch Link: SAN суич Fabric A OST е свързан с SAN суич Fabric A NORD, по аналогичен начин и за SAN суичовете Fabric B.
И за да имат смисъл всички тези сложни връзки на SAN фабриките, между двете СХД е настроена Active-Active репликация: информацията практически едновременно се записва на локалната и отдалечената СХД, RPO=0. Получава се, че на една СХД се съхранява оригиналът на данните, а на другата – техния реплика. Данните се репликират на нивото на томовете на СХД, а на тях се съхраняват данните на ВМ (нейните дискове, конфигурационен файл, swap файл и др.).
ESXi хостът вижда основния том и неговата реплика като едно дисково устройство (Storage Device). От ESXi хоста към всяко дисково устройство има 24 пътя:
12 пътя свързват хоста с локалната СХД (оптимални пътища), а останалите 12 – с отдалечената (неоптимални пътища). В нормална ситуация ESXi се свързва с данните на локалната СХД, използвайки "оптималните" пътища. При повреда на тази СХД, ESXi изгубва оптималните пътища и преминава на "неоптималните". Ето как изглежда това на схемата.
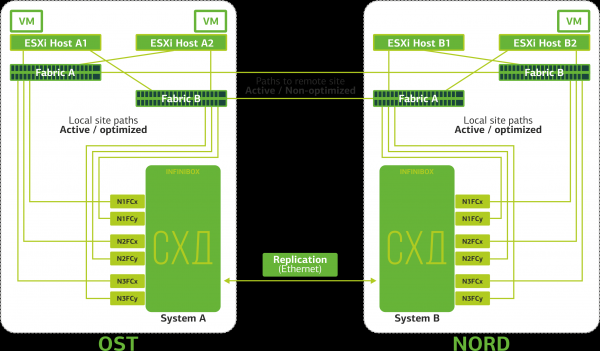
Схема на катастрофоустойчивия клъстер.
Всички клиентски мрежи са свързани на двете площадки чрез обща мрежова фабрика. На всяка площадка работи Provider Edge (PE), на който се терминат мрежите на клиента. PE са обединени в общ клъстер. При отказ на PE на една площадка, целият трафик се пренасочва към втората площадка. Благодарение на това виртуалните машини от площадката, останала без PE, остават достъпни по мрежата за клиента.
Сега нека да видим какво ще се случи с виртуалните машини на клиента при различни откази. Започваме с най-леките случаи и завършваме с най-сериозния – отказа на цялата площадка. В примерите основната площадка ще бъде OST, а резервната с реплики на данните – NORD.
Какво се случва с виртуалната машина на клиента, ако...
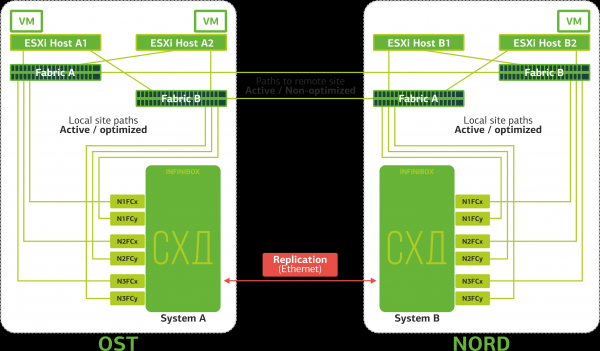
Откачи Replication Link. Репликацията между СХД на двете площадки спира.
ESXi ще работят само с локални дискови устройства (по оптимални пътища).
Виртуалните машини продължават да работят.
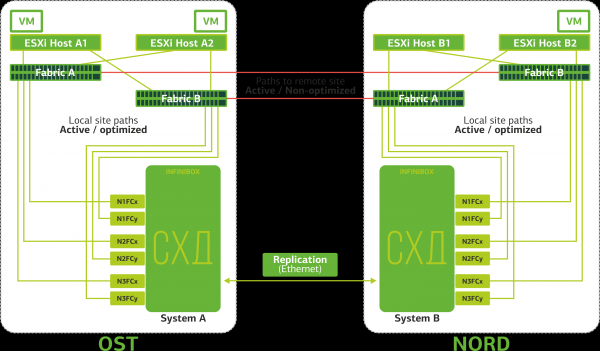
Произвежда се прекъсване на ISL (Inter-Switch Link). Случаят е малко вероятен. Освен ако някой луд багер не разкопае веднага няколко оптични трасета, които минават по независими маршрути и са заведени на площадките през различни входове. Но все пак. В този случай ESXi хостовете губят половината от пътищата и могат да получават достъп само до своите локални СХД. Репликите се събират, но хостовете не могат да ги достъпи.
Виртуалните машини работят нормално.
Отказва SAN превключвателя на една от площадките. ESXi хостовете губят част от пътищата към СХД. В този случай хостовете на площадката, където отказа превключвателят, ще работят само през един свой HBA.
Виртуалните машини продължават да работят нормално.
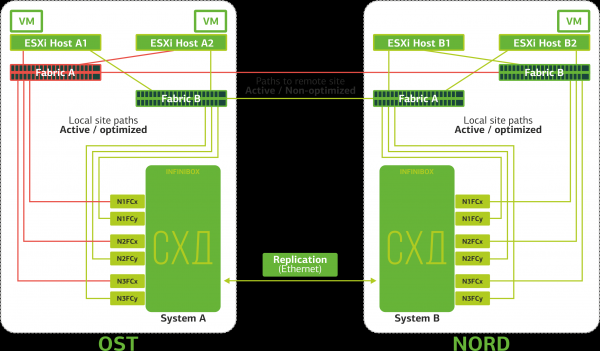
Отказват всички SAN превключватели на една от площадките. Да предположим, че такава беда се е случила на площадката OST. В този случай ESXi хостовете на тази площадка ще загубят всички пътища към своите дискови устройства. Включва се стандартният механизъм VMware vSphere HA: той ще рестартира всички виртуални машини на площадката OST в NORD`е максимум след 140 секунди.
Виртуалните машини, работещи на хостовете на площадката NORD, работят нормално.
Отказва ESXi хост на една площадка. Тук отново работи механизма vSphere HA: виртуалните машини от неработещия хост се рестартират на други хостове – на същата или на отдалечена площадка. Времето за рестарт на виртуалната машина – до 1 минута.
Ако отказват всички ESXi хостове на площадката OST, вече няма опции: ВМ се рестартират на друга. Времето за рестарт е същото.
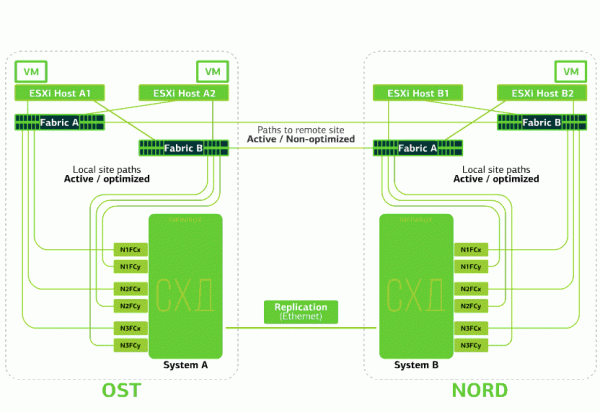
Отказва СХД на една площадка. Да предположим, че СХД на площадката OST е отказала. Тогава ESXi хостовете на площадката OST превключват на работа с реплики на СХД в NORD’e. След възстановяване на неработещата СХД, ще се извърши задължителна репликация, а ESXi хостовете OST отново ще започнат да получават достъп до локалната СХД.
Виртуалните машини по това време работят нормално.
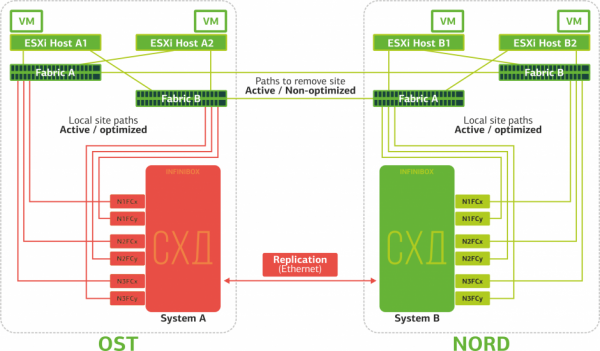
Отказва една от площадките. В този случай всички виртуални машини ще бъдат рестартирани на резервната площадка чрез механизма vSphere HA. Времето за рестарт на ВМ – 140 секунди. При това всички мрежови настройки на виртуалната машина ще бъдат запазени и тя остава достъпна за клиента по мрежата.
За да се осигури безпроблемното рестартиране на машините на резервната площадка, всяка площадка е запълнена само наполовина. Втората половина е резерв за случай на преместване на всичките виртуални машини от втората, пострадала площадка.
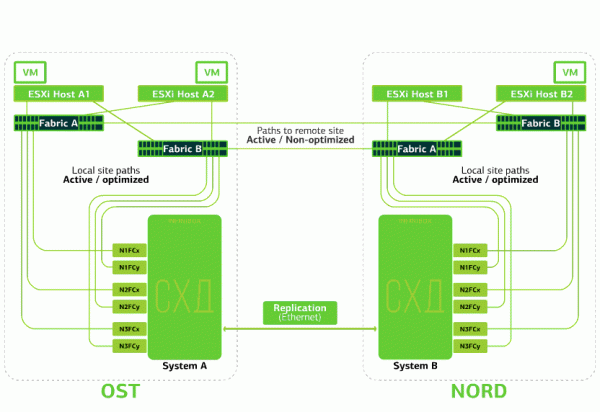
Точно от такива откази защитава катастрофоустойчивото облако, базирано на два дата центъра.
Това удоволствие не е евтино, тъй като в допълнение към основните ресурси, се нуждаете от резерв на втората площадка. Затова в такова облако се разполагат бизнес-критични услуги, чийто дълъг престой носи големи финансови и репутационни загуби, или ако системата за информацията е обект на изисквания за катастрофоустойчивост от регулатори или вътрешни правила на компанията.
Източници:
Източник: habr.com
