

Тази статия е написана, за да помогне при избора на подходящото решение и да обясни разликите между SDS решения като Gluster, Ceph и Vstorage (Virtuozzo).
В текста се използват линкове към статии с по-подробно разглеждане на различни проблеми, затова описанията ще бъдат максимално кратки, използвайки ключови моменти без излишна информация, която можете да намерите сами в интернет.
Назависимо от факта, че засегнатите теми изискват определен тон на текста, в съвременния свят все повече хора не обичат да четат дълго))), затова може да се прочете накратко и да се направи избор, а ако нещо е неясно, можете да преминете по линковете или да потърсите непознатите думи))), а тази статия е като прозрачна обвивка за тези дълбоки теми, показваща същността – основните ключови моменти на всяко решение.
Gluster
Започваме с Gluster, който активно се използва от производители на хиперконвергентни платформи с SDS на базата на open source за виртуални среди и можете да го намерите на сайта на RedHat в секцията за съхранение, където се предлага избор между два варианта на SDS: Gluster или Ceph.
Gluster се състои от стек от транслятори – услуги, които извършват всички операции по разпределение на файлове и т.н. Brick – услуга, която обслужва един диск, Volume – том(пул) – който обединява тези brick’и. Следва услуга за разпределение на файлове по групи с помощта на функцията DHT (разпределена хеш таблица). Услугата Sharding няма да бъде включена в описанието, тъй като по-долу ще има линкове за описание на проблемите, свързани с нея.
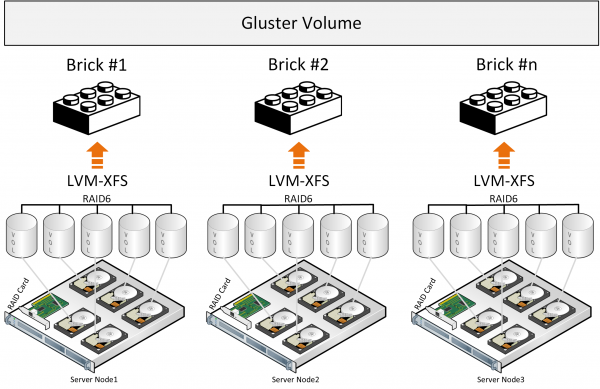
При запис, файлът се записва изцяло в brick и неговата копия паралелно се записва на brick на втория сървър. След това вторият файл ще се записва в друга група от два brick(или повече) на различни сървъри.
Ако файловете са приблизително с еднакъв размер и томът ще се състои само от една група, всичко е наред, но при други условия възникват следните проблеми от описанията:
- местата в групите се използват неравномерно, което зависи от размерите на файловете и ако в групата няма достатъчно място за запис на файл — ще получите грешка, файлът няма да бъде записан и няма да бъде преразпределен в друга група;
- при запис на един файл IO се извършва само в една група, а другите стоят без работа;
- не можете да получите IO за целия том при запис на един файл;
- и общата концепция изглежда по-малко производителна поради липсата на разпределение на данните по блокове, където е по-лесно да се направи балансировка и да се реши проблема с равномерното разпределение, а не както сега файлът легне в брик изцяло.
От официалното описание също така непроизволно идва разбирането, че gluster работи като файлово хранилище над класическия хардуерен RAID. Бяха направени опити за разработка на нарязване (Sharding) на файлове на блокове, но всичко това е допълнение, което налага загуби на производителност към вече съществуващия архитектурен подход, плюс използването на такива свободно разпространявани компоненти с ограничения в производителността като Fuse. Няма услуги за метаданни, което ограничава възможностите за производителност и отказоустойчивост на хранилището при разпределение на файлове на блокове. По-добри показатели за производителност могат да се наблюдават при конфигурация “Distributed Replicated” и броят на нодовете трябва да бъде не по-малко от 6 за организиране на надеждна реплика 3 с оптимално разпределение на натоварването.
Тези изводи също са свързани с описанието на опит за използване и при сравнение с , както и има описание на опита за достигане на разбирането за тази по-производителна и по-надеждна конфигурация
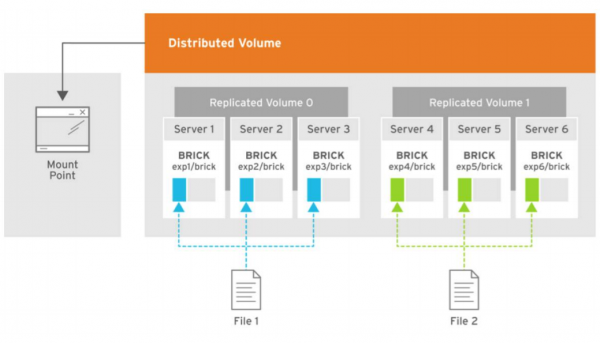
На картинката е показано разпределението на натоварването при запис на два файла, където копията на първия файл се разпределят по трите първи сървъра, които са обединени в група volume 0, а три копия на втория файл лежат на втората група volume1 от три сървъра. Всеки сървър има един диск.
Общото заключение е, че Gluster може да се използва, но с разбирането, че ще има ограничения в производителността и отказоустойчивостта, които създават трудности при определени условия на хиперконвергентно решение, където ресурсите са необходими и за изчислителни натоварвания на виртуалните среди.
Има някои показатели за производителност на Gluster, които могат да бъдат постигнати при определени условия, ограничени в
Ceph
Сега ще разгледаме Ceph от описанията на архитектури, които успях да Също така има сравнение между , където може веднага да се разбере, че Ceph е желателно да се разгърне на отделни сървъри, тъй като на неговите услуги са необходими всички ресурси на хардуера при натоварвания.
Архитектура по-сложен от Gluster и има услуги като служби за метаданни, но целият стек от компоненти е доста сложен и не много гъвкав за използване в решения за виртуализация. Данните се организират на блокове, което изглежда по-производително, но в йерархията на всички служби (компоненти) се появяват загуби и латентност при определени натоварвания и аварийни условия, например следното
От описанието на архитектурата, основата е CRUSH, благодарение на който се избира мястото за съхранение на данни. Следва PG — това е най-сложната абстракция (логическа група) за разбиране. PG са необходими, за да е CRUSH по-ефективен. Основната цел на PG е групирането на обекти за намаляване на ресурсното потребление, повишаване на производителността и мащабируемостта. Адресирането на обекти директно, поотделно, без обединяване в PG би било много разходно. OSD – това е услуга за всеки отделен диск.
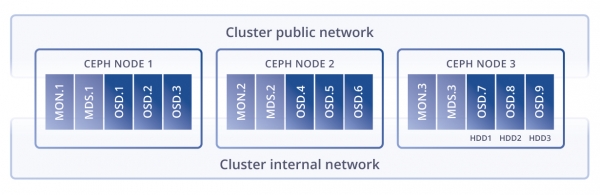
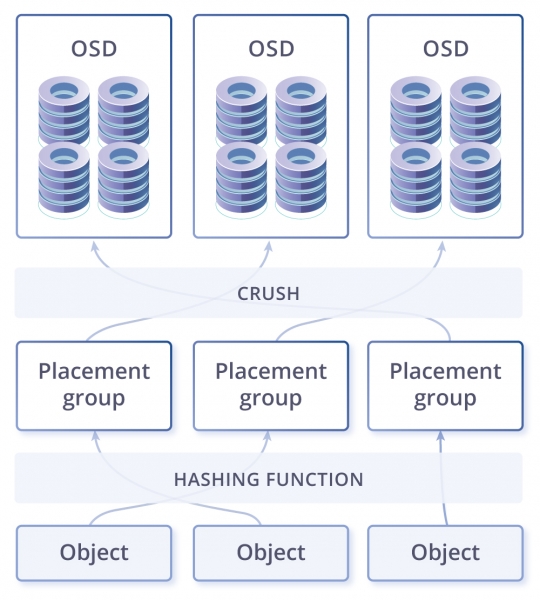
Клъстерът може да има един или много пулове с данни с различна цел и с различни настройки. Пуловете се делят на плейсмент-групи. В плейсмент-групите се съхраняват обекти, до които клиентите имат достъп. На този логически слой всичко свършва и започва физическият, тъй като на всяка плейсмент-група е назначен един главен диск и няколко диска-реплики (колко точно зависи от фактора на репликация на пула). С други думи, на логическия слой обектът се съхранява в конкретна плейсмент-група, а на физическия — на дисковете, които са прикрепени към нея. В същото време дисковете физически могат да се намират на различни възли или дори в различни датацентрове.
В тази схема групите за разпределение изглеждат като необходим слой за гъвкавост на цялото решение, но също така и като ненужен елемент в тази верига, което неволно навежда на мисли за загуба на производителност. Например, при запис на данни системата трябва да ги раздели на тези групи и след това да ги запише на физическо ниво на основния диск и на дисковете за реплики. Тоест, хеш функцията работи при търсене и добавяне на обект, но има страничен ефект – това са много големи разходи и ограничения при пренастройване на хеша (при добавяне или премахване на диск). Още един проблем с хеша е ясно фиксираното местоположение на данните, които не могат да се променят. Тоест, ако по някакъв начин дискът изпитва повишен натиск, системата няма възможност да не записва на него (избирайки друг диск), хеш функцията задължава данните да се разполагат по правило, независимо от това колко зле е на диска. Затова Ceph изразходва много памет при пренастройване на PG в случай на самовъзстановяване или увеличаване на хранилището. Изводът е, че Ceph работи добре (макар и бавно), но само когато няма мащабиране, аварийни ситуации и актуализации.
Съществуват, разбира се, варианти за повишаване на производителността чрез кеширане и кеш-тиране, но за целта се изисква добро оборудване и все пак ще има загуби. Въпреки това, Ceph изглежда по-привлекателно от Gluster за производствени среди. Също така, при използването на тези продукти е необходимо да се вземе предвид важен фактор – високото ниво на компетенции, опит и професионализъм с акцент върху Linux, тъй като е изключително важно всичко да бъде правилно разположено, конфигурирано и поддържано, което поставя още повече отговорност и натоварване върху администратора.
Vstorage
Още по-интересна изглежда архитектурата на , която може да се използва съвместно с хипервизора на същите възли, на същото , но е много важно всичко да бъде правилно конфигурирано, за да се постигне добра производителност. Тоест, разгръщайки такъв продукт направо от кутията на произволна конфигурация без да се вземат предвид препоръките съгласно архитектурата, ще бъде много лесно, но не производително.
Какво може да съществува до услугите на хипервизора kvm-qemu? Става дума само за няколко услуги, където е намерена компактна оптимална йерархия от компоненти: клиентският сервис, монтиран чрез FUSE (модифициран, не open source), услуга за метаданни MDS (Metadata service), услуга за блокове данни Chunk service, която на физическо ниво е равна на един диск и това е всичко. По отношение на скоростта, оптимално е да се използва отказоустойчива схема с две реплики, но ако се приложи кеширане и журнал на SSD дисковете, то кодиране с корекция на грешки (erase coding или raid6) може да се ускори значително, особено при хибридна система или дори по-добре при all flash. С EC (erase coding) има известен недостатък: при промяна на един блок данни е необходимо да се преизчислят четностите. За да се избегнат загубите при тази операция, Ceph пише в EC отложено и проблеми с производителността могат да се появят при определено запитване, когато например са необходими да се четат всички блокове, а в случая с Virtuozzo Storage, записа на променените блокове се извършва чрез подхода “log-structured file system”, което минимизира разходите за изчисление на четност. За да се преценят приблизителни варианти за ускоряване на работата при EC и без него, има – числата могат да бъдат приблизителни в зависимост от коефициента на точност на производителя на оборудването, но резултатите от изчисленията добре помагат за планиране на конфигурацията.
Опцията за компоненти на съхранение не означава, че тези компоненти не изразходват но ако се пресметнат всички разходи предварително, може да се разчита на съвместна работа до хипервизора.
Има схема за сравнение на разходите за ресурси на хардвера от службите на Ceph и Virtuozzo storage.
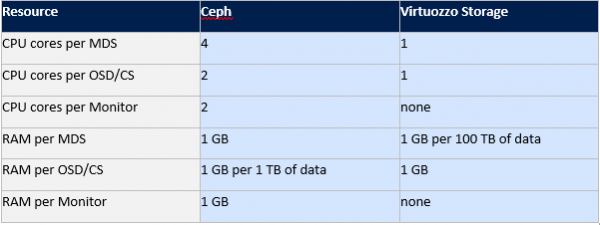
Ако преди можехме да сравняваме Gluster и Ceph, използвайки стари статии и важните редове от тях, то с Virtuozzo е по-сложно. Статиите за този продукт не са много и информацията може да се черпи само от документацията на или на руски, ако разглеждаме Vstorage като хранилище, използвано в някои хиперконвергентни решения в компании като и Акронис.
Ще се опитам да помогна с описанието на тази архитектура, затова текстът ще бъде малко по-дълъг. За да се запознаеш с документацията, обаче, е необходимо много време, а наличната документация може да се използва само като справочник чрез преглед на съдържанието или търсене по ключова дума.
Нека разгледаме процеса на запис в хибридна конфигурация на хардуера с горепосочените компоненти: записът започва на онзи узел, от който той е иницииран от клиента (услугата на точката на монтиране FUSE), но компонентът на майсторската служба за метаданни (MDS) разбира се ще насочи клиента директно към необходимата чанк услуга (услугата за съхранение на блокове CS). Тоест, MDS не участва в процеса на запис, а просто насочва към необходимата чанк услуга. В общи линии, може да се направи аналогия с разливането на вода в бъчви. Всяка бъчва е блок данни от 256 МБ.
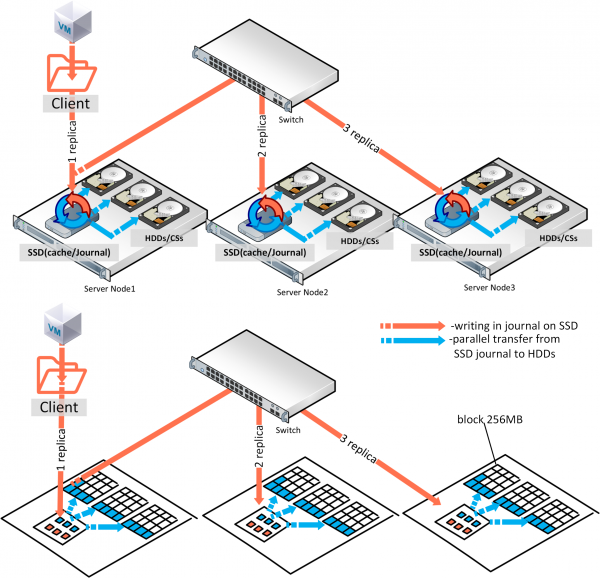
Тоест един диск е някакво количество такива бъчви, тоест обемът на диска разделен на 256 МБ. Всяка копия се разлива на един узел, втората почти паралелно на друг узел и т.н. Ако имаме три реплики и SSD дискове за кеш (под четене и записни журнали), то потвърждението на записа ще се случва след записа на журнала в SSD, а паралелният запис от SSD ще продължава на HDD, сякаш във фонова режим. В случай на три реплики, комитът на записа ще бъде след потвърждение от SSD на третия узел. Може да изглежда, че сумата на скоростта на запис на трите SSD може да бъде разделена на три и ще получим скоростта на запис на една реплика, но записването на копията протича паралелно и латентността на мрежата обикновено е по-висока от тази на SSD, така че по същество производителността на записа ще зависи от мрежата. Поради това, за да видим реалните IOPS, трябва да натоварим целия Vstorage по , т.е. да тестваме реалното натоварване, а не паметта и кеша, където е необходимо да се вземе предвид правилният размер на блока данни, броят на потоковете и т.н.
Споменатият SSD лог записва се по такъв начин, че веднага след като данните влязат в него, те се прочитат от услугата и записват на HDD. Има няколко служби за метаданни (MDS) на клъстер, а тяхното количество се определя от кворума, който работи по алгоритъма Paxos. От гледна точка на клиента, точката на присъединяване FUSE представлява папка в клъстерната съхранение, която е видима за всички вузли на клъстера, като всеки вузел има монтиран клиент по този принцип, поради което всеки вузел има достъп до това хранилище.
За производителността на всеки от описаните по-горе подходи е от съществено значение, на етапа на планиране и внедряване, правилно да се настрои мрежата, където ще се извършва балансиране чрез агрегация и подходящо подбрана пропускателна способност на мрежовия канал. При агрегацията е важно правилно да се подбере режим на хеширане и размери на фреймовете. Съществува и много силна разлика от описаните SDS, а именно fuse с технологията fast path в Virtuozzo Storage. Той, освен модернизирания fuse, в отличие от останалите open source решения, значително увеличава IOPS и позволява да не се ограничава до хоризонтално или вертикално мащабиране. В общи линии, в сравнение с описаните архитектури, тази изглежда по-мощна, но за такова удоволствие, разбира се, е нужно да се купят лицензи, за разлика от Ceph и Gluster.
В заключение можем да подчертаем три основни архитектури: първо място по производителност и надеждност заема Virtuozzo Storage, второто място е за Ceph, а третото за Gluster.
Критериите, по които е избран Virtuozzo Storage, са оптималният набор от компоненти на архитектурата, модернизираният под този подход Fuse с fast path, гъвкавото конфигуриране на хардуера, по-ниското потребление на ресурси и възможността за споделяне с compute (изчисления/виртуализация), т.е. напълно подхожда за хиперконвергентното решение, част от което е. Второто място е за Ceph, защото това е по-производителна архитектура в сравнение с Gluster, благодарение на работата с блокове, както и по-гъвкави сценарии и възможност за работа в по-мащабни клъстери.
В плановете да напиша сравнение между vSAN, Space Direct Storage, Vstorage и Nutanix Storage, тестове на Vstorage на оборудване HPE, Huawei, както и сценарии за интеграция на Vstorage с външни хардуерни СХД. Затова, ако статията ви е харесала, би било добре да получа от вас отзиви, които биха могли да усилят мотивацията ми за нови статии, отчитайки вашите коментари и желания.
Източник: habr.com
