

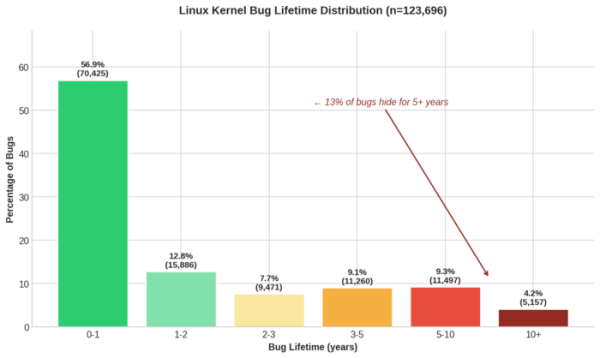
Опубликовани са резултатите от изследването на времето за откриване и отстраняване на грешки в кода на ядрото на Linux. Данните са получени от анализа на 125 хиляди грешки, обозначени в Git хранилището с етикета „Fixes:“, който препраща към комит, в който е възникнала грешката. Средното време за откриване на грешки в ядрото е 2.1 години. Когато се разглеждат само грешките, поправени през 2025 година, този показател е 2.8 години.
30% от грешките са били поправени от същите разработчици, които са ги внесли. 56.9% от грешките се отстраняват в рамките на година. 13.5% от грешките остават незабелязани повече от 5 години (когато се разглеждат само грешките, поправени през 2025 година — 19.4%). Поради неравномерното разпределение медианното време на съществуване на грешките в кода на ядрото е 8 месеца за проба от 2005 година и 1 година за грешките, поправени през 2025 година. Най-дълго съществувалата грешка в кода е презапълването на буфера в ethtool, поправено след 20.7 години.
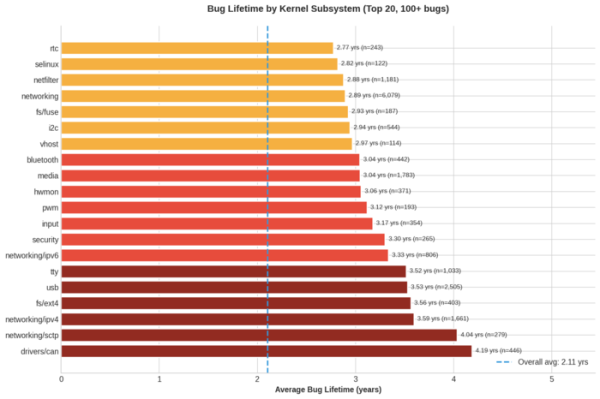
Динамиката на откритие на грешки значително се различава от средните стойности за някои подсистеми, например, в драйвера на шина CAN и стека SCTP откритията отнемат средно около 4 години, в IPv4 стека — 3.6 години, USB и TTY — 3.5, Netfilter и мрежовия стек — 2.9, VM — 1.8, GPU — 1.4, BPF — 1.1 година.
Времето за откритие корелира с типовете грешки: средното време за откритие на грешки, свързани с условия на соревнование, е 5.1 години, за цели числа — 3.9, за адреси след освобождаване на памет — 3.2, за презапълване на буфера и изтичане на памет — 3.1, за броене на референции — 2.8, за разыменоване на нулев указател и взаимно блокиране — 2.2 години.
В получената статистика също се проследява влиянието на внедряването на нови инструменти за автоматизирано откритие на грешки, статичен анализ и тестване на кода, като Syzkaller, KASAN, KMSAN и KCSAN. Например, през 2010 година не са били регистрирани поправки на грешки, открити в рамките на година. Докато през 2014 година в рамките на година са били установени 31% от грешките, през 2018 година — 54%, а през 2022 година — 69% от грешките.
Получената статистика е използвана за създаването на модел за машинно обучение VulnBERT, който позволява да се предсказва наличие на уязвимости в комитите. При тестване на комити за 2024 година, точността на откритие на грешки е била 92.2% с ниво на фалшиви сработки 1.2% (за сравнение, предишният модел CodeBERT е откривал 89.2% от проблемите с ниво на фалшиви сработки 48.1%).
Източник: opennet.ru
