

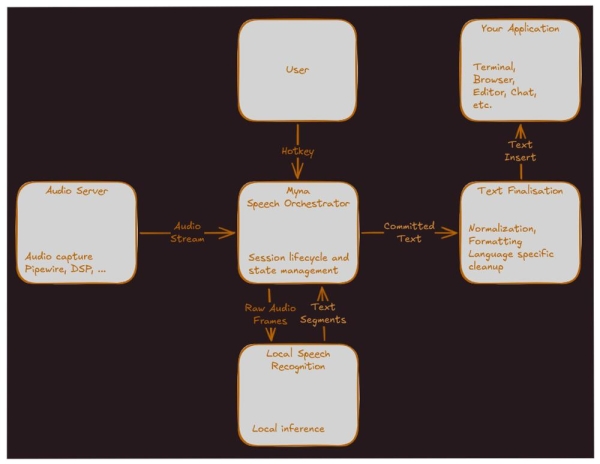
Canonical представи проект Myna — нова система за преобразуване на реч в текст за Ubuntu Desktop. Проектът е насочен към вградена диктовка: потребителят натиска горещ клавиш, говори и разпознатият текст се появява в активното приложение. В анонса се подчертава, че Myna трябва да се усеща като естествена част от работния плот на Ubuntu и в същото време да работи с оглед на личната неприкосновеност на потребителя. Списъкът с поддържани езици за въвеждане към момента на публикуване на новината не е обявен.
Първата цел на проекта е Ubuntu 26.10. На този етап Canonical не се опитва да направи пълноценен гласов асистент или система за управление на работния плот с глас. Разработчиците умишлено са ограничили обхвата на първата версия до основна, надеждна диктовка: натискате клавишна комбинация, произнасяте текст и получавате резултата в текущото поле за въвеждане. Първоначалната проверяваема среда е Ubuntu Desktop на Wayland с GNOME, но архитектурата ще бъде оставена достатъчно отворена за бъдеща поддръжка на други среди.
Myna е предназначена за локално разпознаване на реч. След инсталирането на необходимите модели интернет свързване за работа на диктовката не е необходимо, микрофонът трябва да се използва само след явно активиране от потребителя, аудио се обработва в паметта и след това се изхвърля, а записи не се изпращат на външни услуги. В проектната спецификация също е посочено, че решението трябва да избягва запазването на аудио по подразбиране и не трябва незабелязано да преминава на облачен сервис.
Кодът и документацията на Myna са публикувани в репозиторий на Canonical на GitHub. Проектът е описан като лесно приложение speech-to-text за Ubuntu Desktop и се разпространява под лиценз GPL-3.0. В същото време проектът е на ранен етап: в репозитория все още няма публикувани версии, а архитектурната спецификация е в статус Proposed.
Основни функции и характеристики на Myna
Push-to-talk диктовка. Потребителят задържа настройваем горещ клавиш, говори, а системата вмъква разпознатия текст в избраното поле за въвеждане. Диктовката приключва след отпускане на клавиша.
Локално разпознаване на реч. Разпознаването се извършва на устройството на потребителя чрез локален inference-стек. Това намалява зависимостта от облака и позволява работа без мрежа след инсталиране на моделите.
Лична обработка на аудио. Микрофонът се активира само по време на потребителската сесия за диктовка. Звукът не трябва да се записва на диска по подразбиране, използва се ограничен буфер в паметта, който се изчиства след приключване на сесията.
Визуален индикатор за активност. По време на запис и транскрибация потребителят трябва да вижда ясен индикатор за състоянието. В спецификацията се споменават състояния като Запис, Транскрибиране, Финализиране и Грешка.
Вмъкване само на стабилен текст. В първата реализация междинните хипотези на разпознаването не трябва да се вмъкват директно в приложението. В целевото поле се изпраща само потвърденият окончателен текст.
Постобработка на текста. Суровата транскрипция може да преминава през нормализация, поставяне на пунктуация, капитализация, форматиране и преобразуване на устни форми в писмени, например “двайсет и две” → “22”.
Избор на език за диктовка. Системата трябва да поддържа настраиваем език за диктовка, по подразбиране ориентирайки се към езика на потребителския интерфейс, ако за него е достъпен подходящ модел.
Профили на качеството на модела. В спецификацията са предвидени различни профили на модели: лек вариант с по-малко потребление на ресурси, балансен профил по подразбиране и по-качествен, но по-тежък вариант.
Безопасна работа с фокуса на въвеждане. Целта за вмъкване на текст се избира в началото на сесията. Ако фокусът на прозореца се променя по време на диктовка, системата не трябва мълчаливо да изпраща текста в друго приложение.
Блокиране в защитени полета. Диктовката трябва да бъде блокирана в полета за пароли, прозорци за удостоверяване и други защитени места, ако приложението или инструментариумът могат да го определят.
Интеграция с Wayland/GNOME. Първата версия е насочена към Wayland и GNOME. За първоначално вмъкване на текст се разглежда IBus, а в бъдеще се планира по-нативен подход за Wayland чрез протоколите input-method/text-input.
Настройки на потребителя. В планирания интерфейс за настройки трябва да има включване/изключване на STT, избор на горещ клавиш, език за диктовка, микрофон, профил на модел, опции за постобработка и индикатор за активност.
В първата итерация извън проекта остават пробуждането по ключова фраза, постоянното фоново слушане, облачното разпознаване, гласовият асистент, гласовите команди, управлението на работния плот, превода на реч, определянето на говорещия, автоматичното определяне на езика и историята на диктовките. С други думи, Canonical започва не с „AI асистента“, а с по-приземена функция: локален гласов вход на текст в обикновени приложения на Ubuntu.
Източник: linux.org.ru
