

Компания Google обяви, че открива кода на проекта Magika, предназначен за определяне на типа съдържание въз основа на анализа на наличните в файла данни. Magika може точно да определя програмните езици, методите за компресия, инсталационните пакети, изпълняемия код, видовете маркировка, формати на звука, видеото, документите и изображенията, използвани в съдържанието. Свързаните с проекта инструменти и готов модел на машинно обучение са публикувани под лиценз Apache 2.0.
Magika се отличава от подобни проекти, които определят MIME типа по съдържание, с използването на методи на машинно обучение, висока производителност и отлична точност на определяне. Моделът е обучен с използването на рамката Keras на 25 милиона примера и поддържа разпознаване на 116 типа данни с точност не по-малка от 99%. Моделът е компилиран в ONNX формат и е с размер само 1 MB. Използването на методи на дълбочинно машинно обучение позволи 50% повишение на точността на определяне в сравнение с предходната система на Google, основана на ръчно зададени правила.
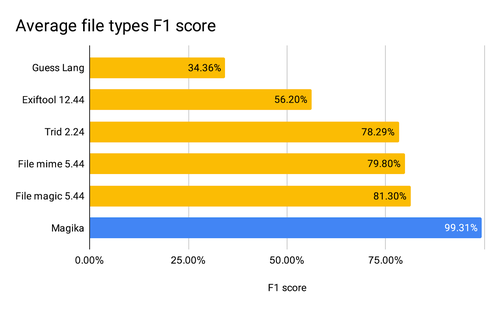
В Google системата се използва за класифициране на файлове в услугите Gmail, Drive, Code Insight и Safe Browsing при извършване на проверки за сигурност и съответствие с правилата на услугите. Работи се по интегрирането на Magika в платформата VirusTotal като звено за първична филтрация на файловете преди извършване на специфични анализатори. Разположената в инфраструктурата на Google конфигурация на Magika осигурява сканиране на милиони файлове в секунда и стотици милиарди файлове на седмица. След зареждане на модела времето за генериране на изхода е 5-6 ms при тестове на едно ядро на CPU. Времето за определяне почти не зависи от размера на файла.
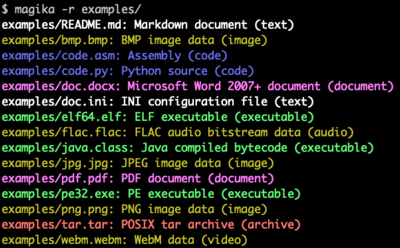
За използване на Magika в своите проекти са подготвени инструмента за команден ред, пакет за Python и JavaScript библиотека, която може да работи в браузъра или в проекти, базирани на Node.js. Интерфейсът на командния ред и API поддържат извършването на операции в пакетен режим, т.е. позволяват проверка на няколко файла с едно запитване. Има режим за рекурсивно сканиране на съдържанието на целия каталог и три режима за прогнозиране, за да се настрои устойчивостта към грешки (висока увереност, средна увереност и най-добра догадка).
Източник: opennet.ru
