

Научноизследователската работа е вероятно най-интересната част от обучението ни. Идеята е още в университета да опитате да се занимавате в избраната посока. Например, студентите по специалностите Software Engineering и Machine Learning често участват в НИРи в компании (главно, JetBrains или Яндекс, но не само).
В този пост ще разкажа за проекта си в областта на компютърните науки. В рамките на работата си изучих и реализирах на практика подходи за решение на една от най-известните NP-трудни задачи: задачата за върхово покритие.
Сега много бързо се развива интересен подход към NP-трудните задачи — параметризирани алгоритми. Ще се опитам да ви въведа в тази материя, да ви разкажа за няколко прости параметризирани алгоритми и да опиша един мощен метод, който много ми помогна. Резултатите си представих на състезанието PACE Challenge: след отворените тестове, моето решение заема трето място, а окончателните резултати ще бъдат известни на 1 юли.
За мен
Казвам се Василий Алфьоров, в момента завършвам третата година в НИУ ВШЕ — Санкт Петербург. Интересувам се от алгоритми от ученическите си години, когато учех в московската 179-та гимназия и успешно участвах в олимпиади по информатика.
Ограничен брой специалисти по параметризирани алгоритми влизат в бара...
Примерът е взет от книгата
Представете си, че сте охранител в бар в малък град. Всеки петък половината от града идва във вашия бар, за да се отпусне, което ви създава доста проблеми: трябва да изгоните буйните клиенти, за да предотвратите сбивания. В крайна сметка, това ви омръзва и решавате да предприемете превантивни мерки.
Тъй като градът ви е малък, вие точно знаете кои двойки клиенти с голяма вероятност ще се сбият, ако се срещнат в бара. Имате списък от n хора, които ще дойдат тази вечер в бара. Решавате да не пуснете в бара някои от градските жители по начин, така че никой да не се сбие. В същото време вашето началство не иска да губи печалба и ще бъде недоволно, ако не пуснете в бара повече от k хора.
За съжаление, задачата, пред която сте изправени, е класическа NP-трудна задача. Може би я знаете като , или как задача за покритие на върховете. За такива задачи, в общия случай, не са известни алгоритми, работещи в приемливо време. Ако трябва да бъдем точни, недоказаната и доста силна хипотеза ETH (Хипотеза за експоненциално време) твърди, че тази задача не може да бъде решена за време  , т.е. че очевидно по-добро от пълния пермутаций не може да бъде измислено. Например, да кажем, че в бара ви идват n = 1000 човека. Тогава пълният пермутаций ще е
 варианта, което е приблизително
 — безумно много. За щастие, вашето ръководство е наложило ограничение k = 10, така че броят комбинации, които трябва да прегледате, е много по-малък: броят на подмножества от десет елемента е
 . Това вече е по-добре, но все пак няма да може да се преброи за ден дори на мощен клъстер.
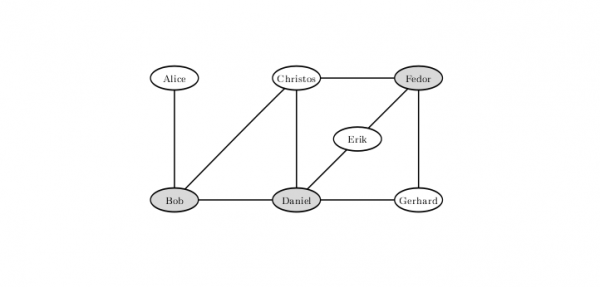
За да се елиминира вероятността от сблъсък в такава конфигурация на напрегнати отношения между посетителите на бара, трябва да не бъде допуснат Боб, Даниел и Фьодор. Решение, при което извън остава само двама, не съществува.
Значи ли това, че е време да се откажем и да пуснем всички? Нека разгледаме други варианти. Например, можете да не пускате само тези, които вероятно ще се сбият с много хора. Ако някой може да се сбие поне с k + 1 друг човек, то той определено не може да бъде пуснат — иначе ще се наложи да не пуснете всички k + 1 граждани, с които той може да се сбие, което вече със сигурност ще разстрои ръководството.
Нека предположим, че сте изчистили всички, които можехте, по този принцип. Тогава всички останали могат да се сбият с не повече от k хора. Изчиствайки от тях k човека, можете да предотвратите не повече от  конфликта. Значи, ако има повече от
 човека, участващи поне в един конфликт, то определено не можете да предотвратите всички. Тъй като, очевидно, напълно неконфликтните хора ще бъдат пуснати, ще трябва да прегледате всички подмножества с размер десет от двеста души. Те са приблизително
 , а такова количество операции вече може да бъде прегледано на клъстера.
Ако можем безопасно да допуснем напълно невзлядни личности, какво можем да кажем за тези, които участват само в един конфликт? Всъщност, и те могат да бъдат допуснати, ако затворим вратата пред техния опонент. Наистина, ако Алиса конфликтира само с Боб, то ако допуснем Алиса от двамата, няма да загубим: Боб може да има и други конфликти, а Алиса определено няма. Освен това е безсмислено да не допускаме и двамата. След такива операции остава не повече  гости с неразрешена съдба: общо имаме
 конфликта, в който всеки има по двама участници и всеки участва поне в два. Значи, остава да преминем през
 варианта, което напълно може да се сметне за половин ден на лаптоп.
Всъщност, с простички разсъждения можем да постигнем още по-привлекателни условия. Нека да отбележим, че трябва непременно да разрешим всички спорове, т.е. от всяка конфликтуваща двойка да изберем поне един човек, когото няма да допуснем. Нека разгледаме такъв алгоритъм: ще вземем произволен конфликт, от който ще премахнем един участник и рекурсивно ще стартираме от остатъка, след това ще премахнем другия и също рекурсивно ще стартираме. Понеже на всяка стъпка изхвърляме някого, дървото на рекурсията на този алгоритъм е бинарно дърво с дълбочина k, така че сборният алгоритъм работи за  , където n — брой върхове, а m — брой ръбове. В нашия пример това е около десет милиона, което за части от секундата може да се сметне не само на лаптоп, но дори и на мобилен телефон.
Примерът по-горе е пример на параметриран алгоритъм. Параметрираните алгоритми са алгоритми, които работят за време f(k) poly(n), където p — полином, f — произволна изчисляема функция, а k — някакъв параметър, който е напълно възможно да бъде много по-малък от размера на задачата.
Всички разсъждения до този алгоритъм дават пример кернелизация — една от общите техники за създаване на параметризирани алгоритми. Кернализацията е намаляване на размера на задачата до стойност, ограничена от функция на параметъра. Получената задача често се нарича ядро. По този начин, с простите разсъждения относно степените на върховете, получихме квадратично ядро за задачата Vertex Cover, параметризирана по размер на отговора. Съществуват и други параметри, които могат да бъдат избрани за тази задача (например, Vertex Cover Above LP), но ще обсъдим именно този параметър.
Pace Challenge
Соревнование (The Parameterized Algorithms and Computational Experiments Challenge) стартира през 2015 г., за да установи връзка между параметризираните алгоритми и подходите, използвани на практика за решаване на изчислителни задачи. Първите три състезания бяха посветени на търсенето на дървесна ширина на графа (), търсенето на дърво на Штейнер () и търсенето на множество върхове, разрязващи цикли (). Тази година една от задачите, в които участниците можеха да опитат силите си, беше описаната по-горе задача за върховното покритие.
Състезанието набира популярност с всяка изминала година. Според предварителните данни, само в състезанието за решаване на задачата за върховно покритие участваха 24 отбора. Следва да се отбележи, че състезанието продължава не само няколко часа и дори не седмица, а няколко месеца. Отборите имат възможност да изучат литературата, да измислят оригиналната си идея и да се опитат да я реализират. По същество, това състезание представлява изследователска работа. Идеите за най-ефективни решения и награждаването на победителите ще се проведат заедно с конференцията (International Symposium on Parameterized and Exact Computation) в рамките на най-голямото ежегодно алгоритмично събрание в Европа . По-подробна информация за самото състезание може да бъде намерена на , а резултатите от предходните години са достъпни .
Схема решение
За да се справя със задачата за върховно покритие, опитах да приложа параметризирани алгоритми. Те обикновено се състоят от две части: правила за опростяване (които в идеален случай водят до кернелизация) и правила за разцепване. Правилата за опростяване са предварителна обработка на входа за полиномиално време. Целта на прилагането на такива правила е да се сведе задачата до еквивалентна задача с по-малък размер. Правилата за опростяване са най-скъпата част от алгоритъма, и прилагането на точно тази част води до общо време на работа  вместо простото полиномиално време. В нашия случай правилата за разцепване се основават на това, че за всяка връх трябва да вземем в отговор или него, или неговия съсед.
Общата схема е следната: прилагаме правилата за опростяване, след това избираме някакъв връх и правим два рекурсивни извиквания: в първото вземаме него в отговор, а в другото вземаме всички негови съседи. Това наричаме да се разцепим (бранчим) по този връх.
В тази схема ще бъде внесено точно едно допълнение в следващия параграф.
Идеи за правила за разцепване (бранчинг)
Нека обсъдим как да изберем върха, по който ще се извършва разцепването.
Основната идея е много алчна в алгоритмичен смисъл: нека вземем върха с максимална степен и да се разцепим точно по него. Защо изглежда, че така е по-добре? Защото във второто извикване на рекурсията по този начин ще премахнем много върхове. Може да се очаква, че ще остане малък граф и на него ще работим бързо.
Този подход с вече обсъдените прости техники за кернелизация се представя доста добре, решава някои тестове с размери от няколко хиляди върха. Но, например, работи слабо за кубични графове (т.е. графове, чиято степен на всеки връх е три).
Има и друга идея, основана на достатъчно проста мисъл: ако графът е несвързан, задачата за неговите компоненти на свързаност може да се решава независимо, обединявайки отговорите в крайна сметка. Това, между другото, е малката обещана модификация в схемата, която значително ще ускори решението: по-рано в такъв случай работехме за произведението на времената за изчисляване на отговорите на компонентите, а сега работим за сумата. А за да се ускори бранчинга, е необходимо да се превърне свързания граф в несвързан.
Как да го направите? Ако в графа има връзка, трябва да се клонира точно на нея. Връзката е такава връхна точка, при премахването на която графът губи свързаност. Можете да намерите всички връзки в графа с класически алгоритъм за линейно време. Този подход значително ускорява клонирането.
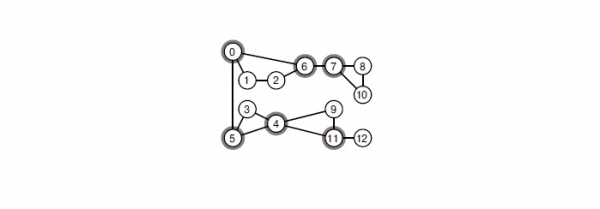
При премахването на която и да е от выделените върхове, графът ще се разпадне на компоненти на свързаност.
Това ще направим, но искам повече. Например, да търсим в графа малки разрези на върхове и да извършим разделяне по върховете от тях. Най-ефективният известен ми начин за намиране на минимален глобален разрез на върхове е да се използва дърво на Гомори-Ху, което се изгражда за кубично време. В PACE Challenge типичният размер на графа е няколко хиляди върхове. При такова положение в всяка върхова точка на рекурсивното дърво трябва да се извършат милиарди операции. Оказва се, че решаването на задачата в отреденото време е просто невъзможно.
Нека се опитаме да оптимизираме решението. Минималният разрез на върховете между двойка върхове може да бъде намерен с всеки алгоритъм, строящ максимален поток. Можем да приложим такъв алгоритъм , на практика работи много бързо. Имам подозрение, че теоретично може да се докаже оценка за времето на работа  , което вече е напълно приемливо.
Опитах се няколко пъти да търся разрези между двойки случайни върхове и да вземам най-сбалансирания. За съжаление, на отворените тестове на PACE Challenge това даде лоши резултати. Сравнявах с алгоритъм, клониращ се по върховете на максималната степен, стартирайки ги с ограничение на дълбочината на спускане. След алгоритъма, който се опитва да намери разрез по този начин, оставаха графи с по-голям размер. Това се дължи на факта, че разрезите бяха много несбалансирани: премахвайки 5-10 върхове, можеше да се отнемат само 15-20.
Следва да се отбележи, че в статиите за теоретично най-бързите алгоритми се използват много по-напреднали техники за избор на върхове за разделяне. Тези техники имат много сложна реализация и често лоши оценки за време и памет. Не успях да отделя от тях напълно приемливи за практиката.
Как да приложим правилата за опростяване
Вече имаме идеи за_KERNELизация. Напомням:
- Ако има изолирана върхова точка, премахнете я.
- Ако съществува връх с размер 1, изтрий го и вземи съседа му за отговор.
- Ако има връх с размер поне k + 1, вземи го за отговор.
С първите два е ясно, но с третия има една хитрост. Ако в шеговитата задача за бара получихме горно ограничение за k, то в PACE Challenge просто трябва да намерим минимално покритие на върховете. Това е типично преобразуване на проблеми за търсене (Search Problem) в проблеми за решение (Decision Problem), често между двата вида проблеми не правят разлика. На практика, ако пишем решавател за проблема с покрития на върховете, разликата може да бъде.
От гледна точка на реализацията, могат да се направят два подхода. Първият подход се нарича Iterative Deepening. Той се състои в следното: можем да започнем с някакво разумно долно ограничение за отговора и след това да стартираме нашия алгоритъм, използвайки това ограничение като горно ограничение за отговора, без да слизаме по рекурсията по-дълбоко от това ограничение. Ако намерим някакъв отговор, той е гарантирано оптимален, в противен случай можем да увеличим това ограничение с единица и да стартираме отново.
Другият подход е да се запази някакъв текущ оптимален отговор и да се търси отговор с по-малък размер, при откритие променяйки този параметър k за повече отсичане на излишни клони в търсенето.
Проведох няколко нощни експеримента и се спрях на комбинация от тези два подхода: първо, стартирам алгоритъма си с някакво ограничение на дълбочината на търсенето (подбирайки я така, че да отнеме микроскопично време в сравнение с основното решение) и използвам най-доброто намерено решение като горно ограничение за отговора — тоест на онова k.
Върхове с размер 2
С върховете с размер 0 и 1 се справихме. Оказва се, че е възможно да направим това и с върховете с размер 2, но за това графът ще изисква по-сложни операции.
За да го обясня, трябва някак да обозначим върховете. Нека наречем върха с размер 2 'връх' v, а съседите му — върхове x и y. След това имаме два случая.
- Когато x и y — съседи. Тогава можем да вземем за отговор x и y, а v изтривам. И наистина, от този триъгълник е необходимо да вземем поне два върха за отговор и със сигурност няма да загубим, ако вземем x и y: вероятно имат още съседи, а v те нямат.
- Когато x и y — не съ съседи. Тогава се твърди, че всички три върха могат да се слеят в един. Идеята е, че в такъв случай има оптимален отговор, в който взимаме или v, или и двата върха x и y. Като в първия случай ще трябва да вземем всички съседи x и y, а във втория не е задължително. Това точно съответства на случаите, когато не взимаме слетия връх в отговора и когато го взимаме. Остава само да се отбележи, че в двата случая отговорът от такава операция намалява с единица.
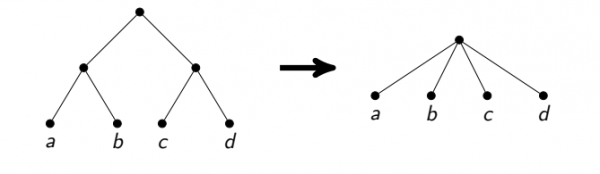
Струва си да се отбележи, че такъв подход за честно линейно време е доста трудно да се реализира точно. Сливането на върхове е сложна операция, трябва да се копират списъците на съседите. Ако това не се направи внимателно, може да се получи асимптотично неоптимално време на работа (например, ако след всяко сливане копирате много ребра). Аз се съсредоточих върху намирането на цели пътища от върхове с ниво 2 и разглеждането на купчина частни случаи, като цикли от такива върхове или от всички такива върхове освен един.
Освен това, трябва да се уверим, че тази операция е обратима, за да можем по време на завръщането от рекурсията да възстановим графа в първоначалния му вид. За да осигурим това, не изтрих списъците на ребрата на слетите върхове, след което просто знаех какви ребрата трябва да се насочат. Такава реализация на графите също изисква внимателност, но осигурява честно линейно време. А за графи с десетки хиляди ребра това спокойно попада в кеша на процесора, което дава големи предимства в скоростта.
Линейно ядро
Накрая, най-интересната част от ядрото.
В началото да си припомним, че в двудолни графи минималното покритие на върховете може да се търси за  . За целта трябва да се използва алгоритъм за да се намери максималното паросочетание, а след това да се използва теоремата .
Идеята на линейното ядро е следната: първо ще раздвоим графа, т.е. вместо всеки връх v ще заведем два върха  и
 , а вместо всяко ребро u — v ще заведем две ребра
 и
 . Полученият граф ще бъде двудолен. Нека намерим минималното върхово покритие в него. Някои върхове от изходния граф ще попаднат там два пъти, някои само веднъж, а някои — никога. Теоремата на Нехауер-Тротер заявява, че в този случай можем да премахнем върховете, които не попадат никъде, и да вземем в отговор тези, които попадаха два пъти. Освен това, тя казва, че от оставащите върхове (тези, които попадат веднъж) трябва да вземем в отговор поне половината.
Току-що научихме, че можем да оставим в графа не повече от 2k върха. И наистина, ако в остатъка отговора — поне половината от всички върхове, то има не повече от 2k.
Тук успях да направя малка крачка напред. Ясно е, че построеното по този начин ядро зависи от това, кое точно минимално върхово покритие в двудолния граф сме избрали. Иска ми се да взема такова, че броят на оставащите върхове да бъде минимален. Преди това умели да го правят само за време  . Аз обаче измислих реализация на този алгоритъм за време
 , по този начин това ядро може да се търси в графи с хиляди върхове на всеки етап от клоненето.
Резултат
Практиката показва, че моето решение работи добре на тестове с няколко стотин върха и няколко хиляди ребра. На такива тестове е напълно вероятно решението да бъде намерено за половин час. Вероятността да се намери отговор за приемливо време в принцип нараства, ако в графа има достатъчно много върхове с голяма степен, например степен 10 и нагоре.
За участие в състезанието решенията трябваше да се изпратят на . Изглежда, според представената там , моето решение за отворени тестове заема трето място от двадесет с голямо предимство пред второто. Ако бъда напълно честен, не е ясно как ще се оценяват решенията на самото състезание: например, моето решение минава по-малко тестове от това на четвърто място, но на тези, които минава, работи по-бързо.
Резултатите на закритите тестове ще бъдат известни на първи юли.
Източник: habr.com
